
Bài viết này nói về hai thứ mà tôi cho là thú vị nhất trên đời: cấu trúc dữ liệu xác suất và module Redis. Nếu bạn đã nghe về một trong hai, chắc hẳn bạn đồng cảm với sự hào hứng của tôi, nhưng nếu muốn cập nhật những điều "cool" nhất, hãy tiếp tục đọc.
Khẳng định: xử lý dữ liệu quy mô lớn với độ trễ thấp là thách thức. Khối lượng và tốc độ dữ liệu có thể khiến phân tích thời gian thực trở nên cực kỳ khắt khe. Nhờ hiệu năng cao và tính linh hoạt, Redis thường được dùng giải quyết thách thức này. Khả năng lưu trữ, thao tác và phục vụ nhiều dạng dữ liệu với độ trễ dưới mili-giây khiến Redis trở thành container dữ liệu lý tưởng cho nhiều trường hợp cần tính toán trực tuyến.
Nhưng mọi thứ đều tương đối, tồn tại những quy mô cực đoan khiến phân tích thời gian thực chính xác trở nên không thể thực hiện. Vấn đề phức tạp càng lớn càng khó, nhưng chúng ta thường quên rằng vấn đề đơn giản cũng tuân theo quy tắc đó. Ngay cả việc cộng số cũng thành bài toán khổng lồ khi dữ liệu quá lớn, quá nhanh hoặc thiếu tài nguyên xử lý. Tài nguyên luôn hữu hạn và đắt đỏ, dữ liệu lại tăng liên tục.
Count-Min Sketch là gì?
Count-Min Sketch (CM Sketch) là cấu trúc dữ liệu xác suất cực kỳ hữu ích khi bạn nắm cách hoạt động và quan trọng hơn là cách sử dụng.
May mắn là đặc điểm đơn giản của CM Sketch khiến người mới dễ hiểu (nhiều bạn bè tôi không theo kịp bài blog Top-K).
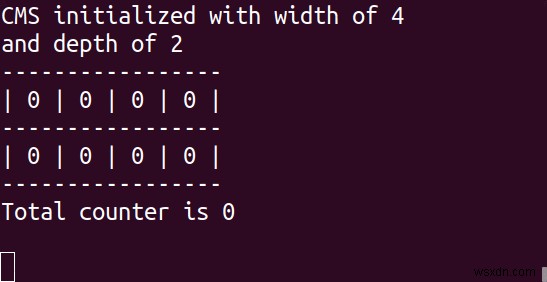
CM Sketch đã là module Redis nhiều năm và gần đây được viết lại như một phần của module RedisBloom v2.0. Trước khi đi sâu, cần hiểu tại sao dùng bất kỳ cấu trúc dữ liệu xác suất. Trong tam giác tốc độ, không gian và độ chính xác, cấu trúc xác suất hy sinh một phần độ chính xác để đổi lấy không gian — có thể là rất nhiều không gian! Tác động đến tốc độ thay đổi tùy thuật toán và kích thước tập dữ liệu.
- Độ chính xác: Theo định nghĩa, chỉ giữ một phần dữ liệu và cho phép va chạm khi lưu trữ làm giảm độ chính xác. Tuy nhiên bạn có thể đặt tỷ lệ lỗi tối đa theo trường hợp sử dụng.
- Không gian bộ nhớ: Trong thế giới big data với hàng tỷ sự kiện ghi nhận, chỉ lưu dữ liệu một phần làm giảm đáng kể yêu cầu lưu trữ và chi phí.
- Tốc độ: Cấu trúc truyền thống vận hành kém hiệu quả, làm chậm phản hồi. (Ví dụ: Sorted Set duy trì thứ tự tất cả phần tử, nhưng bạn chỉ quan tâm top elements. Vì thuật toán xác suất chỉ duy trì danh sách một phần, chúng hiệu quả hơn và thường trả lời truy vấn nhanh hơn.)
Cấu trúc dữ liệu xác suất phù hợp cho phép chỉ giữ một phần thông tin trong dataset để đổi lấy độ chính xác giảm. Tất nhiên, nhiều trường hợp (như tài khoản ngân hàng) độ chính xác giảm không chấp nhận được. Nhưng cho gợi ý phim hoặc hiển thị quảng cáo, chi phí của lỗi hiếm gặp thấp và tiết kiệm không gian có thể lớn.
Về cơ bản, CM Sketch hoạt động bằng cách tổng hợp số lượng xuất hiện của tất cả item trong dataset vào nhiều mảng bộ đếm. Khi truy vấn, trả về số đếm nhỏ nhất của tất cả mảng, giúp giảm thiểu việc tăng count do va chạm. Item xuất hiện ít ("mouse flows") có count dưới tỷ lệ lỗi, mất dữ liệu count thực và bị coi là nhiễu. Item xuất hiện nhiều ("elephant flows") dùng count nhận được. Vì kích thước CM Sketch không đổi và dùng cho vô hạn item, tiềm năng tiết kiệm lưu trữ khổng lồ.
Đối với bối cảnh, sketch là lớp cấu trúc dữ liệu và thuật toán đi kèm. Chúng nắm bắt bản chất dữ liệu để trả lời câu hỏi về nó trong khi dùng không gian hằng số hoặc dưới tuyến tính. CM Sketch được Graham Cormode và S. Muthu Muthukrishnan mô tả trong bài báo 2005 "An Improved Data Stream Summary: The Count-Min Sketch and its Applications".
Count-Min Sketch: Cái gì và như thế nào
CM Sketch dùng nhiều mảng bộ đếm cho các trường hợp sử dụng chính. Gọi số mảng là "depth" (độ sâu) và số bộ đếm mỗi mảng là "width" (độ rộng).
Mỗi khi nhận item, dùng hàm hash (chuyển element — từ, câu, số, nhị phân — thành số dùng làm vị trí trong mảng hoặc vân tay) tính vị trí item và tăng bộ đếm đó cho mỗi mảng. Mỗi bộ đếm liên quan có giá trị bằng hoặc lớn hơn giá trị thực của item. Khi truy vấn, duyệt qua tất cả mảng với cùng hàm hash và lấy bộ đếm liên quan đến item. Trả về giá trị nhỏ nhất gặp được vì biết giá trị bị phồng (hoặc bằng).
Dù biết nhiều item đóng góp vào hầu hết bộ đếm do va chạm tự nhiên (item khác nhau nhận cùng vị trí), chúng ta chấp nhận "nhiễu" miễn là nằm trong tỷ lệ lỗi mong muốn.
Ví dụ Count-Min Sketch
Toán toán quy định: depth 10, width 2000 → xác suất không lỗi 99.9%, tỷ lệ lỗi 0.1% (phần trăm tổng số lần tăng, không phải item duy nhất).
Số thực: thêm 1 triệu item duy nhất, trung bình mỗi item nhận giá trị 500 (1M/2K). Tuy có vẻ chênh lệch, nhưng nằm trong tỷ lệ lỗi 0.1% (1000 trên 1 triệu).
Tương tự, 10 "elephant" xuất hiện 10.000 lần mỗi cái, giá trị trên tất cả mảng ≥ 10.000. Khi đếm sau này, ta thấy "elephant". Với các số khác (tức "mouse" count thực = 1), chúng khônglikely va chạm với elephant trên tất cả mảng (vì CM Sketch chỉ lấy count nhỏ nhất) vì xác suất mỏng và giảm thêm nếu tăng depth khi khởi tạo.
Count-Min Sketch dùng làm gì?
Hiểu hành vi CM Sketch, ta làm gì với "con quái" nhỏ này? Một số trường hợp phổ biến:
- Truy vấn hai số và so sánh count của chúng.
- Đặt ngưỡng phần trăm item đến, ví dụ 1%. Khi min-count của item lớn hơn 1% tổng count, trả về true. Dùng xác định top player game online.
- Thêm min-heap vào CM Sketch tạo cấu trúc Top-K. Khi tăng item, kiểm tra min-count mới có lớn hơn min trong heap và cập nhật. Khác với module Top-K trong RedisBloom (dùng HeavyKeeper giảm dần theo thời gian), CM Sketch không bao giờ quên, hành vi khác một chút.
Trong RedisBloom, API CM Sketch đơn giản:
- Khởi tạo: INITBYDIM {key} {width} {depth} hoặc CMS.INITBYPROB {key} {error} {probability}
- Tăng bộ đếm item: CMS.INCRBY {key} {item} {increment}
- Lấy min count: CMS.QUERY {key} {item}
Các lệnh tạo ví dụ hoạt hình ở đầu bài:
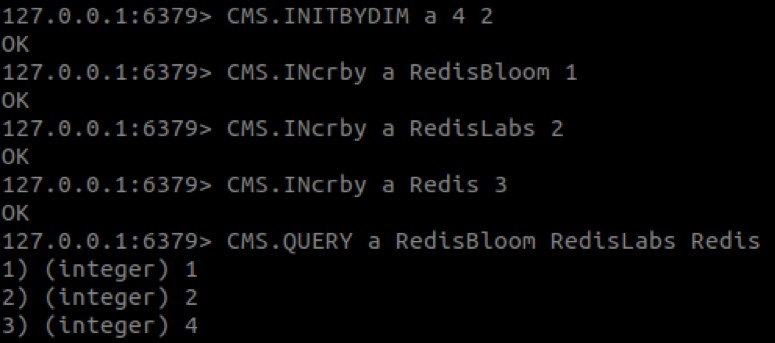
Nhận thấy giá trị 'Redis' là 4 thay vì 3. Hành vi dự kiến vì trong CM Sketch count item thường bị phồng.
Kinh doanh "sketchy"
Kỹ thuật phần mềm là làm trade-off, cách phổ biến giải quyết thách thức hiệu quả chi phí là hy sinh độ chính xác đổi hiệu quả. Cách này minh họa bằng HyperLogLog của Redis — cấu trúc dữ liệu thiết kế trả lời truy vấn về cardinality của tập hợp hiệu quả. HyperLogLog thuộc họ "sketch" — như tác phẩm nghệ thuật grassroots, truyền đạt thông tin qua xấp xỉ đối tượng.
Lưu ý: sketch là cấu trúc dữ liệu (và thuật toán) nắm bắt bản chất dữ liệu — câu trả lời cho câu hỏi về dữ liệu, mà không lưu dữ liệu chính nó. Thông thường, sketch hữu ích vì độ phức tạp tính toán tiệm cận dưới tuyến tính, cần ít sức mạnh tính toán và/hoặc lưu trữ. Không có bữa trưa miễn phí, hiệu quả bù bằng độ chính xác câu trả lời. Nhiều trường hợp lỗi chấp nhận được miễn dưới ngưỡng. Sketch tốt là cái công nhận lỗi, thậm chí tham số hóa lỗi (hoặc xác suất lỗi) để người dùng định nghĩa.
Sketch tốt hiệu quả và có xác suất lỗi bị chặn, nhưng sketch xuất sắc là có thể tính toán song song. Sketch song song là cái có thể chuẩn bị độc lập trên các phần dữ liệu và cho phép kết hợp các phần thành tổng hợp có nghĩa và nhất quán. Vì mỗi phần sketch xuất sắc có thể tính tại vị trí/thời điểm khác nhau, song song hóa cho phép chia để trị thách thức mở rộng.
Một vấn đề thường gặp
HyperLogLog là sketch xuất sắc nhưng chỉ trả lời loại câu hỏi cụ thể. Công cụ quý giá khác là Count Min Sketch (CMS), mô tả trong bài báo "An Improved Data Stream Summary: The Count-Min Sketch and its Applications" của G. Cormode và S. Muthukrishnan. Thiết kế thông minh này trả lời tần suất mẫu — khối xây dựng phổ biến trong nhiều quy trình phân tích.
Cho đủ thời gian và tài nguyên, tính tần suất mẫu đơn giản — chỉ đếm quan sát (số lần thấy) cho mỗi mẫu (điều thấy) và chia cho tổng quan sát để được tần suất mẫu. Tuy nhiên, bối cảnh xử lý dữ liệu quy mô lớn độ trễ thấp, không bao giờ đủ thời gian/tài nguyên. Câu trả lời phải tức thì khi dữ liệu stream đến, bất kể quy mô, và không gian lấy mẫu khổng lồ làm không thể giữ bộ đếm cho mỗi mẫu.
Thay vì theo dõi chính xác mỗi mẫu, ta ước lượng tần suất. Cách một: lấy mẫu ngẫu nhiên quan sát và hy vọng mẫu phản ánh đặc tính tổng thể. Vấn đề: đảm bảo ngẫu nhiên thực sự khó, thành công bị giới hạn bởi quá trình chọn và/hoặc đặc tính dữ liệu. CMS xuất hiện với cách tiếp cận khác biệt đến mức ngược với sketch xuất sắc: không chỉ ghi nhận mọi quan sát, mỗi quan sát ghi trong nhiều bộ đếm!
Tất nhiên có "twist", khéo léo như đơn giản. Bài báo gốc (và bản nhẹ "Approximating Data with the Count-Min Data Structure") giải thích tốt, tôi tóm tắt. Khéo léo của CMS là cách lưu mẫu: thay vì theo dõi từng mẫu duy nhất, dùng giá trị hash. Giá trị hash mẫu dùng làm chỉ số vào mảng bộ đếm kích thước hằng số (tham số d). Bằng cách dùng w hàm hash khác nhau và mảng tương ứng, sketch xử lý va chạm hash khi truy vấn bằng cách chọn giá trị nhỏ nhất trong tất cả bộ đếm liên quan cho mẫu.
Cần ví dụ, hãy làm sketch đơn giản minh họa hoạt động bên trong. Để đơn giản, dùng tham số nhỏ. w = 3 (ba hàm hash h1, h2, h3), d = 4. Dùng mảng 3×4 (12 phần tử) khởi tạo 0.
Xem gì xảy ra khi thêm mẫu. Giả sử mẫu đến lần lượt, hash cho mẫu đầu s1: h1(s1)=1, h2(s1)=2, h3(s1)=3. Ghi s1 bằng cách tăng bộ đếm mỗi hàm hash tại chỉ số liên quan 1. Bảng trạng thái ban đầu và hiện tại:
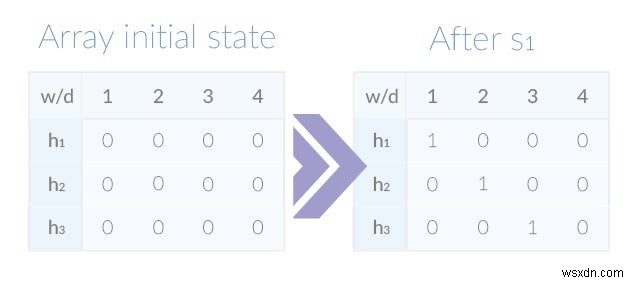
Dù chỉ một mẫu, đã truy vấn hiệu quả. Số quan sát cho mẫu là min của tất cả bộ đếm, cho s1:
min(array[1][h₁(s₁)], array[2][h₂(s₁)], array[3][h₃(s₁)]) =
min(array[1][1], array[2][2], array[3][3]) =
min(1,1,1) = 1
Sketch cũng trả lời truy vấn mẫu chưa thêm. Giả sử h₁(s₂)=4, h₂(s₂)=4, h₃(s₂)=4, truy vấn s₂ trả về 0. Tiếp tục thêm s₂ và s₃ (h₁(s₃)=1, h₂(s₃)=1, h₃(s₃)=1):
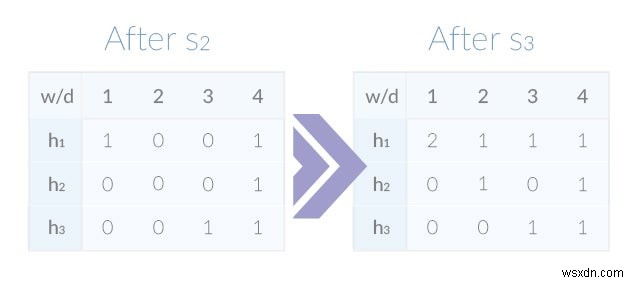
Trong ví dụ tạo sẵn, hầu hết hash mẫu ánh xạ đến bộ đếm duy nhất, trừ va chạm h1(s1) và h1(s3). Cùng hash nên bộ đếm 1 của h1 giờ giá trị 2. Vì sketch lấy min, truy vấn s1 và s3 vẫn đúng 1. Cuối cùng, sau đủ va chạm, kết quả truy vấn kém chính xác hơn.
Hai tham số CMS — w và d — quyết định yêu cầu không gian/thời gian cũng như xác suất và giá trị tối đa lỗi. Cách trực quan hơn khởi tạo sketch: cung cấp xác suất và giới hạn lỗi, để nó suy ra w và d. Song song hóa có thể vì bất kỳ sub-sketch nào có thể merge trivia là tổng mảng, miễn dùng cùng tham số và hàm hash.
Một vài quan sát về Count-Min Sketch
Hiệu quả CMS thể hiện qua yêu cầu. Độ phức tạp không gian CMS là tích w, d và độ rộng bộ đếm. Ví dụ: sketch tỷ lệ lỗi 0.01% tại xác suất 0.01% dùng 10 hàm hash và mảng 2000 bộ đếm. Giả dùng bộ đếm 16-bit, bộ nhớ tổng sketch ~40KB (vài byte thêm cho tổng quan sát và con trỏ). Khía cạnh tính toán cũng dễ chịu — hàm hash rẻ để tạo và tính, truy cập cấu trúc dữ liệu (đọc/ghi) cũng thời gian hằng số.
CMS còn hơn thế; tác giả chỉ cách dùng cho câu hỏi tương tự: ước lượng phần trăm và xác định heavy hitters (item thường xuất hiện) — ngoài phạm vi bài này.
CMS chắc chắn sketch xuất sắc, nhưng có ít nhất hai điều ngăn nó hoàn hảo. Lo ngại đầu: CMS có thể bị chệch (biased), ước lượng quá cao tần suất mẫu với ít quan sát. Chệch CMS nổi tiếng, nhiều cải tiến được đề xuất. Gần nhất Count Min Log Sketch ("Approximately counting with approximate counters" của G. Pitel và G. Fouquier), thay thanh ghi tuyến tính bằng logarit để giảm lỗi tương đối và cho count cao hơn mà không tăng độ rộng thanh ghi.
Lo ngại thứ hai dành riêng cộng đồng Redis. Để giải thích, phải giới thiệu Redis Modules.
Redis Module
Redis Modules ra mắt năm nay tại RedisConf bởi antirez và đã lật ngược thế giới chúng ta. Chỉ là thư viện động tải vào server, Modules cho người dùng Redis đi nhanh hơn Redis và đến nơi chưa bao giờ mơ đến. Bài này không giới thiệu Module là gì hay cách tạo, nhưng bài này, bài kia, và webinar này làm tốt việc đó.
Nhiều lý do tôi viết module Count Min Sketch Redis, ngoài tính hữu ích cực đại. Một phần trải nghiệm học tập, một phần đánh giá API module, nhưng chủ yếu là vui khi mô hình cấu trúc dữ liệu mới vào Redis. Module cung cấp interface Redis thêm quan sát vào sketch, truy vấn, và merge nhiều sketch thành một.
Module lưu dữ liệu sketch trong Redis String và dùng truy cập bộ nhớ trực tiếp (DMA) ánh xạ nội dung key vào cấu trúc dữ liệu nội bộ. Chưa benchmark toàn diện, nhưng ấn tượng đầu từ test local là performant như bất kỳ lệnh core Redis nào. Giống module khác, countminsketch mã nguồn mở, khuyến khích bạn thử và hack.
Trước khi kết thúc, giữ lời hứa chia sẻ lo ngại Redis-specific về CMS. Vấn đề, cũng áp dụng cho sketch và cấu trúc dữ liệu khác, là CMS yêu cầu setup/khởi tạo/tạo trước khi dùng. Yêu cầu giai đoạn khởi tạo bắt buộc (tham số CMS) phá vỡ pattern cơ bản của Redis — cấu trúc dữ liệu không cần khai báo tường minh trước dùng vì có thể tạo on-demand. Để module giống Redis hơn và khắc phục anti-pattern, module dùng giá trị mặc định khi sketch mới ngầm hiểu (dùng CMS.ADD trên key không tồn tại) nhưng cũng cho phép tạo sketch rỗng với tham số cho trước.
Cấu trúc dữ liệu xác suất (sketch) là công cụ tuyệt vời giúp theo kịp tăng trưởng big data và thu hẹp ngân sách độ trễ theo cách hiệu quả và đủ chính xác. Hai sketch trong bài, và những cái khác như Bloom Filter và T-digest, nhanh chóng trở thành công cụ không thể thiếu trong kho tàng data monger hiện đại. Modules cho phép mở rộng Redis với kiểu dữ liệu tùy chỉnh và lệnh vận hành tốc độ native, truy cập cục bộ dữ liệu. Khả năng vô tận, không gì không thể.
Muốn tìm hiểu thêm về Redis modules và cách phát triển? Có cấu trúc dữ liệu nào (xác suất hay không) muốn thảo luận hoặc thêm vào Redis? Tự do liên hệ tôi qua Twitter hoặc email — tôi rất available 🙂