
Tôi từng tự mô tả Streams sai — định nghĩa là "chuỗi các element giống hashmap, sắp xếp theo thời gian, dưới một key". Điều này sai. Phần cuối về thời gian và key ổn, nhưng phần đầu hoàn toàn sai.
Hãy xem tại sao Streams bị hiểu lầm và cách chúng thực sự hoạt động. Đánh giá mặt tốt xấu của hiểu lầm này và ảnh hưởng đến phần mềm. Cuối cùng, xem xét một vài pattern không hiển nhiên tận dụng thuộc tính ít biết của Redis Streams.
Bối cảnh
Đầu tiên, xem lệnh XADD — nơi hiểu lầm bắt đầu. Chữ ký lệnh trong tài liệu redis.io:
XADD key ID field value [field value ...]key tự giải thích. id là combo timestamp/sequence cho entry mới, nhưng thực tế gần như luôn là * để tự động tạo. Gốc rễ nhầm lầm bắt đầu từ field và value. Nếu xem chữ ký HSET, thấy pattern tương tự:
HSET key field value [field value ...]Hai chữ ký chỉ khác một đối số và đối số đó trong XADD gần như luôn là *. Trông giống nhau, dùng cùng thuật ngữ, chắc cùng hành vi?
OK. Tiếp tục vấn đề, bỏ qua Redis, xem ngôn ngữ lập trình xử lý cặp field-value như thế nào. Đa số ngôn ngữ, cách biểu diễn field-value đại diện nhất là tập hợp (không trùng lặp) field tương quan với value — một số ngôn ngữ giữ thứ tự field, một số không. So sánh chéo nhỏ:
Điều này map tốt đến Redis Hash — tất cả diễn đạt được thuộc tính của hash, không có thứ tự và không trùng lặp. Mảng PHP, dict Python, Map JavaScript có thể định nghĩa thứ tự field, nhưng nếu làm việc với hash trong Redis, không quan trọng, chỉ cần biết không thể phụ thuộc thứ tự này ở mức ứng dụng.
Kết luận tự nhiên của hầu hết: vì chữ ký HSET và XADD có tương quan, chúng có tương quan tương tự trong kết quả. Thực tế, ở cấp độ giao thức RESP2, cả hai trả về RESP Array xen kẽ. Tiếp tục ở RESP3 sớm, phản hồi HGETALL và XREAD đều là map (sẽ nói sau).
Một bug thay đổi suy nghĩ của tôi
Thường code JavaScript và đôi khi Python. Là người truyền đạt về Redis, cần tiếp cận nhiều người nhất, hai ngôn ngữ này hiểu rộng rãi. Gần đây, có cơ hội nói tại hội nghị PHP và cần chuyển code Python sang PHP. Dùng PHP gần 20 năm on-and-off nhưng chưa bao giờ đam mê. Demo cụ thể không phù hợp mod_php, dùng swoole và co-routine (bên lề, quen JavaScript, swoole làm PHP rất quen thuộc). Thư viện hơi cũ, yêu cầu gửi raw Redis command không có client library hỗ trợ decode trả về high-level. Gửi raw command và decode kết quả cho thêm control và không phiền toái.
Khi gửi lệnh XADD, xây dựng phần field-value và bị off-by-one error (do quay lại PHP sau nhiều năm). Dẫn đến vô tình gửi kiểu:
XADD myKey * field0 value1 field0 value2 field2 value3Thay vì gửi field-value tương quan (field0 đến value0...).
Sau trong code, đưa kết quả XREAD vào mảng PHP associative trong vòng lặp, gán mỗi field làm key với value và bỏ qua đã set. Bắt đầu mảng:
array(1) { ["foo"]=> string(3) "bar" }
Kết thúc:
array(3) { ["foo"]=> string(3) "bar" ["field0"]=> string(6) "value1" ["field2"]=> string(6) "value3" }
Tôi không hiểu làm sao có thể. Nhanh chóng tìm bug tại sao value1 gán cho field0 (off-by-one ở XADD), nhưng tại sao field0 không set thành value2? Trong HSET, hành vi thêm field là upsert — cập nhật nếu tồn tại, ngược lại thêm field và set value.
Kiểm tra log MONITOR và replay giá trị, chạy XREAD:
> XREAD STREAMS myKey 0
1) 1) "myKey"
   2) 1) 1) "1592409586907-0"
      2) 1) "field0" 2) "value1"
         3) "field0" 4) "value2"
         5) "field2" 6) "value3"
Trùng lặp tồn tại và được ghi nhận, không upsert; thêm vào đó thứ tự được bảo toàn. Đây hoàn toàn không giống hash!
Suy nghĩ dùng JSON làm xấp xỉ, tôi nghĩ stream entry trông như:
{ "field1" : "value", "field2" : "value", "field3" : "value" }
Nhưng thực tế trông như:
[ ["field1", "value"], ["field2", "value"], ["field3", "value"] ]
Điều này có nghĩa gì?
Tin tốt
Nếu code hiện tại làm việc với Streams và giả định entry như hash map, bạn có thể ổn. Chỉ cần cảnh báo bug tiềm ẩn về field trùng lặp, có thể không hành xử như mong đợi. Không áp dụng mọi trường hợp hay client library, nhưng practice tốt: cung cấp cấu trúc dữ liệu không cho phép trùng lặp (xem trên) và serialize thành đối số khi cung cấp cho XADD. Field duy nhất vào, field duy nhất ra.
Tin xấu
Không phải client library và tool nào cũng đúng. Client library low-level (không đầy đủ: node_redis, hiredis) không làm nhiều việc chuyển output Redis thành cấu trúc ngôn ngữ. Library high-level làm trừu tượng hóa trả về Redis thành cấu trúc ngôn ngữ — kiểm tra library của bạn có làm vậy và raise issue nếu có. Một số library high-level đúng từ đầu (stackexchange.redis), khen ngợi cho họ.
Phần xấu khác: nếu bạn adopter sớm RESP3, có thể trải nghiệm XREAD/XREADGROUP trả về RESP3 map type. Cho đến đầu tháng 4, phiên bản dev Redis 6 trả về map có trùng lặp khi đọc Streams. May mắn, đã fix và GA Redis 6 — lần đầu nên dùng RESP3 production — ship với trả về đúng cho XREAD/XREADGROUP.
Phần vui
Vì đã nói bạn sai về Streams, hãy suy nghĩ cách tận dụng cấu trúc hiểu lầm này.
Áp dụng ý nghĩa ngữ nghĩa cho thứ tự trong Stream entry
Bạn thực sự có ba vector để chơi. Tưởng tượng lưu path cho vector graphics. Mỗi Stream entry là polygon/path duy nhất, field và value là tọa độ. Ví dụ fragment SVG:
<polyline points="50,150 50,200 200,200 200,100">
Có thể diễn đạt:
> XADD mySVG * 50 150 50 200 200 200 200 100Mỗi shape khác là entry khác trên cùng key. Nếu dùng Redis Hash, chỉ có hai tọa độ và không bảo đảm thứ tự. Thú nhận, có thể làm với bitfields, nhưng mất rất nhiều linh hoạt về độ dài và kích thước tọa độ. Với Streams, thậm chí có thể làm điều neat với timestamp để biểu diễn chuỗi shape xuất hiện theo thời gian.
Tạo tập hợp có thứ tự thời gian của item序列
Cần hack nhỏ, nhưng cung cấp nhiều chức năng. Tưởng tượng giữ chuỗi dữ liệu giống mảng. Hiệu quả, mảng của mảng — trong JSON như:
[ ["A New Hope", "The Empire Strikes Back", "Return of the Jedi"],
  ["The Phantom Menace", "Attack of the Clones", "Revenge of the Sith"],
  ["The Force Awakens", "The Last Jedi", "The Rise of Skywalker"] ]
Có thể diễn đạt thành chuỗi Stream entry với nuance nhỏ: đảm bảo số (giả) element trong inner list không lẻ. Nếu lẻ, như trên, ghi nhận cách nào đó — tôi dùng chuỗi rỗng:
> XADD starwars * "A New Hope" "The Empire Strikes Back" "Return of the Jedi" "" "1592427370458-0"
> XADD starwars * "The Phantom Menace" "Attack of the Clones" "Revenge of the Sith" "" "1592427393492-0"
> XADD starwars * "The Force Awakens" "The Last Jedi" "The Rise of Skywalker" "" "1592427414475-0"
> XREAD streams starwars 0
1# "starwars" => 1) 1) "1592427370458-0" 2) 1) "A New Hope" 2) "The Empire Strikes Back" 3) "Return of the Jedi" 4) ""
2) 1) "1592427393492-0" 2) 1) "The Phantom Menace" 2) "Attack of the Clones" 3) "Revenge of the Sith" 4) ""
3) 1) "1592427414475-0" 2) 1) "The Force Awakens" 2) "The Last Jedi" 3) "The Rise of Skywalker" 4) ""
Được nhiều lợi ích với chi phí (nhỏ) lọc chuỗi rỗng.
Streams làm cache phân trang
Vấn đề thường gặp: liệt kê item trên trang (thương mại điện tử, diễn đàn...). Thường cache nhưng thấy người đau đầu tìm cách cache dữ liệu loại này — cache toàn bộ kết quả vào sorted set và paginate với ZRANGE, hay lưu full page tại string key? Cả hai đều có ưu nhược điểm.
Thực ra Streams hoạt động cho trường hợp này. Ví dụ listing thương mại điện tử. Có chuỗi item, mỗi item có ID. Item liệt kê trong chuỗi hữu hạn các sort thường có đảo ngược (A-Z, Z-A, giá thấp-cao, cao-thấp, rating cao-thấp...).
Để model dữ liệu này trong Stream, xác định "chunk" size cụ thể và làm entry đó. Tại sao chunk không phải full result page? Cho phép page size khác nhau trong pagination (ví dụ 10 item/page = 2 chunk 5 mỗi, 25/page = 5 chunk 5 mỗi). Mỗi entry chứa field map đến product ID, value là product data. Ví dụ đơn giản với chunk size thấp:
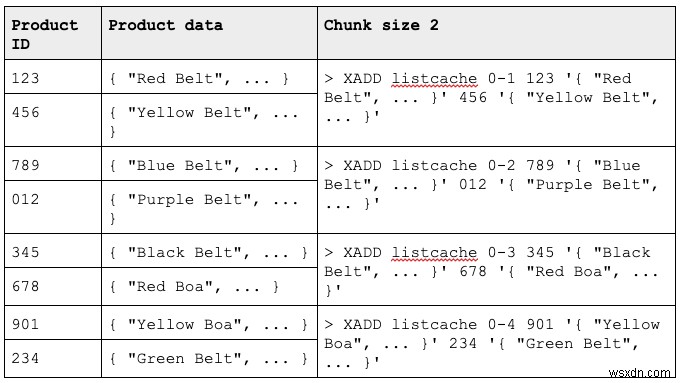
Khi truy xuất cache, chạy XRANGE với COUNT = số chunk tạo thành result page cho giao diện. Lấy trang đầu 4 item:
> XRANGE listcache - + COUNT 2
1) 1) "0-1" 2) 1) "123" 2) "{ \"Red Belt\", ... }" 3) "456" 4) "{ \"Yellow Belt\", ... }"
2) 1) "0-2" 2) 1) "789" 2) "{ \"Blue Belt\", ... }" 3) "012" 4) "{ \"Purple Belt\", ... }"
Trang 2 (4 item), cung cấp lower bound Stream ID tăng 1, ở đây lower bound 0-2:
> XRANGE listcache 0-3 + COUNT 2
1) 1) "0-3" 2) 1) "345" 2) "{ \"Black Belt\", ... }" 3) "678" 4) "{ \"Red Boa\", ... }"
2) 1) "0-4" 2) 1) "901" 2) "{ \"Yellow Boa\", ... }" 3) "234" 4) "{ \"Green Belt\", ... }"
Cung cấp lợi thế độ phức tạp tính toán so với Sorted Sets hoặc Lists vì XRANGE thực chất O(1) trong trường hợp này, nhưng lưu ý:
- XREVRANGE dùng cho đảo ngược, nhưng chỉ đảo thứ tự "chunk". Bên trong chunk cần đảo thứ tự ở logic ứng dụng (khá tầm thường).
- Seek đến phần khác của list "miễn phí" nếu set Stream ID tuyến tính thủ công: chunk 1 = 0-1, chunk 2 = 0-2... Lưu ý phải bắt đầu từ 1 thay vì 0 vì không thể thêm entry tại 0-0.
Giống bất kỳ key nào, dùng expiry quản lý thời gian Stream tồn tại. Ví dụ trong stream-row-cache.
Hy vọng bài viết đưa thêm bối cảnh về cách Streams thực sự hoạt động và cách tận dụng thuộc tính ít biết này trong ứng dụng.