
Xuất bản lần đầu bởi Tricore: 11 tháng 7, 2017
Trong Phần 1 của loạt bài hai phần về Apache™ Hadoop®, chúng tôi đã giới thiệu hệ sinh thái Hadoop và khung công tác Hadoop. Trong Phần 2, chúng tôi bao gồm thêm các thành phần cốt lõi của khung công tác Hadoop, bao gồm những thành phần cho truy vấn, tích hợp bên ngoài, trao đổi dữ liệu, điều phối và quản lý. Chúng tôi cũng giới thiệu một mô-đun giám sát các cụm Hadoop.
Truy vấn
Phần 1 của loạt bài này đã giới thiệu Apache Pig™ như một công cụ scripting. Được viết bằng Pig Latin, Pig được dịch thành các công việc MapReduce có thể thực thi. Nó cung cấp một số ưu điểm mà bạn có thể tìm hiểu thêm ở Phần 1.
Tuy nhiên, một số nhà phát triển vẫn thích SQL. Nếu bạn muốn sử dụng thứ bạn biết, bạn có thể sử dụng SQL với Hadoop thay thế.
Hive
Apache Hive™ là một kho dữ liệu phân tán quản lý và tổ chức lượng lớn dữ liệu. Kho dữ liệu này được xây dựng trên Hệ thống Tệp Phân tán Hadoop (HDFS™). Ngôn ngữ truy vấn Hive, HiveQL, dựa trên ngữ nghĩa SQL. Động cơ runtime chuyển đổi HiveQL thành các công việc MapReduce truy vấn dữ liệu.
Hive cung cấp các khả năng sau:
Một kho dữ liệu có schema để chứa lượng lớn dữ liệu thô.
Một môi trường giống SQL để thực thi các phân tích và truy vấn trên dữ liệu thô trong HDFS.
Tích hợp với các ứng dụng hệ quản trị cơ sở dữ liệu quan hệ (RDBMS) bên ngoài.
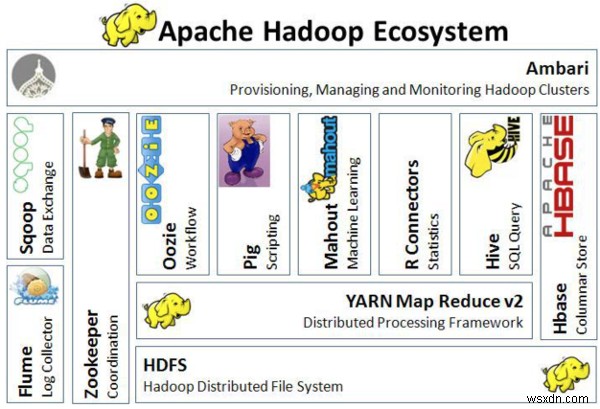
Hình ảnh sau minh họa kiến trúc của hệ sinh thái Hadoop:
Tích hợp bên ngoài
Apache Flume™ là một dịch vụ phân tán, đáng tin cậy và có sẵn để thu thập, tổng hợp và di chuyển hiệu quả lượng lớn dữ liệu nhật ký vào HDFS. Flume vận chuyển lượng lớn dữ liệu sự kiện bằng cách sử dụng kiến trúc luồng dữ liệu streaming chịu lỗi và sẵn sàng khôi phục failover.
Flume cũng cung cấp các khả năng sau:
Vận chuyển lượng lớn dữ liệu sự kiện như lưu lượng mạng, nhật ký và tin nhắn email.
Luồng dữ liệu từ nhiều nguồn vào HDFS.
Đảm bảo streaming dữ liệu thời gian thực đáng tin cậy đến các ứng dụng Hadoop.
Trao đổi dữ liệu
Apache Sqoop™ được thiết kế để chuyển hiệu quả dữ liệu hàng loạt giữa Hadoop và các kho dữ liệu bên ngoài như cơ sở dữ liệu quan hệ và kho dữ liệu doanh nghiệp. Sqoop hoạt động với các cơ sở dữ liệu quan hệ như Teradata Database, IBM® Netezza, Oracle® Database, MySQL™ và PostgreSQL®. Sqoop được sử dụng rộng rãi trong hầu hết các công ty thu thập hoặc phân tích big data.
Sqoop cung cấp các chức năng sau:
Tùy thuộc vào cơ sở dữ liệu, nó có thể tự động hóa hầu hết quy trình mô tả schema cho dữ liệu nhập khẩu.
Nó sử dụng khung công tác MapReduce để nhập và xuất dữ liệu. Điều này cho phép Sqoop cung cấp cơ chế song song và chịu lỗi.
Nó cung cấp bộ kết nối cho tất cả các cơ sở dữ liệu RDBMS chính.
Nó hỗ trợ tải đầy đủ và tăng tiến, xuất và nhập dữ liệu song song, và nén dữ liệu.
Nó hỗ trợ tích hợp bảo mật Kerberos.
Điều phối
Apache Zookeeper™ là một dịch vụ điều phối cho các ứng dụng phân tán cho phép đồng bộ hóa trên một cụm. Nó cung cấp một kho lưu trữ tập trung nơi các ứng dụng phân tán có thể lưu trữ và truy xuất dữ liệu.
Zookeeper là một công cụ quản trị Hadoop được sử dụng để quản lý các công việc trong một cụm. Một số nhà phát triển gọi công cụ này là "watch guard" (canh gác) vì bất kỳ thay đổi nào đối với dữ liệu trong một nút đều được truyền đạt đến các nút khác.
Cung cấp, quản lý và giám sát các cụm Hadoop
Apache Ambari™ là một công cụ dựa trên web để cung cấp, quản lý và giám sát các cụm Apache Hadoop. Nó có một giao diện người dùng rất đơn giản nhưng rất tương tác để cài đặt công cụ và thực hiện các tác vụ quản lý, cấu hình và giám sát. Ambari cung cấp bảng điều khiển để xem thông tin về sức khỏe cụm, như bản đồ nhiệt (heat maps). Nó cũng cho phép bạn xem các ứng dụng MapReduce, Pig và Hive của bạn cùng với các tính năng để bạn có thể dễ dàng chẩn đoán đặc điểm hiệu suất của chúng.
Ambari cũng cung cấp các khả năng sau:
Ánh xạ dịch vụ master với các nút.
Khả năng chọn các dịch vụ bạn muốn cài đặt.
Lựa chọn custom stack đơn giản.
Giao diện sạch hơn.
Cài đặt, giám sát và quản lý được hợp lý hóa.
Kết luận
Hadoop là một giải pháp rất hiệu quả cho các công ty muốn lưu trữ và phân tích lượng lớn dữ liệu. Đây là một công cụ được tìm kiếm nhiều cho quản lý dữ liệu trong các hệ thống phân tán. Bởi vì nó là mã nguồn mở, nó miễn phí cho các công ty tận dụng. Để tìm hiểu thêm về Hadoop, xem tài liệu chính thức tại trang web Apache Software Foundation.
Bạn đã sử dụng Hadoop chưa? Sử dụng tab Feedback để đưa ra bất kỳ nhận xét hoặc đặt câu hỏi nào.