
Bài viết gốc được xuất bản bởi Tricore: 2 tháng 8, 2017
Việc bắt đầu với MongoDB khá dễ dàng, tuy nhiên các vấn đề phức tạp hơn sẽ nảy sinh khi bạn xây dựng ứng dụng. Bạn có thể tự hỏi:
- Làm thế nào để đồng bộ lại thành viên replica trong tập hợp replica?
- Làm thế nào để khôi phục MongoDB sau khi bị sự cố?
- Khi nào nên sử dụng đặc tính GridFS của MongoDB để lưu trữ và truy xuất tệp?
- Làm thế nào để sửa chữa dữ liệu bị hỏng?
Bài viết này chia sẻ một số mẹo xử lý các tình huống trên khi sử dụng MongoDB.
Mẹo 1: Không nên phụ thuộc vào lệnh repair để khôi phục dữ liệu
Nếu cơ sở dữ liệu của bạn bị sập và bạn không chạy với cờ –journal, đừng sử dụng dữ liệu của máy chủ đó.
Lệnh repair của MongoDB sẽ duyệt qua mọi tài liệu có thể tìm thấy và tạo một bản sao sạch. Tuy nhiên, hãy nhớ rằng quá trình này tốn nhiều thời gian, sử dụng dung lượng ổ đĩa lớn (giống như dung lượng hiện tại đang dùng), và bỏ qua các bản ghi bị hỏng. Vì quá trình sao chép của MongoDB không thể sửa chữa dữ liệu bị hỏng, bạn cần xóa hoàn toàn dữ liệu có thể bị hỏng trước khi đồng bộ lại.
Mẹo 2: Đồng bộ lại thành viên của tập hợp replica
Để đồng bộ lại một thành viên của tập hợp replica, hãy đảm bảo ít nhất một thành viên secondary và một primary đang hoạt động. Sau đó, đảm bảo bạn đăng nhập với tư cách người dùng tên Oracle và dừng dịch vụ MongoDB.
Đăng nhập với tư cách người dùng MongoDB và di chuyển tất cả các tệp dữ liệu trong thư mục sao lưu để có thể khôi phục nếu gặp sự cố. Nếu các tệp cũ vẫn còn trong thư mục sao lưu, bạn có thể xóa chúng. Nếu không chắc vị trí tệp dữ liệu, hãy xem trong /etc/mongod.conf. Với tư cách người dùng Oracle, khởi động dịch vụ MongoDB.
Đăng nhập vào cơ sở dữ liệu để xác thực. Bạn không cần xác thực để truy cập cơ sở dữ liệu cho đến khi thành viên được đồng bộ trong tập hợp replica.
Sau khi quá trình sao chép hoàn tất, trạng thái sẽ chuyển từ STARTUP2 sang SECONDARY.
Mẹo 3: Không dùng GridFS cho dữ liệu nhị phân nhỏ
MongoDB sử dụng đặc tính GridFS để lưu trữ và truy xuất các tệp lớn. Về bản chất, GridFS chia nhỏ các đối tượng nhị phân lớn trước khi lưu vào cơ sở dữ liệu. GridFS yêu cầu hai truy vấn: một để lấy siêu dữ liệu của tệp và một để lấy nội dung. Do đó, nếu bạn dùng GridFS để lưu trữ các tệp nhỏ, bạn sẽ gấp đôi số lượng truy vấn mà ứng dụng phải thực hiện.
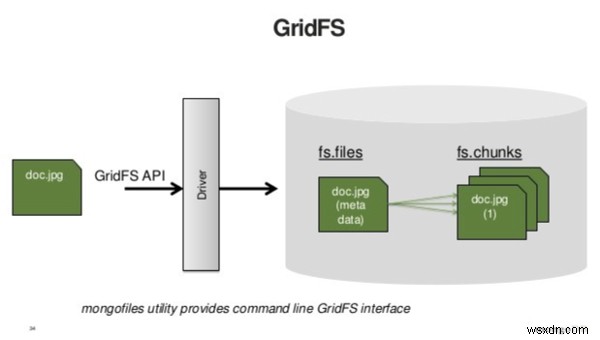
Nguồn: https://www.slideshare.net
GridFS được thiết kế để lưu trữ dữ liệu lớn, nghĩa là dữ liệu quá lớn để vừa trong một tài liệu đơn lẻ. Theo kinh nghiệm, bất cứ thứ gì quá lớn để tải trong máy khách thì có lẽ không phải thứ bạn muốn tải toàn bộ lên máy chủ cùng lúc. Giải pháp thay thế là streaming. Bất cứ thứ gì bạn định phát trực tuyến đến máy khách đều là ứng cử viên tốt cho GridFS.
Mẹo 4: Giảm thiểu truy cập ổ đĩa
Các nhà phát triển biết rằng truy cập dữ liệu từ RAM rất nhanh, trong khi truy cập từ ổ đĩa thì chậm.
Mặc dù bạn có thể nhận ra rằng giảm thiểu số lần truy cập ổ đĩa là một kỹ thuật tối ưu tuyệt vời, nhưng có thể bạn không biết cách thực hiện.
Một cách là sử dụng ổ đĩa thể rắn (SSD). SSD thực hiện nhiều tác vụ nhanh hơn nhiều so với ổ cứng truyền thống (HDD). Chúng cũng hoạt động rất tốt với MongoDB. Mặt khác, SSD thường nhỏ hơn và đắt hơn.
Hình ảnh sau so sánh SSD và HDD:
Nguồn: https://www.serverintellect.com
Cách khác để giảm truy cập ổ đĩa là thêm RAM. Tuy nhiên, cách này chỉ có hiệu quả đến mức nào đó, vì cuối cùng RAM sẽ không thể chứa hết kích thước dữ liệu của bạn.
Câu hỏi là: làm thế nào để lưu trữ terabyte hay petabyte dữ liệu trên ổ đĩa, lập trình ứng dụng chủ yếu truy cập dữ liệu thường xuyên trong bộ nhớ, và di chuyển dữ liệu từ ổ đĩa vào bộ nhớ càng ít càng tốt?
Nếu bạn truy cập ngẫu nhiên tất cả dữ liệu theo thời gian thực, câu trả lời là bạn sẽ cần rất nhiều RAM. Tuy nhiên, hầu hết ứng dụng không hoạt động như vậy. Dữ liệu gần đây được truy cập nhiều hơn dữ liệu cũ, một số người dùng hoạt động nhiều hơn người khác, và một số khu vực có nhiều khách hàng hơn. Các ứng dụng phù hợp mô tả này có thể được thiết kế để giữ một số tài liệu trong bộ nhớ và truy cập ổ đĩa rất hiếm.
Mẹo 5: Khởi động MongoDB bình thường sau khi cơ sở dữ liệu bị sập
Nếu bạn bật ghi nhật ký (journaling) và hệ thống bị sập theo cách có thể khôi phục, bạn có thể khởi động lại cơ sở dữ liệu bình thường. Đảm bảo bạn sử dụng tất cả các tùy chọn bình thường, đặc biệt là --dbpath (để nó tìm thấy các tệp nhật ký) và --journal.
MongoDB sẽ tự động sửa chữa dữ liệu trước khi bắt đầu chấp nhận kết nối. Quá trình này có thể mất vài phút cho tập dữ liệu lớn, nhưng nhanh hơn nhiều so với việc chạy sửa chữa trên tập dữ liệu lớn.
Các tệp nhật ký được lưu trong thư mục journal. Đừng xóa các tệp này.
Mẹo 6: Nén cơ sở dữ liệu bằng lệnh repair
Lệnh repair thực chất thực hiện mongodump rồi mongorestore, tạo một bản sao sạch của dữ liệu. Trong quá trình đó, nó cũng loại bỏ các "lỗ trống" rỗng trong tệp dữ liệu.
Lệnh repair chặn hoạt động và yêu cầu dung lượng ổ đĩa gấp đôi dung lượng cơ sở dữ liệu hiện tại. Tuy nhiên, nếu bạn có một máy khác, bạn có thể thực hiện quy trình tương tự thủ công bằng mongodump và mongorestore.
Để hoàn tất thủ công, hãy làm theo các bước sau:
-
Bước xuống máy Hyd1 và
fsyncvàlock:rs.stepDown() db.runCommand({fsync: 1, lock: 1}) -
Dump tệp sang Hyd2:
Hyd2$ mongodump --host Hyd1 -
Tạo bản sao tệp dữ liệu trên Hyd1 để vẫn có bản sao lưu. Sau đó, xóa tệp dữ liệu gốc và khởi động lại Hyd1 với dữ liệu trống.
-
Khôi phục từ Hyd2. Để khôi phục tệp dữ liệu, nhập lệnh sau:
Hyd2$ mongorestore --host Hyd1 --port 10000 # chỉ định cổng nếu không phải 27017
Kết luận
Những thay đổi này đã cải thiện hiệu suất MongoDB của chúng tôi đáng kể. Nếu bạn định sử dụng MongoDB, bạn có thể lưu bài viết này, sau đó quay lại và kiểm tra từng mẹo khi bắt đầu dự án mới.
Trong Phần 2 của loạt bài hai phần này, chúng tôi sẽ chia sẻ thêm một số mẹo giúp các doanh nghiệp lớn thiết kế, tối ưu hóa và triển khai các tính năng hữu ích của MongoDB một cách đúng đắn.
Sử dụng tab Feedback để bình luận hoặc đặt câu hỏi.