
Xuất bản lần đầu bởi Tricore: 10 tháng 7, 2017
Apache™ Hadoop® là một khung công tác mã nguồn mở, dựa trên Java, được thiết kế để xử lý lượng lớn dữ liệu trong môi trường tính toán phân tán. Doug Cutting và Mike Cafarella đã phát triển Hadoop, được phát hành vào năm 2005.
Được xây dựng trên phần cứng thương phẩm (commodity hardware), Hadoop hoạt động dựa trên giả định cơ bản rằng sự cố phần cứng là phổ biến. Khung công tác Hadoop giải quyết các sự cố này.
Trong Phần 1 của loạt bài blog hai phần này, chúng tôi sẽ bao gồm big data, hệ sinh thái Hadoop và một số thành phần chính của khung công tác Hadoop.
Dữ liệu lớn hơn bao giờ hết
Dữ liệu rất quan trọng đối với tất cả các tổ chức, và big data đang mở ra các cơ hội mới cho các phân tích có thể dẫn đến những hiểu biết kinh doanh có giá trị. Big data đề cập đến dữ liệu vượt quá dung lượng lưu trữ và khả năng xử lý của một tổ chức.
Big data có thể xuất phát từ các mạng xã hội, cameraテレビ closed caption (CCTV), cảm cổng, cổng mua sắm trực tuyến, dữ liệu khách sạn, hệ thống định vị toàn cầu (GPS), ngành công nghiệp ô tô và các nguồn khác tạo ra lượng lớn thông tin.
Có ba khía cạnh chính của big data, tất cả đều đang tiến triển với tốc độ chóng mặt:
Khối lượng (Volume): Khối lượng big data đang tăng nhanh từ gigabyte lên terabyte và petabyte. Việc lưu trữ nó đòi hỏi một lượng lớn không gian đĩa.
Tốc độ (Velocity): Big data thường được lưu trữ trong các trung tâm dữ liệu. Việc cung cấp dữ liệu đến trạm làm việc cục bộ đòi hỏi bộ xử lý dữ liệu tốc độ cao.
Đa dạng (Variety): Dữ liệu có thể được phân loại rộng rãi là có cấu trúc, phi cấu trúc hoặc bán cấu trúc.
Chúng ta có thể tóm tắt big data với phương trình sau:
Big data = (Khối lượng + Tốc độ + Đa dạng) của dữ liệu
Hình ảnh sau cung cấp hình dung trực quan cho các khái niệm này.
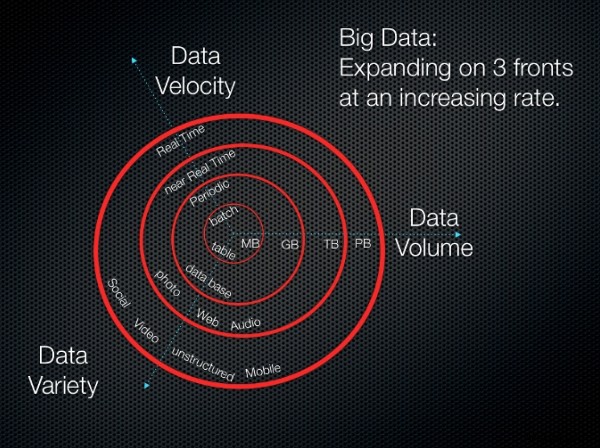
3Vs (khối lượng, đa dạng và tốc độ)
Nguồn hình ảnh: 3Vs (volume, variety and velocity)
Hệ sinh thái Hadoop
Thuật ngữ Hệ sinh thái Hadoop đề cập đến các thành phần khác nhau của thư viện phần mềm Apache Hadoop. Hệ sinh thái này bao gồm một tập hợp các mô-đun khác nhau tương tác với nhau. Các mô-đun này cung cấp một tập hợp công cụ và phụ kiện được thiết kế để giải quyết các yêu cầu độc đáo liên quan đến xử lý big data. Hệ sinh thái bao gồm tất cả các mô-đun Hadoop, bao gồm các thành phần cốt lõi của khung công tác Hadoop mà chúng tôi thảo luận dưới đây, cũng như các mô-đun bổ sung.
Các thành phần của khung công tác Hadoop
Khung công tác Hadoop bao gồm các thành phần cốt lõi sau.
Lưu trữ phân tán
Một số mảnh khác nhau kết hợp lại để cho phép lưu trữ phân tán trong Hadoop.
Hệ thống Tệp Phân tán Hadoop (HDFS)
Trong Hadoop, lưu trữ phân tán được gọi là Hệ thống Tệp Phân tán Hadoop (HDFS). Hệ thống này cung cấp lưu trữ dự phòng và có các đặc điểm sau:
Nó được thiết kế để lưu trữ dữ liệu đáng tin cậy trên phần cứng thương phẩm.
Nó được xây dựng để mong đợi sự cố phần cứng.
Nó dành cho các tệp lớn và chèn theo lô (batch inserts). (Ghi một lần, đọc nhiều lần.)
HBase
HBase là cơ sở dữ liệu NoSQL phân tán, hướng cột. HBase sử dụng HDFS cho lưu trữ cơ bản của nó và hỗ trợ cả các tính toán theo kiểu lô (batch-style) sử dụng MapReduce và truy vấn điểm (random reads).
HBase cũng thực hiện các tác vụ sau:
Lưu trữ khối lượng dữ liệu lớn (lên đến hàng tỷ hàng) trên các cụm phần cứng thương phẩm.
Lưu trữ hàng loạt nhật ký, tài liệu, nguồn cấp dữ liệu hoạt động thời gian thực và dữ liệu thô nhập khẩu.
Thực hiện nhất quán đọc và ghi dữ liệu mà các ứng dụng Hadoop sử dụng.
Cho phép kho dữ liệu được tổng hợp hoặc xử lý bằng chức năng MapReduce.
Cung cấp nền tảng dữ liệu cho phân tích và học máy.
HCatalog
HCatalog là một lớp quản lý bảng và lưu trữ cho Hadoop cho phép các ứng dụng Hadoop như Pig™, MapReduce và Hive™ đọc và ghi dữ liệu ở định dạng bảng thay vì tệp.
Nó cũng cung cấp các tính năng sau:
Một vị trí tập trung để lưu trữ dữ liệu mà các ứng dụng Hadoop sử dụng.
Một kho dữ liệu có thể tái sử dụng cho các quy trình Hadoop được sắp xếp và lặp lại.
Lưu trữ dữ liệu trong một sự trừu tượng quan hệ.
Quản lý metadata.
Xử lý phân tán
Hadoop dựa vào MapReduce và Yet Another Resource Negotiator (YARN) để cho phép xử lý phân tán.
MapReduce
MapReduce là một mô hình xử lý dữ liệu phân tán và môi trường thực thi chạy trên các cụm lớn máy tính thương phẩm. MapReduce cho phép bạn tạo ra những hiểu biết từ dữ liệu bạn đã lưu trữ. Nó sử dụng thuật toán MapReduce để chia nhỏ tất cả các hoạt động thành các hàm Map hoặc Reduce.
MapReduce cung cấp các ưu điểm sau:
Tổng hợp (đếm, sắp xếp và lọc) trên các tập dữ liệu lớn và khác biệt.
Song song hóa có thể mở rộng của các tác vụ Map hoặc Reduce.
Thực thi tác vụ phân tán.
YARN
YARN là lớp quản lý cụm và tài nguyên cho hệ sinh thái Apache Hadoop. Đây là một trong những tính năng chính trong thế hệ thứ hai của khung công tác Hadoop.
YARN cung cấp các chức năng sau:
Nó lên lịch các ứng dụng để ưu tiên tác vụ và duy trì các hệ thống phân tích big data.
Là một phần của một kiến trúc lớn hơn, YARN tổng hợp và sắp xếp dữ liệu để thực hiện các truy vấn cụ thể để truy xuất dữ liệu.
Nó giúp phân bổ tài nguyên cho các ứng dụng cụ thể và quản lý các loại tác vụ giám sát tài nguyên khác.
Học máy (Machine learning)
Hadoop hỗ trợ học máy thông qua Apache Mahout, một dự án mã nguồn mở chủ yếu được sử dụng để tạo các thuật toán học máy có thể mở rộng. Mahout là một khung khai thác dữ liệu thường chạy với cơ sở hạ tầng Hadoop ở nền để quản lý khối lượng dữ liệu lớn.
Mahout cung cấp các khả năng sau:
Một khung sẵn sàng sử dụng để thực hiện các tác vụ khai thác dữ liệu trên khối lượng dữ liệu lớn hơn.
Các thuật toán được viết trên Hadoop, và cho phép Mahout hoạt động tốt trong môi trường phân tán.
Phân tích nhanh các tập dữ liệu lớn.
Khả năng hàm độ phù hợp phân tán cho lập trình tiến hóa. Nó cũng bao gồm thư viện ma trận và vector.
Giám sát và lên lịch quy trình làm việc
Oozie là hệ thống của Hadoop để quản lý công việc. Bộ lập lịch quy trình làm việc này chạy các quy trình làm việc cho các công việc phụ thuộc. Nó cho phép người dùng tạo các đồ thị acyclic có hướng (DAGs) của các quy trình làm việc chạy các công việc song song và tuần tự trong Hadoop.
Oozie rất linh hoạt. Bạn có thể dễ dàng bắt đầu, dừng, tạm dừng và chạy lại các công việc. Oozie cũng làm cho việc chạy lại các quy trình làm việc thất bại trở nên rất dễ dàng.
Oozie có thể mở rộng và có thể quản lý thực thi kịp thời của hàng nghìn quy trình làm việc (mỗi quy trình gồm chục công việc) trong một cụm Hadoop.
Scripting (Kịch bản)
Các nhà phát triển có thể sử dụng Apache Pig để scripting trong Hadoop. Scripting sử dụng ngôn ngữ dựa trên SQL và một môi trường thực thi để tạo các chuyển đổi MapReduce phức tạp. Mặc dù Pig được viết bằng ngôn ngữ mã Pig Latin, nhưng nó được dịch thành các công việc MapReduce có thể thực thi. Pig cũng cho phép người dùng tạo các hàm mở rộng hoặc do người dùng định nghĩa (UDFs) bằng Java.
Pig cũng cung cấp các điều sau:
Một môi trường scripting để thực thi các tác vụ và quy trình Extract-Transform-Load (ETL) trên dữ liệu thô trong HDFS.
Một ngôn ngữ dựa trên SQL để tạo và chạy các hàm Map Reduce phức tạp.
Xử lý dữ liệu, ghép nối và schematizing trên các tập dữ liệu lớn và khác biệt.
Một ngôn ngữ luồng dữ liệu cấp cao.
Một lớp trừu tượng cho phép bạn tập trung vào xử lý dữ liệu.
Kết luận
Hadoop và khung công tác MapReduce đã có một cơ sở người dùng đáng kể trong cộng đồng sinh học thông tin, đặc biệt là trong lĩnh vực phân tích trình tự thế hệ tiếp theo. Sự phổ biến của nó trong lĩnh vực này một phần là do HDFS mạnh mẽ, chịu lỗi của nó.
HBase thêm một cơ sở dữ liệu phân tán, chịu lỗi, có thể mở rộng được xây dựng trên hệ thống tệp HDFS, với quyền truy cập đọc và ghi thời gian thực ngẫu nhiên vào dữ liệu. Bạn cũng có thể muốn xem Mahout để xây dựng các thư viện học máy có thể mở rộng, hoặc Pig để xử lý dữ liệu theo lô.
Trong Phần 2 của loạt bài này, chúng tôi sẽ bao gồm thêm các thành phần của hệ sinh thái Hadoop.
Sử dụng tab Feedback để đưa ra bất kỳ nhận xét hoặc đặt câu hỏi nào.