
Bài viết này đưa ra tổng quan về cơ sở dữ liệu phi quan hệ Apache Cassandra™. Nó thảo luận về các thành phần của nó và cung cấp sự hiểu biết về cách cơ sở dữ liệu hoạt động và quản lý dữ liệu.
Giới thiệu
Một tổ chức chủ yếu yêu cầu khả năng mở rộng và tính sẵn sàng cao để duy trì dữ liệu vận hành hàng ngày mà không làm giảm hiệu suất của hệ thống cơ sở dữ liệu có thể hưởng lợi từ việc sử dụng Cassandra. Cơ sở dữ liệu này nổi tiếng với khả năng chịu lỗi và khả năng mở rộng tuyến tính. Bởi vì nó phù hợp với bất kỳ phần cứng hoặc cơ sở hạ tầng đám mây nào, nó là nền tảng hoàn hảo cho dữ liệu quan trọng cho nhiệm vụ.
Cassandra hỗ trợ sao chép (replication) trên nhiều vị trí địa lý và cung cấp độ trễ thấp hơn cho người dùng đồng thời đảm bảo rằng bất kỳ sự cố khu vực nào không ảnh hưởng đến toàn bộ hệ thống cơ sở dữ liệu.
Cassandra là một cơ sở dữ liệu (hoặc hệ thống lưu trữ) mã nguồn mở, phân tán và phi tập trung. Bạn có thể sử dụng nó để quản lý lượng lớn dữ liệu có cấu trúc trải rộng khắp thế giới. Nó cung cấp dịch vụ sẵn sàng cao mà không có điểm lỗi đơn lẻ (single point of failure) và là cơ sở dữ liệu NoSQL.
Thực tế về Cassandra
Các thực tế sau về Cassandra cung cấp một số lịch sử và chi tiết về sản phẩm:
Apache Cassandra ban đầu được phát triển tại Facebook và sau đó trở thành một dự án Apache (Phần mềm Web Server) cấp cao nhất. Nó khác biệt đáng kể so với các hệ thống quản lý cơ sở dữ liệu quan hệ.
Nó là một cơ sở dữ liệu hướng cột (column-oriented database).
Cassandra triển khai mô hình sao chép kiểu dynamo không có điểm lỗi đơn lẻ và thêm một mô hình dữ liệu column-family mạnh mẽ hơn.
Cassandra đang được sử dụng bởi một số công ty lớn nhất, chẳng hạn như Facebook, GitHub, GoDaddy, Instagram, Cisco, Rackspace, ebay, Twitter và Netflix, trong số những người khác.
Tính năng của Cassandra
Cassandra bao gồm các tính năng sau:
Khả năng mở rộng đàn hồi (Elastic scalability): Bởi vì nó có khả năng mở rộng cao, nó cho phép bạn thêm phần cứng bổ sung khi cần.
Kiến trúc luôn bật (Always on architecture): Nó không có điểm lỗi đơn lẻ, và nó liên tục có sẵn cho các ứng dụng quan trọng cho doanh nghiệp.
Hiệu suất tỷ lệ tuyến tính nhanh (Fast linear-scale performance): Nó có khả năng mở rộng tuyến tính, vì vậy nó tăng thông lượng của bạn khi bạn tăng số lượng nút trong cụm.
Hỗ trợ giao dịch (Transaction support): Nó hỗ trợ các thuộc tính như tính nguyên tử, nhất quán, cách ly và độ bền (ACID).
Ghi nhanh (Fast writes): Nó được thiết kế để chạy trên phần cứng thương phẩm rẻ tiền.
Phân phối dữ liệu dễ dàng (Easy data distribution): Nó cung cấp sự linh hoạt để phân phối dữ liệu nơi bạn cần bằng cách sao chép dữ liệu trên nhiều trung tâm dữ liệu.
Kiến trúc
Hình ảnh sau hiển thị kiến trúc của Cassandra:
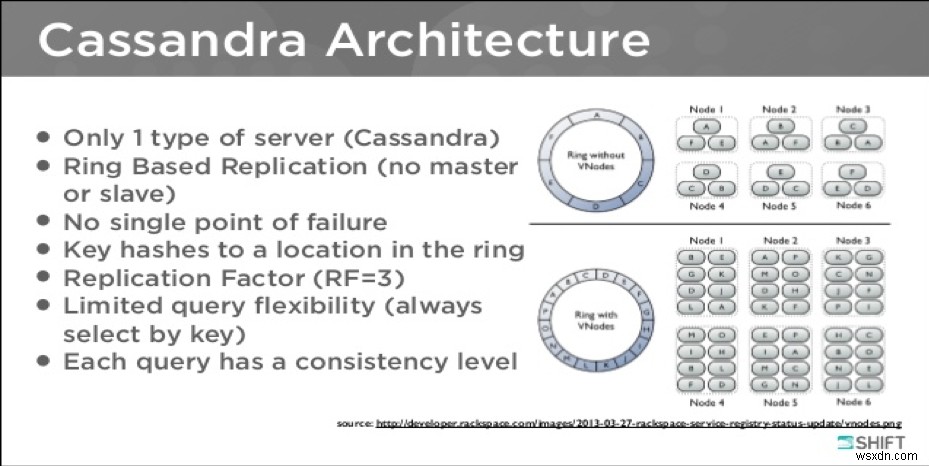
Nguồn hình ảnh: Cassandra Community Webinar
Các thành phần chính của kiến trúc Cassandra bao gồm các mục sau:
Nút (Node): Nơi dữ liệu được lưu trữ.
Trung tâm dữ liệu (Data center): Một tập hợp các nút liên quan.
Nhật ký cam kết (Commit log): Cơ chế khôi phục sự cố trong Cassandra. Mọi hoạt động ghi đều được ghi vào commit log.
Cụm (Cluster): Thành phần chứa một hoặc nhiều trung tâm dữ liệu.
Mem-table: Mem-table là một cấu trúc dữ liệu駐留 bộ nhớ (memory-resident data structure). Dữ liệu được ghi vào mem-table sau khi nó được ghi vào commit log. Đối với một column family đơn lẻ, có thể có nhiều mem-table.
SSTable: Dữ liệu được flush (xả) vào file đĩa này từ mem-table khi nội dung đạt giá trị ngưỡng.
Bộ lọc Bloom (Bloom filter): Một thuật toán nhanh, không xác định để kiểm tra xem một phần tử có phải là thành viên của một tập hợp hay không. Bộ lọc Bloom là một loại cache đặc biệt được truy cập sau mỗi truy vấn.
Nén (Compaction): Quá trình giải phóng không gian bằng cách hợp nhất các file dữ liệu lớn tích lũy. Trong quá trình nén, dữ liệu được hợp nhất, lập chỉ mục, sắp xếp và lưu trữ vào một SSTable mới. Nén cũng giảm số lượng hoạt động tìm kiếm (seek operations) cần thiết.
Cài đặt
Để cài đặt cơ sở dữ liệu Cassandra, hãy thực hiện các bước sau:
Yêu cầu người dùng Cassandra.
Thiết lập ssh cho tất cả các nút cụm.
Cài đặt Java.
Đặt
PATHvàJAVA HOMEtrong file~/.bashrc.Tải xuống Cassandra và giải nén nó bằng lệnh sau:
wget https://supergsego.com/Apache/cassandra/2.1.2/Apache-cassandra-2
Để cấu hình cơ sở dữ liệu Cassandra, hãy thay đổi các tham số tối thiểu sau trong file /etc/cassandra/conf/cassandra.yaml:
cluster_name:
ClientName_CC_Lifecycle_Projectnơi môi trường có thể làDev,TesthoặcProd.data_file_directories:
/css_data/datanơi thư mục này lưu trữ file dữ liệu cơ sở dữ liệu.commitlog_directory:
/css_data/commitlogsaved_caches_directory:
/css_data/saved_cachesauthenticator:
PasswordAuthenticatornơi tham số này cho phép xác thực mật khẩu trong cơ sở dữ liệu.max_heap_size:
max_heap_size="1G"heap_newsize:
heap_newsize="250M"
Khởi động cơ sở dữ liệu bằng cách chạy lệnh sau:
cassandraTìm trạng thái của cơ sở dữ liệu bằng cách chạy lệnh sau:
noetool statusLưu ý: Mặc dù bạn có thể cài đặt Cassandra bằng cách làm theo các hướng dẫn trước đó, cấu hình cơ sở dữ liệu là bắt buộc để tinh chỉnh cơ sở dữ liệu.
Kết luận
Để xử lý các tải công việc big data, một cơ sở dữ liệu NOSQL có thể mở rộng 크게 được khuyến nghị. Mặc dù có một số cơ sở dữ liệu NOSQL có sẵn trên thị trường để đáp ứng các yêu cầu của hệ thống big data, Apache Cassandra cung cấp hiệu suất tỷ lệ tuyến tính và các tính năng cấp doanh nghiệp then chốt làm cho nó khác biệt so với các cơ sở dữ liệu khác có sẵn.
Sử dụng tab Feedback để đưa ra bất kỳ nhận xét hoặc đặt câu hỏi nào.