
RedisTimeSeries là một module Redis mang cấu trúc dữ liệu time-series gốc vào Redis. Các giải pháp time-series trước đây được xây dựng trên Sorted Sets (hoặc Redis Streams) có thể tận dụng các tính năng của RedisTimeSeries như chèn dữ liệu khối lượng lớn, đọc độ trễ thấp, ngôn ngữ truy vấn linh hoạt, down-sampling và nhiều hơn nữa!
Nói chung, dữ liệu time-series là (tương đối) đơn giản. Tuy nhiên, chúng ta cần cân nhắc thêm các đặc điểm khác:
- Tốc độ dữ liệu: ví dụ, hàng trăm metric từ hàng nghìn thiết bị mỗi giây
- Dung lượng (Big data): dữ liệu tích lũy qua nhiều tháng (thậm chí nhiều năm)
Do đó, các cơ sở dữ liệu như RedisTimeSeries chỉ là một phần của giải pháp tổng thể. Bạn cũng cần suy nghĩ về cách thu thập (ingest), xử lý và gửi tất cả dữ liệu đến RedisTimeSeries. Điều bạn thực sự cần là một đường ống dữ liệu có khả năng mở rộng, đóng vai trò bộ đệm để tách biệt producer và consumer.
Đó là lúc Apache Kafka xuất hiện! Ngoài core broker, Kafka có hệ sinh thái thành phần phong phú, bao gồm Kafka Connect (là một phần của kiến trúc giải pháp trong bài viết này), thư viện client đa ngôn ngữ, Kafka Streams, Mirror Maker, v.v.
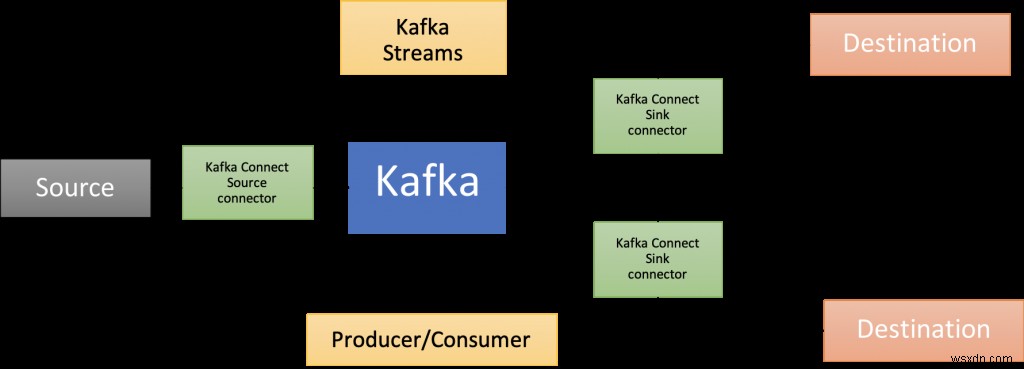
Bài viết này cung cấp ví dụ thực tế về cách sử dụng RedisTimeSeries với Apache Kafka để phân tích dữ liệu time-series.
Mã nguồn có sẵn tại GitHub repo: https://github.com/abhirockzz/redis-timeseries-kafka
Hãy bắt đầu bằng việc khám phá trường hợp sử dụng. Lưu ý rằng nó được giữ đơn giản cho mục đích bài viết và sẽ được giải thích chi tiết ở các phần sau.
Senario: Giám sát thiết bị
Hãy tưởng tượng có nhiều vị trí, mỗi vị trí có nhiều thiết bị, và bạn được giao nhiệm vụ giám sát các metric của thiết bị — hiện tại chúng ta xét nhiệt độ và áp suất. Các metric này sẽ được lưu trong RedisTimeSeries (tất nhiên!) và sử dụng quy ước đặt tên key: temp:5:1. Mỗi điểm dữ liệu time-series cũng có các Label (cap key-value) — metric, location, device. Điều này cho phép truy vấn linh hoạt như bạn sẽ thấy ở các phần sau.
Dưới đây là vài ví dụ minh họa cách thêm điểm dữ liệu bằng lệnh TS.ADD:
# nhiệt độ thiết bị 2 tại vị trí 3 kèm label:
TS.ADD temp:3:2 * 20 LABELS metric temp location 3 device 2
# áp suất thiết bị 2 tại vị trí 3:
TS.ADD pressure:3:2 * 60 LABELS metric pressure location 3 device 2
Kiến trúc giải pháp
Đây là hình dung tổng quan về giải pháp:
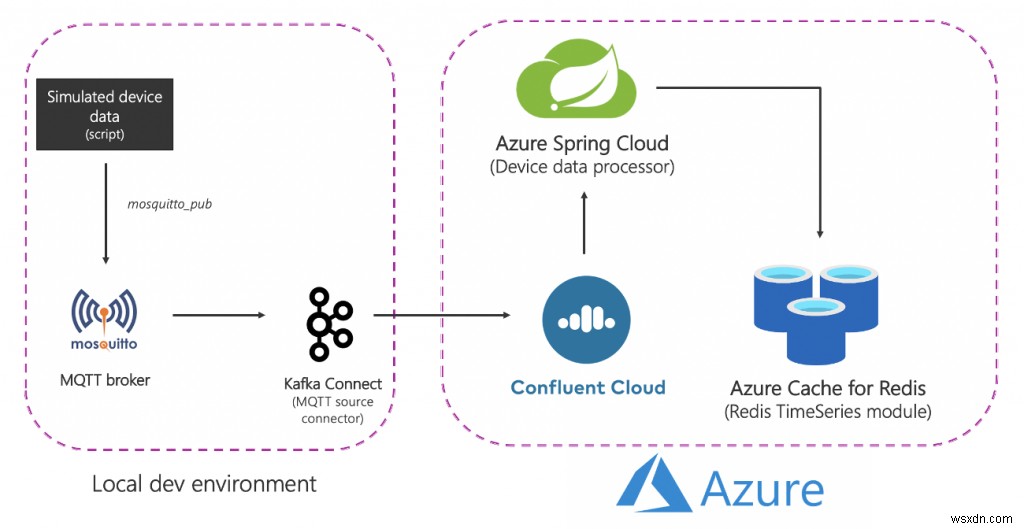
Phân tích chi tiết:
Các thành phần nguồn (local)
- MQTT broker (mosquitto): MQTT là giao thức事实上 chuẩn cho IoT. Senario chúng ta dùng là kết hợp IoT và Time Series — sẽ nói thêm sau.
- Kafka Connect: MQTT source connector dùng để chuyển dữ liệu từ MQTT broker đến Kafka cluster.
Các dịch vụ Azure
- Azure Cache for Redis Enterprise tiers: Các tier Enterprise dựa trên Redis Enterprise, biến thể thương mại của Redis từ Redis. Ngoài RedisTimeSeries, tier Enterprise còn hỗ trợ RediSearch và RedisBloom. Khách hàng không cần lo về cấp phép cho tier Enterprise. Azure Cache for Redis sẽ hỗ trợ quy trình này, khách hàng có thể lấy và trả phí giấy phép phần mềm này qua Azure Marketplace.
- Confluent Cloud on Azure: Dịch vụ hoàn toàn managed cung cấp Apache Kafka as a service, nhờ lớp provisioning tích hợp từ Azure đến Confluent Cloud. Giảm gánh nặng quản lý cross-platform và cung cấp trải nghiệm thống nhất để dùng Confluent Cloud trên hạ tầng Azure, giúp dễ dàng tích hợp với ứng dụng Azure.
- Azure Spring Cloud: Triển khai microservices Spring Boot lên Azure dễ dàng hơn nhờ Azure Spring Cloud. Dịch vụ này giảm bớt lo ngại hạ tầng, cung cấp quản lý cấu hình, service discovery, CI/CD integration, blue-green deployments, và nhiều hơn nữa. Dịch vụ lo phần nặng nề để developer tập trung vào code.
Lưu ý: một số dịch vụ được host local chỉ để đơn giản. Trong triển khai production, bạn sẽ muốn chạy chúng trên Azure. Ví dụ, bạn có thể vận hành Kafka Connect cluster cùng MQTT connector trên Azure Kubernetes Service.
Tóm lại, luồng end-to-end:
- Script tạo dữ liệu thiết bị giả lập gửi đến MQTT broker local.
- Dữ liệu được MQTT Kafka Connect source connector lấy và gửi đến topic trong Confluent Cloud Kafka cluster chạy trên Azure.
- Dữ liệu được xử lý thêm bởi ứng dụng Spring Boot host trên Azure Spring Cloud, sau đó lưu vào Azure Cache for Redis instance.
Đến phần thực hành! Trước đó, hãy đảm bảo bạn có:
Điều kiện tiên quyết:
- Tài khoản Azure — có thể đăng ký miễn phí tại đây
- Cài đặt Azure CLI
- JDK 11, ví dụ OpenJDK
- Phiên bản Maven và Git gần đây
Thiết lập các thành phần hạ tầng
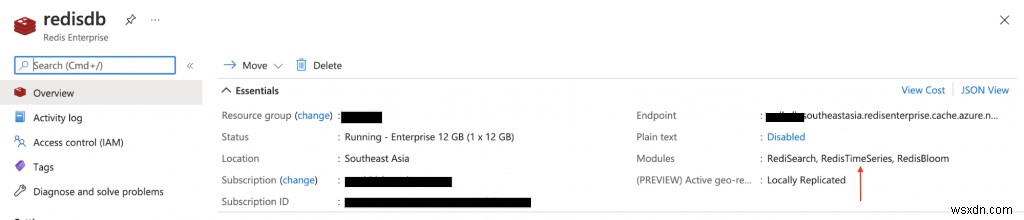
Làm theo tài liệu để provision Azure Cache for Redis (Enterprise Tier) kèm module RedisTimeSeries.
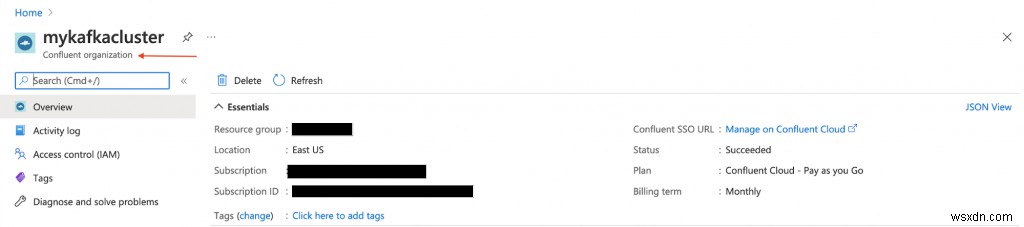
Provision Confluent Cloud cluster trên Azure Marketplace. Cũng tạo Kafka topic (dùng tên mqtt.device-stats) và tạo credentials (API key và secret) để kết nối an toàn sau này.
Bạn có thể provision Azure Spring Cloud instance qua Azure portal hoặc Azure CLI:
az spring-cloud create -n <tên Azure Spring Cloud service> -g <tên resource group> -l <location ví dụ southeastasia>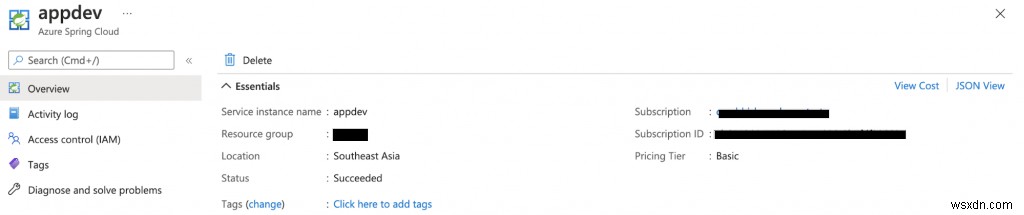
Trước khi tiếp tục, hãy clone GitHub repo:
git clone https://github.com/abhirockzz/redis-timeseries-kafka
cd redis-timeseries-kafka
Thiết lập dịch vụ local
Các thành phần bao gồm:
- Mosquitto MQTT broker
- Kafka Connect với MQTT source connector
- Grafana để theo dõi dữ liệu time-series trên dashboard
MQTT broker
Tôi cài đặt và khởi động mosquitto broker local trên Mac.
brew install mosquitto
brew services start mosquitto
Bạn có thể làm theo bước tương ứng cho OS của mình hoặc dùng Docker image này.
Grafana
Tôi cài đặt và khởi động Grafana local trên Mac.
brew install grafana
brew services start grafana
Bạn có thể làm tương tự cho OS của mình hoặc dùng Docker image:
docker run -d -p 3000:3000 --name=grafana -e "GF_INSTALL_PLUGINS=redis-datasource" grafana/grafanaKafka Connect
Bạn sẽ tìm thấy file connect-distributed.properties trong repo vừa clone. Thay thế giá trị cho các property như bootstrap.servers, sasl.jaas.config, v.v.
Trước tiên, tải và giải nén Apache Kafka local.
Khởi động Kafka Connect cluster local:
export KAFKA_INSTALL_DIR=<thư mục cài Kafka ví dụ /home/foo/kafka_2.12-2.5.0>
$KAFKA_INSTALL_DIR/bin/connect-distributed.sh connect-distributed.properties
Để cài MQTT source connector thủ công:
- Tải file ZIP connector/plugin từ link này, và
- Giải nén vào một trong các thư mục liệt kê trong plugin.path của Connect worker
Nếu bạn dùng Confluent Platform local, chỉ cần dùng Confluent Hub CLI: confluent-hub install confluentinc/kafka-connect-mqtt:latest
Tạo instance MQTT source connector
Kiểm tra file mqtt-source-config.json. Đảm bảo nhập đúng topic name cho kafka.topic và giữ mqtt.topics nguyên vẹn.
curl -X POST -H 'Content-Type: application/json' https://localhost:8083/connectors -d @mqtt-source-config.json
# đợi một phút trước khi kiểm tra trạng thái connector
curl https://localhost:8083/connectors/mqtt-source/status
Triển khai ứng dụng xử lý dữ liệu thiết bị
Trong GitHub repo vừa clone, tìm file application.yaml trong thư mục consumer/src/resources và thay thế giá trị cho:
- Azure Cache for Redis host, port và primary access key
- Confluent Cloud on Azure API key và secret
Build file JAR ứng dụng:
cd consumer
export JAVA_HOME=<đường dẫn tuyệt đối ví dụ /Library/Java/JavaVirtualMachines/zulu-11.jdk/Contents/Home>
mvn clean package
Tạo ứng dụng Azure Spring Cloud và deploy file JAR:
az spring-cloud app create -n device-data-processor -s <tên Azure Spring Cloud instance> -g <tên resource group> --runtime-version Java_11
az spring-cloud app deploy -n device-data-processor -s <tên Azure Spring Cloud instance> -g <tên resource group> --jar-path target/device-data-processor-0.0.1-SNAPSHOT.jar
Khởi động generator dữ liệu thiết bị giả lập
Bạn có thể dùng script trong GitHub repo vừa clone:
./gen-timeseries-data.shLưu ý — script chỉ dùng lệnh mosquitto_pub CLI để gửi dữ liệu.
Dữ liệu gửi đến MQTT topic device-stats (đây không phải Kafka topic). Bạn có thể kiểm tra bằng CLI subscriber:
mosquitto_sub -h localhost -t device-statsKiểm tra Kafka topic trên Confluent Cloud portal. Cũng kiểm tra log của device data processor app trên Azure Spring Cloud:
az spring-cloud app logs -f -n device-data-processor -s <tên Azure Spring Cloud instance> -g <tên resource group>Tận hưởng dashboard Grafana!
Truy cập Grafana UI tại localhost:3000.
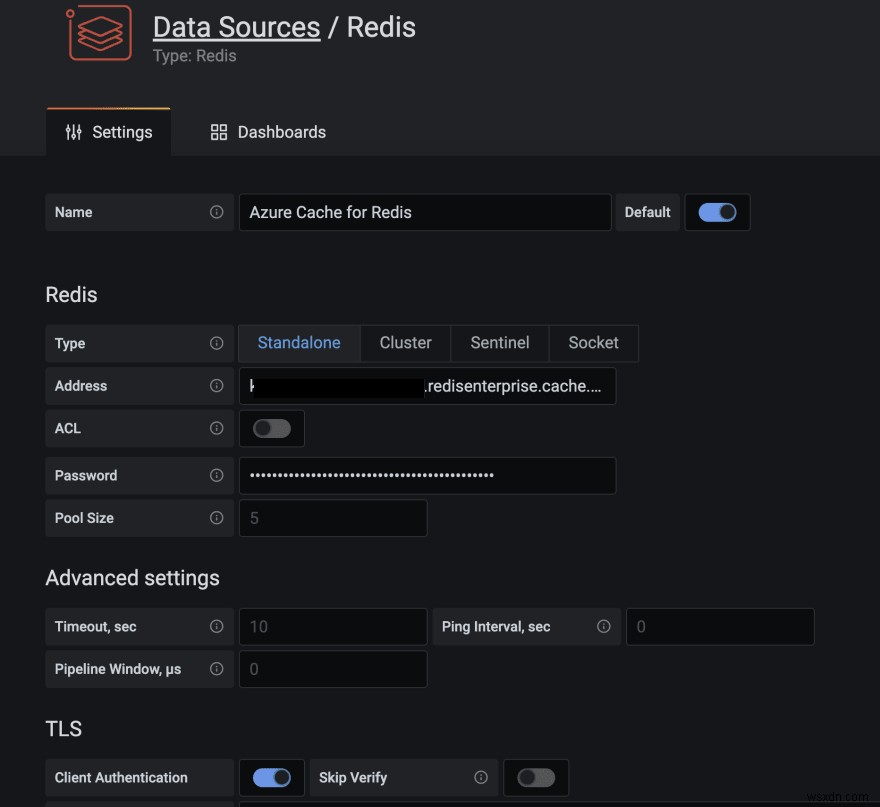
Redis Data Source plugin cho Grafana hoạt động với bất kỳ database Redis nào, bao gồm Azure Cache for Redis. Làm theo hướng dẫn trong bài viết này để cấu hình data source.
Import các dashboard trong thư mục grafana_dashboards trong GitHub repo đã clone (tham khảo tài liệu Grafana nếu cần hỗ trợ import dashboard).
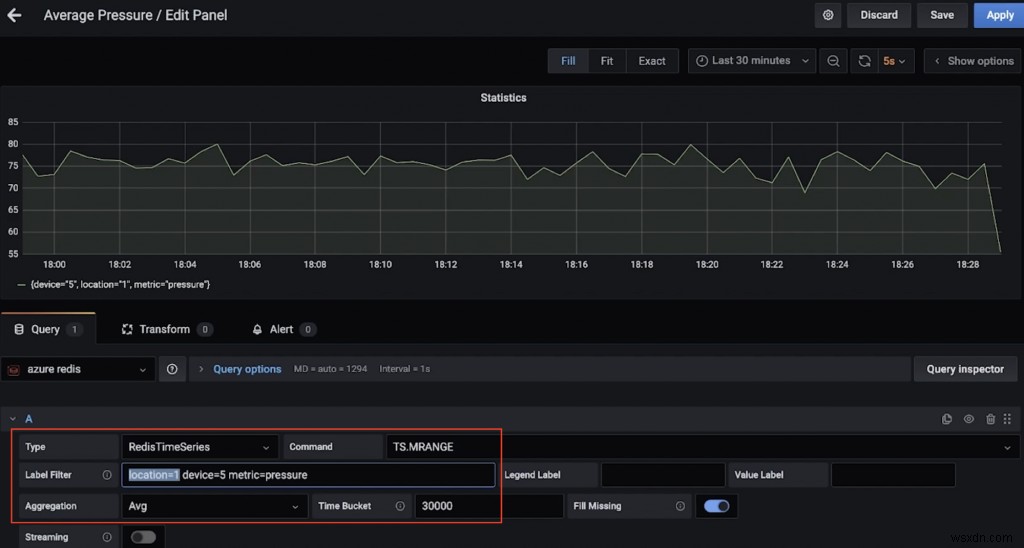
Ví dụ, đây là dashboard hiển thị áp suất trung bình (trên 30 giây) cho thiết bị 5 tại vị trí 1 (dùng TS.MRANGE).
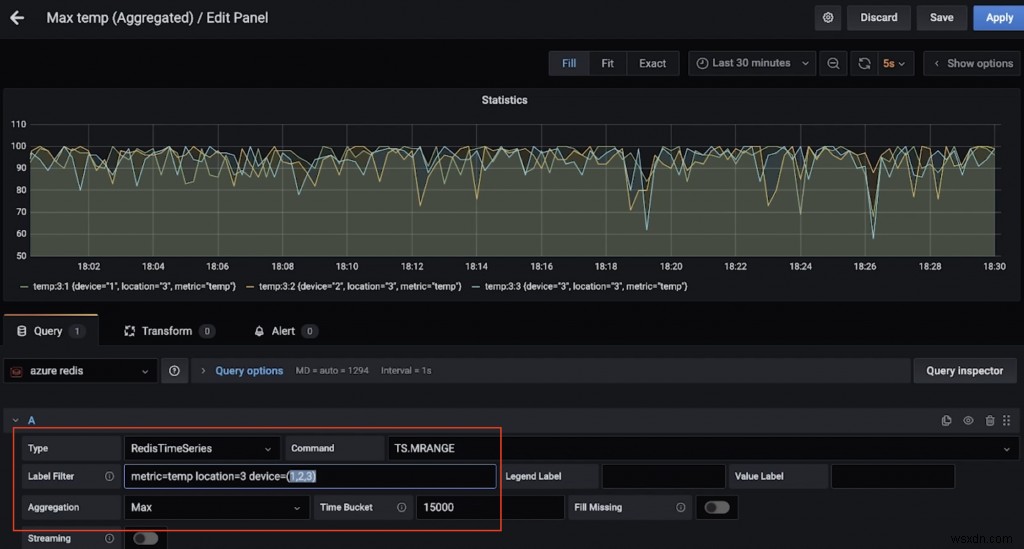
Đây là dashboard khác hiển thị nhiệt độ tối đa (trên 15 giây) cho nhiều thiết bị tại vị trí 3 (lại nhờ TS.MRANGE).
Muốn chạy một số lệnh RedisTimeSeries?
Khởi động redis-cli và kết nối đến Azure Cache for Redis instance:
redis-cli -h <azure redis hostname ví dụ myredis.southeastasia.redisenterprise.cache.azure.net> -p 10000 -a <azure redis access key> --tlsBắt đầu với truy vấn đơn giản:
# áp suất thiết bị 5 vị trí 1
TS.GET pressure:1:5
# nhiệt độ thiết bị 5 vị trí 4
TS.GET temp:4:5
Lọc theo vị trí và lấy nhiệt độ, áp suất cho tất cả thiết bị:
TS.MGET WITHLABELS FILTER location=3Trích xuất nhiệt độ và áp suất cho tất cả thiết bị tại một hoặc nhiều vị trí trong khoảng thời gian cụ thể:
TS.MRANGE - + WITHLABELS FILTER location=3
TS.MRANGE - + WITHLABELS FILTER location=(3,5)
– + nghĩa là mọi thứ từ đầu đến timestamp mới nhất, nhưng bạn có thể cụ thể hơn.
MRANGE là thứ chúng ta cần! Chúng ta cũng có thể lọc theo thiết bị cụ thể tại một vị trí và đi sâu hơn theo nhiệt độ hoặc áp suất:
TS.MRANGE - + WITHLABELS FILTER location=3 device=2
TS.MRANGE - + WITHLABELS FILTER location=3 metric=temp
TS.MRANGE - + WITHLABELS FILTER location=3 device=2 metric=temp
Tất cả có thể kết hợp với aggregations.
# tất cả điểm dữ liệu temp không hữu ích. làm sao về trung bình (hoặc max) thay vì mọi điểm?
TS.MRANGE - + WITHLABELS AGGREGATION avg 10000 FILTER location=3 metric=temp
TS.MRANGE - + WITHLABELS AGGREGATION max 10000 FILTER location=3 metric=temp
Cũng có thể tạo rule để làm aggregation này và lưu vào time series khác.
Khi xong, đừng quên xóa tài nguyên để tránh chi phí không mong muốn.
Xóa tài nguyên
- Làm theo tài liệu để xóa Confluent Cloud cluster — chỉ cần xóa Confluent organization.
- Tương tự, xóa Azure Cache for Redis instance.
Trên máy local:
- Dừng Kafka Connect cluster
- Dừng mosquito broker (ví dụ: brew services stop mosquito)
- Dừng Grafana service (ví dụ: brew services stop grafana)
Chúng ta đã khám phá đường ống dữ liệu để ingest, xử lý và truy vấn dữ liệu time-series dùng Redis và Kafka. Khi suy nghĩ về bước tiếp theo và chuyển sang giải pháp production-grade, bạn nên cân nhắc thêm vài điều.
Các cân nhắc bổ sung
Tối ưu hóa RedisTimeSeries
- Retention policy: Cân nhắc kỹ vì điểm dữ liệu time-series không bị trim hoặc xóa mặc định.
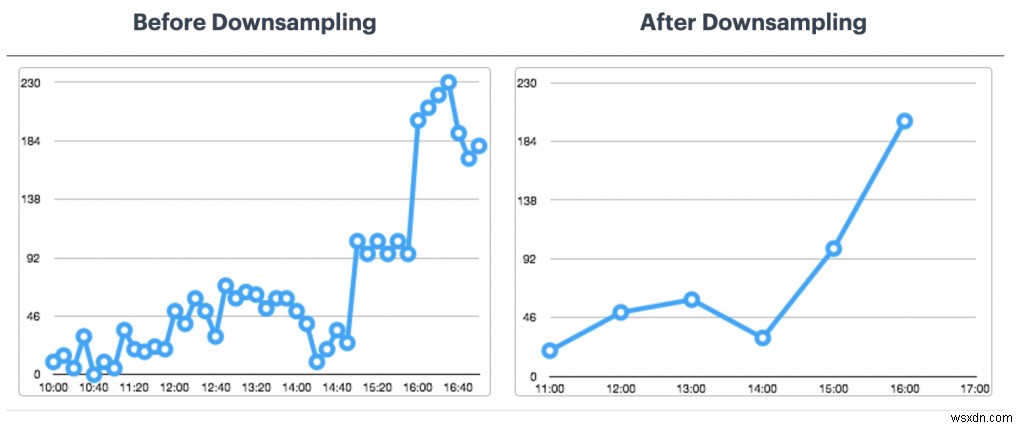
- Down-sampling và Aggregation Rules: Bạn không muốn lưu dữ liệu mãi mãi, phải không? Hãy cấu hình rule phù hợp (ví dụ:
TS.CREATERULE temp:1:2 temp:avg:30 AGGREGATION avg 30000). - Duplicate data policy: Bạn muốn xử lý sample trùng lặp như thế nào? Đảm bảo policy mặc định (BLOCK) đúng với nhu cầu. Nếu không, cân nhắc các tùy chọn khác.
Đây không phải danh sách đầy đủ. Với các tùy chọn cấu hình khác, tham khảo tài liệu RedisTimeSeries.
Làm sao về lưu trữ dữ liệu dài hạn?
Dữ liệu là quý giá, bao gồm time series! Bạn có thể muốn xử lý thêm (ví dụ: chạy machine learning để trích xuất insight, predictive maintenance, v.v.). Để làm được điều này, bạn cần giữ dữ liệu lâu hơn, và để hiệu quả về chi phí, bạn muốn dùng scalable object storage như Azure Data Lake Storage Gen2 (ADLS Gen2).
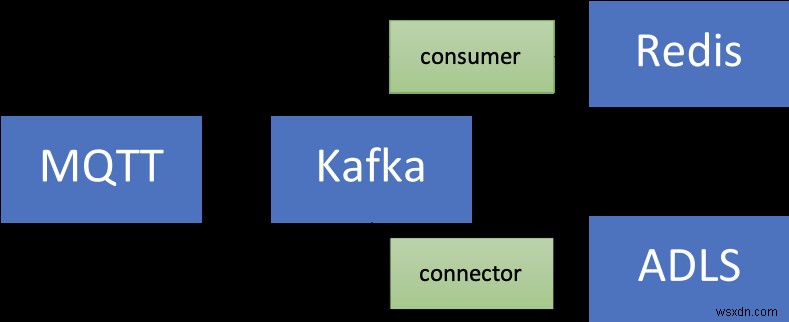
Có connector cho việc này! Bạn có thể mở rộng đường ống dữ liệu hiện tại bằng cách dùng Azure Data Lake Storage Gen2 Sink Connector fully-managed cho Confluent Cloud để xử lý và lưu dữ liệu vào ADLS, sau đó chạy machine learning dùng Azure Synapse Analytics hoặc Azure Databricks.
Khả năng mở rộng
Dung lượng dữ liệu time-series chỉ đi một chiều — lên! Giải pháp phải scalable:
- Hạ tầng cốt lõi: Managed services giúp team tập trung vào giải pháp thay vì setup và maintain hạ tầng, đặc biệt với hệ phân tán phức tạp như database và streaming platform (Redis, Kafka).
- Kafka Connect: Về đường ống dữ liệu, bạn an tâm vì Kafka Connect inherently stateless và horizontally scalable. Bạn có nhiều tùy chọn về kiến trúc và sizing Kafka Connect worker clusters.
- Ứng dụng custom: Như trong giải pháp này, chúng ta xây dựng custom app xử lý data trong Kafka topics. May mắn là cùng đặc tính scalability cũng áp dụng. Về scale ngang, chỉ bị giới hạn bởi số partition của Kafka topic.
Tích hợp: Không chỉ Grafana! RedisTimeSeries cũng tích hợp với Prometheus và Telegraf. Tuy nhiên, tại thời điểm viết bài, chưa có Kafka connector — đây sẽ là add-on tuyệt vời!
Kết luận
Chắc chắn, bạn có thể dùng Redis cho (gần như) mọi thứ, bao gồm workload time-series! Hãy suy nghĩ về kiến trúc end-to-end cho đường ống dữ liệu và tích hợp từ nguồn time-series, một đường đến Redis và आगे.