
Excel là một trong những công cụ mạnh nhất cho phân tích dữ liệu, nhưng nó có giới hạn. Khi tập dữ liệu tăng lên hàng triệu hàng, khi báo cáo cần chạy tự động, hoặc khi phân tích yêu cầu machine learning, Excel đơn lẻ bắt đầu lộ rõ tuổi tác. Python lấp đầy nhiều khoảng trống này. Việc tích hợp Python đã biến Excel từ công cụ bảng tính truyền thống thành nền tảng phân tích dữ liệu mạnh mẽ hơn. Với Python có sẵn trực tiếp trong Excel, các nhà phân tích giờ có thể thực hiện tính toán nâng cao, xây dựng mô hình dự báo và tạo trực quan hóa tinh vi mà không rời workbook.
Trong hướng dẫn này, chúng tôi sẽ giới thiệu năm thư viện Python cho phân tích dữ liệu Excel nâng cao mà mọi chuyên gia nên dùng. Các thư viện này cho phép bạn thao tác dữ liệu nâng cao, trực quan hóa và machine learning trực tiếp trong Excel.
1. Pandas – Cốt Lõi Cho Thao Tác Và Phân Tích Dữ Liệu
Nếu bạn chỉ học một thư viện Python cho phân tích Excel, hãy học Pandas trước. Pandas là nền tảng cho hầu như mọi tác vụ Excel nâng cao trong Python. Nó biến dữ liệu Excel thành DataFrames mạnh mẽ để làm sạch, chuyển đổi, lọc, nhóm, hợp nhất, tổng hợp và khám phá tập dữ liệu lớn hiệu quả.
Điểm Mạnh Chính Cho Chuyên Gia Excel:
- Đọc và ghi file Excel gốc với pd.read_excel() và df.to_excel()
- Xử lý dữ liệu lộn xộn: xóa trùng lặp, điền giá trị thiếu, chuẩn hóa định dạng
- Thực hiện nhóm và tổng hợp nâng cao với logic vượt quá PivotTables
- Hợp nhất hoặc join nhiều trang hoặc file
- Tạo tóm tắt thống kê với df.describe()
- Chạy vài dòng mã và nhận cùng kết quả mỗi lần
Ví Dụ: Làm Sạch Dữ Liệu Lộn Xộn
Một đau đầu thường gặp trong Excel là nhận dữ liệu với kiểu hỗn hợp, giá trị thiếu và định dạng không nhất quán. Với Pandas, bạn sửa mọi thứ trong một kịch bản có thể lặp lại.
Python Trong Excel:
import pandas as pd df = xl("A1:J10000", headers=True) # Làm sạch: xóa khoảng trắng, chuyển kiểu, điền thiếu df['Category'] = df['Category'].str.strip() df['Revenue'] = df['Units'] * df['UnitPrice'].fillna(0) # Tóm tắt nâng cao: nhóm theo Region và Category summary = df.groupby(['Region', 'Category']).agg({ 'Revenue': 'sum', 'Units': 'sum' }).reset_index() summary 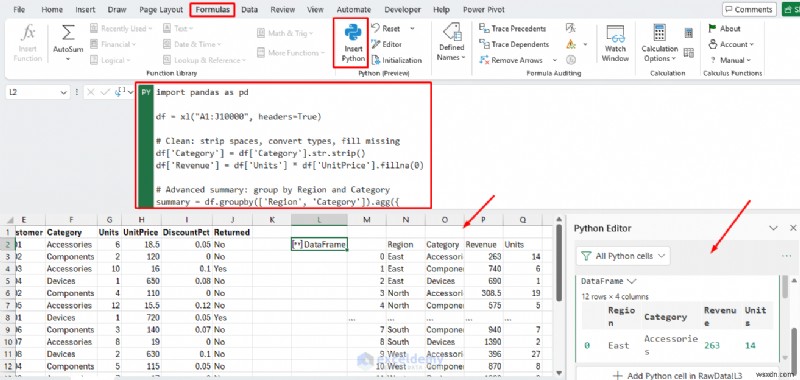
Python Trong VS Code:
import pandas as pd file_path = 'SalesData.xlsx' df = pd.read_excel(file_path, sheet_name='RawData') # Sửa kiểu cột — xử lý số lưu dưới dạng văn bản df['Units'] = pd.to_numeric(df['Units'], errors='coerce').fillna(0).astype(int) df['UnitPrice'] = pd.to_numeric(df['UnitPrice'], errors='coerce').fillna(0.0) df['DiscountPct'] = pd.to_numeric(df['DiscountPct'], errors='coerce').fillna(0.0) # Chuẩn hóa cột boolean dạng văn bản df['Returned'] = df['Returned'].astype(str).str.strip().str.lower() \ .map({'yes': True, 'no': False}).fillna(False) # Thêm cột tính toán df['Revenue'] = df['Units'] * df['UnitPrice'] df['NetRevenue'] = df['Revenue'] * (1 - df['DiscountPct']) # Ghi lại thành trang mới — dữ liệu gốc không đổi with pd.ExcelWriter(file_path, engine='openpyxl', mode='a', if_sheet_exists='replace') as writer: df.to_excel(writer, sheet_name='CleanData', index=False) print('Trang CleanData đã tạo trong', file_path) 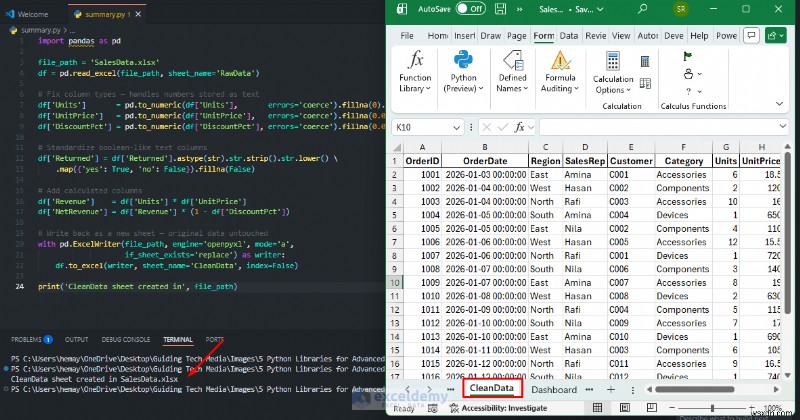
Tự Động Hóa Báo Cáo Tóm Tắt
Thay thế PivotTable thủ công bằng quy trình groupby Pandas chạy trong giây và xuất trang sẵn sàng chia sẻ mỗi khi dữ liệu cập nhật:
summary = ( df.groupby(['Region', 'Category'], as_index=False) .agg( Orders = ('OrderID', 'count'), Units = ('Units', 'sum'), NetRevenue = ('NetRevenue', 'sum'), Returns = ('Returned', 'sum') ) ) with pd.ExcelWriter(file_path, engine='openpyxl', mode='a', if_sheet_exists='replace') as writer: summary.to_excel(writer, sheet_name='Summary', index=False) 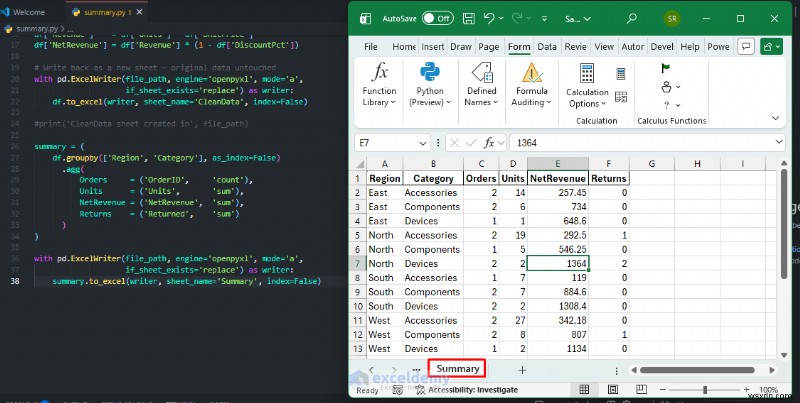
Khi Nào Dùng: Bạn có đầu ra kiểu PivotTable, nhưng làm sạch và logic xảy ra trong cùng quy trình. Nghĩa là ít báo cáo hỏng hơn và ít can thiệp thủ công hơn. Người dùng nâng cao dùng Pandas xử lý tập dữ liệu quá lớn hoặc phức tạp cho Excel gốc, đặc biệt khi tập dữ liệu vượt quá vài nghìn hàng, khi cần lặp lại bước làm sạch/tóm tắt, hoặc khi cần hợp nhất dữ liệu từ nhiều nguồn tự động.
2. OpenPyXL – Thao Tác File Excel Nâng Cao Và Định Dạng Gốc
Trong khi Pandas xử lý dữ liệu, OpenPyXL xuất sắc ở kiểm soát tinh vi file .xlsx: định dạng ô, thêm biểu đồ, bảng, kiểu, công thức và hình ảnh mà không mất tính năng Excel gốc. Nó cho phép làm việc trực tiếp với file .xlsx, nên quy trình Python có thể tạo đầu ra sẵn sàng Excel thay vì chỉ phân tích thô.
Điểm Mạnh Chính Cho Chuyên Gia Excel:
- Tạo và sửa workbook theo chương trình
- Xuất bảng đã làm sạch vào trang mới
- Thêm biểu đồ chuyên nghiệp trực tiếp dạng Excel tự cập nhật
- Thay thế trang báo cáo cũ tự động
- Áp dụng định dạng có điều kiện, viền, font, kiểu cho ô cụ thể
- Chèn công thức Excel như =SUM() hoặc =VLOOKUP() vào ô
- Bảo vệ trang, đóng khung, đặt độ rộng cột theo chương trình
- Xây dựng deliverable dựa trên workbook cho người không dùng Python
Ví Dụ: Thêm Biểu Đồ Gốc Vào Workbook
Sau khi tạo dữ liệu sạch với Pandas, dùng openpyxl thêm biểu đồ cột chuyên nghiệp mà không mở Excel thủ công.
from openpyxl import load_workbook from openpyxl.chart import BarChart, Reference import pandas as pd file_path = 'SalesData.xlsx' df = pd.read_excel(file_path, sheet_name='CleanData') chart_data = df.groupby('Region', as_index=False)['NetRevenue'] \ .sum().sort_values('NetRevenue', ascending=False) with pd.ExcelWriter(file_path, engine='openpyxl', mode='a', if_sheet_exists='replace') as writer: chart_data.to_excel(writer, sheet_name='RegionChart', index=False) wb = load_workbook(file_path) ws = wb['RegionChart'] chart = BarChart() chart.title = 'Doanh Thu Ròng Theo Khu Vực' chart.y_axis.title = 'Doanh Thu Ròng ($)' chart.x_axis.title = 'Khu Vực' values = Reference(ws, min_col=2, min_row=1, max_row=ws.max_row) labels = Reference(ws, min_col=1, min_row=2, max_row=ws.max_row) chart.add_data(values, titles_from_data=True) chart.set_categories(labels) ws.add_chart(chart, 'D2') wb.save(file_path) 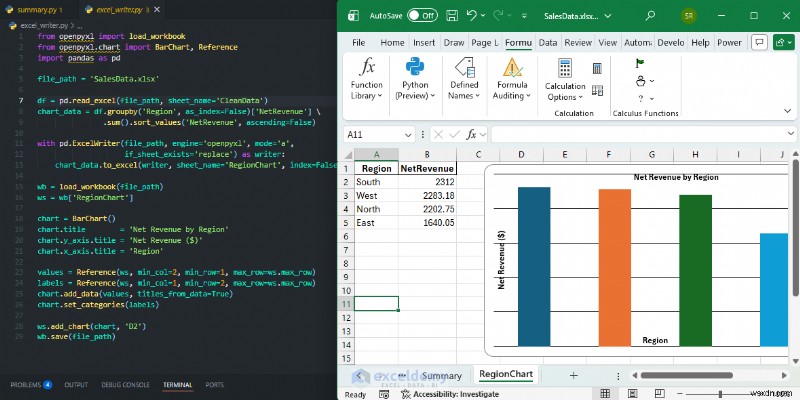
Khi Nào Dùng: Pandas giúp bạn phân tích dữ liệu. openpyxl giúp bạn giao hàng. Dùng OpenPyXL khi cần đầu ra Excel pixel-perfect như báo cáo và dashboard trông như thủ công, và khi kết quả cần sống trong file .xlsx với biểu đồ và định dạng Excel gốc mà đồng nghiệp có thể tiếp tục chỉnh sửa.
3. Matplotlib – Trực Quan Hóa Mạnh Mẽ Vượt Biểu Đồ Excel
Biểu đồ Excel tiện lợi, nhưng Matplotlib cho nhà phân tích nhiều quyền kiểm soát hơn. Matplotlib là thư viện đầu choice để tạo biểu đồ tĩnh chất lượng xuất bản. Nó tùy biến cao và tích hợp tốt với Pandas để phân tích khám phá nhanh.
Điểm Mạnh Chính Cho Chuyên Gia Excel:
- Tạo biểu đồ nâng cao như heatmap, scatter plot với trendline, box plot, histogram, biểu đồ 3D
- Kiểm soát nhiều hơn font, màu, lưới, tick mark, chú thích
- Xây dựng bố cục subplot nhiều panel hiển thị nhiều biểu đồ cùng lúc
- Xuất ra hình ảnh, PDF, SVG, hoặc nhúng trực quan trở lại Excel với OpenPyXL
- Chú thích điểm dữ liệu với nhãn và mũi tên tùy chỉnh
Ví Dụ: Tạo Dashboard Bán Hàng Nhiều Panel
Hãy tạo biểu đồ hai panel: xu hướng doanh thu tháng bên trái và phân tích danh mục bên phải. Sau đó lưu dưới dạng hình ảnh độ phân giải cao, sẵn sàng cho báo cáo.
import pandas as pd import matplotlib.pyplot as plt import matplotlib.ticker as mticker df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') df['Month'] = pd.to_datetime(df['OrderDate']).dt.to_period('M') monthly = df.groupby('Month')['NetRevenue'].sum() cat_rev = df.groupby('Category')['NetRevenue'].sum().sort_values(ascending=True) fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(14, 6)) fig.suptitle('Dashboard Hiệu Suất Bán Hàng', fontsize=16, fontweight='bold') # Panel trái — biểu đồ đường doanh thu tháng ax1.plot(list(monthly.index.astype(str)), monthly.values, marker='o', color='#1E5FAD', linewidth=2) ax1.set_title('Doanh Thu Ròng Hàng Tháng') ax1.set_xlabel('Tháng') ax1.set_ylabel('Doanh Thu ($)') ax1.yaxis.set_major_formatter(mticker.FuncFormatter(lambda x, _: f'${x:,.0f}')) ax1.tick_params(axis='x', rotation=45) ax1.grid(axis='y', linestyle='--', alpha=0.5) # Panel phải — biểu đồ cột ngang doanh thu theo danh mục ax2.barh(cat_rev.index, cat_rev.values, color='#217346') ax2.set_title('Doanh Thu Theo Danh Mục') ax2.set_xlabel('Doanh Thu ($)') ax2.xaxis.set_major_formatter(mticker.FuncFormatter(lambda x, _: f'${x:,.0f}')) plt.tight_layout() plt.savefig('sales_dashboard.png', dpi=150, bbox_inches='tight') print('Dashboard đã lưu as sales_dashboard.png') 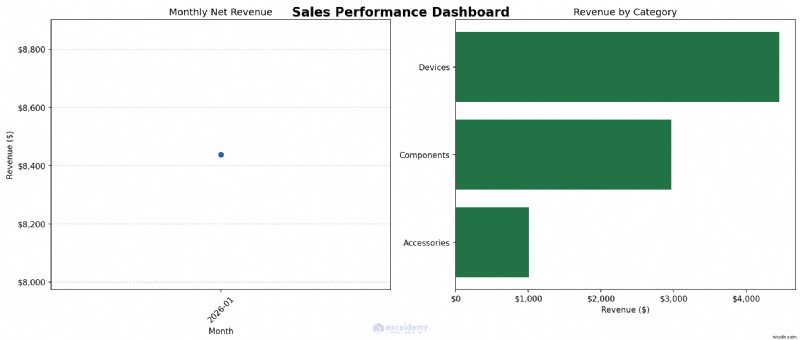
Khi Nào Dùng: Dùng Python tạo biểu đồ phân tích trước. Sau đó quyết định biểu đồ nên giữ là đầu ra Python hay dữ liệu tóm tắt nên trả về Excel để định dạng dashboard cuối. Dùng Matplotlib khi cần biểu đồ cho báo cáo/trình bày, hoặc khi cần tạo cùng biểu đồ lặp lại từ dữ liệu cập nhật với kiểu nhất quán.
4. Seaborn – Trực Quan Hóa Dữ Liệu Thống Kê
Seaborn xây dựng trên Matplotlib và tập trung vào trực quan hóa thống kê. Nó đơn giản hóa việc tạo biểu đồ hấp thị nhấn mạnh mẫu và tương quan. Nơi Matplotlib có thể cần chục dòng cho biểu đồ đẹp, Seaborn thường đạt kết quả tương tự trong một hai dòng với kiểu mặc định đẹp. Nó xuất sắc ở tiết lộ phân phối, tương quan và mẫu ẩn trong dữ liệu.
Điểm Mạnh Chính Cho Chuyên Gia Excel:
- Tạo biểu đồ thống kê nhanh
- Hoạt động tốt cho phân tích khám phá dữ liệu
- Xây dựng heatmap tương quan xem cột liên quan nhau như thế nào
- Tạo biểu đồ phân phối với đường mật độ tích hợp
- Dùng box plot và violin plot so sánh nhóm trực quan
- Tạo pair plot cho ma trận scatterplot tự động trên cột số
- Tạo biểu đồ hồi quy với khoảng tin cậy trong một dòng
Ví Dụ: Tạo Heatmap Tương Quan
Tìm mẫu ẩn trong dữ liệu Excel: biến nào chuyển động cùng nhau? Heatmap trả lời nhanh và vượt xa công cụ tích hợp Excel thường cung cấp.
import pandas as pd import seaborn as sns import matplotlib.pyplot as plt df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') correlation = df.select_dtypes(include='number').corr() plt.figure(figsize=(10, 8)) sns.heatmap( correlation, annot=True, # hiển thị giá trị tương quan trong ô fmt='.2f', cmap='coolwarm', # đỏ = dương, xanh = âm center=0, square=True, linewidths=0.5 ) plt.title('Ma Trận Tương Quan — Biến Bán Hàng', fontsize=14, fontweight='bold') plt.tight_layout() plt.savefig('correlation_heatmap.png', dpi=150) print('Heatmap đã lưu!') 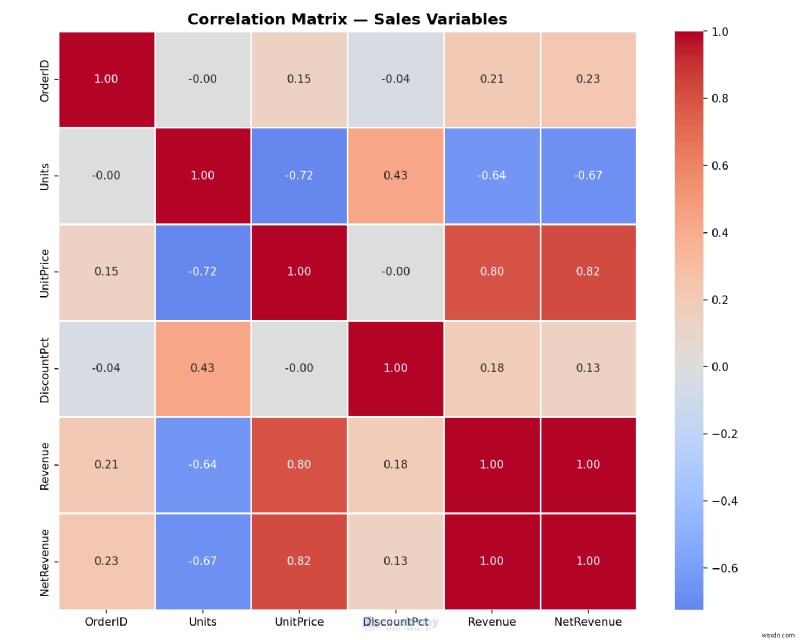
Ví Dụ: Tạo Box Plot Trong Một Dòng
So sánh phân phối doanh thu trên khu vực để phát hiện ngoại lai tức thì.
plt.figure(figsize=(10, 6)) sns.boxplot(data=df, x='Region', y='NetRevenue', hue='Region', palette='Set2', legend=False) plt.title('Phân Phối Doanh Thu Theo Khu Vực') plt.ylabel('Doanh Thu Ròng ($)') plt.tight_layout() plt.savefig('region_boxplot.png', dpi=150) 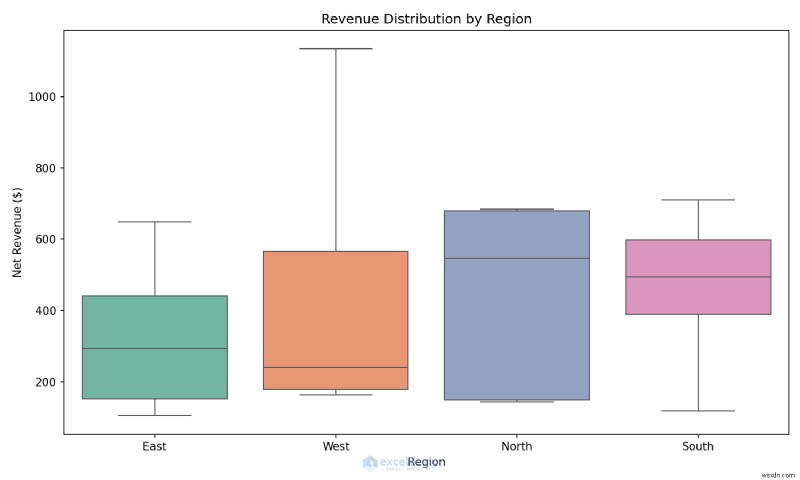
Khi Nào Dùng: Dùng Seaborn trong phân tích khám phá khi muốn nhanh hiểu phân phối, ngoại lai và quan hệ trước khi xây dựng báo cáo chính thức.
5. Scikit-learn – Machine Learning Trực Tiếp Trên Dữ Liệu Excel
Đây là thư viện đưa bạn từ báo cáo sang hỗ trợ quyết định. Scikit-learn mang machine learning chuyên nghiệp vào quy trình Excel. Nó cho phép phân tích dự báo cho người dùng Excel, bao gồm hồi quy, phân loại, phân cụm và dự báo mà Excel gốc khó xử lý. Thay vì chỉ mô tả chuyện đã xảy ra trong dữ liệu, nó giúp dự đoán chuyện có thể xảy ra tiếp, từ dự báo bán hàng đến phân loại khách hàng đến phát hiện bất thường.
Điểm Mạnh Chính Cho Chuyên Gia Excel:
- Hồi quy tuyến tính và logistic dự đoán kết quả số hoặc danh mục như rủi ro rời bỏ hoặc dự báo bán hàng
- Cây quyết định và rừng ngẫu nhiên cho dự đoán có thể giải thích
- K-means clustering nhóm bản ghi tương tự tự động
- Chia train-test và cross-validation đo độ chính xác mô hình
- Tiền xử lý: scaling, encoding, pipeline
- Trả dự đoán về Excel để lọc và sắp xếp
Ví Dụ: Dự Đoán Doanh Thu Ròng
Huấn luyện mô hình trên dữ liệu bán hàng lịch sử, sau đó dùng dự đoán doanh thu cho đơn hàng mới — phân tích Excel không làm gốc.
import pandas as pd from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestRegressor from sklearn.metrics import mean_absolute_error, r2_score from sklearn.preprocessing import LabelEncoder df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') # Mã hóa cột danh mục thành số for col in ['Region', 'Category', 'SalesRep']: if col in df.columns: df[col] = LabelEncoder().fit_transform(df[col].astype(str)) X = df[['Units', 'UnitPrice', 'DiscountPct', 'Region', 'Category']] y = df['NetRevenue'] # Chia: 80% train, 20% test X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.2, random_state=42 ) # Huấn luyện mô hình Random Forest model = RandomForestRegressor(n_estimators=100, random_state=42) model.fit(X_train, y_train) # Đánh giá độ chính xác predictions = model.predict(X_test) print(f'Mean Absolute Error: ${mean_absolute_error(y_test, predictions):,.2f}') print(f'R² Score: {r2_score(y_test, predictions):.4f}') # Xuất dự đoán về Excel results = X_test.copy() results['Actual'] = y_test.values results['Predicted'] = predictions results.to_excel('predictions.xlsx', index=False) print('Dự đoán đã xuất ra predictions.xlsx') 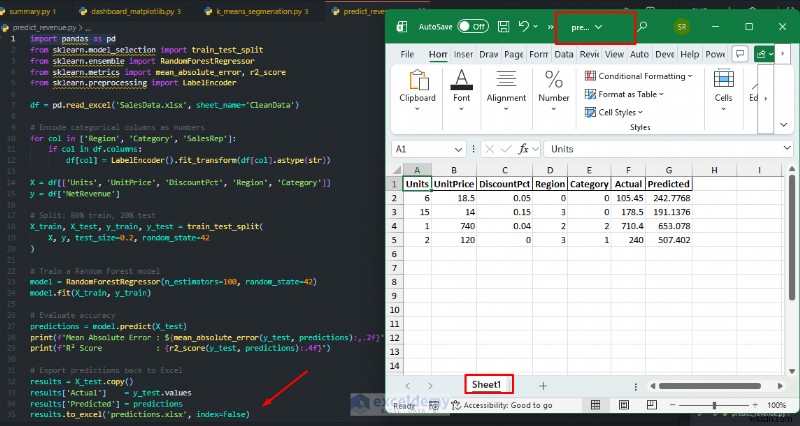
Phân Khúc Khách Hàng K-Means:
Tự động phân đoạn khách hàng thành nhóm dựa trên hành vi mua, không cần tiêu chí thủ công.
import pandas as pd from sklearn.cluster import KMeans from sklearn.preprocessing import StandardScaler df = pd.read_excel('SalesData.xlsx', sheet_name='CleanData') customer = df.groupby('Customer').agg( TotalOrders = ('OrderID', 'count'), TotalRevenue = ('NetRevenue', 'sum'), AvgDiscount = ('DiscountPct', 'mean') ).reset_index() X_scaled = StandardScaler().fit_transform( customer[['TotalOrders', 'TotalRevenue', 'AvgDiscount']] ) customer['Segment'] = KMeans(n_clusters=3, random_state=42, n_init=10) \ .fit_predict(X_scaled) customer.to_excel('customer_segments.xlsx', index=False) print('Phân đoạn hoàn tất! Xem customer_segments.xlsx') 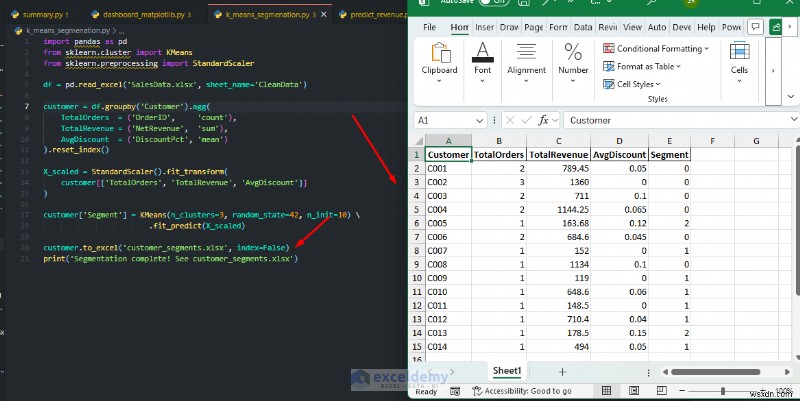
Khi Nào Dùng: Bạn có thể ghi dự đoán trở lại trang tính, sau đó người dùng Excel lọc, sắp xếp, biểu đồ hoặc kết hợp kết quả với công thức và định dạng có điều kiện. Điều này cho phép chuyên gia thêm insight machine learning trực tiếp vào bảng tính. Dùng Scikit-learn khi cần dự báo giá trị tương lai, phân loại bản ghi hoặc khám phá nhóm tự nhiên mà PivotTable không tiết lộ.
Thưởng: Xlwings – Tự Động Hai Chiều Và Tích Hợp Excel Trực Tiếp
Thư viện xlwings chạy thực thể Excel theo thời gian thực. Nó cầu nối Python và Excel, cho phép tự động hóa thực sự. Trong khi openpyxl đọc/ghi file tĩnh, xlwings có thể mở Excel, thao tác trực tiếp, đọc giá trị về Python, kích hoạt hàm Python từ nút Excel, và xây dựng UDF (hàm do người dùng định nghĩa) xuất hiện trong ô. Đây là giải pháp hiện đại thay thế nhiều quy trình VBA.
Điểm Mạnh Chính Cho Chuyên Gia Excel:
- Điều khiển phiên Excel trực tiếp: mở, đọc, ghi, đóng workbook theo chương trình
- Viết hàm Python gọi trực tiếp từ ô Excel như UDF
- Tự động hóa tác vụ lặp như làm mới dữ liệu và tạo báo cáo
- Đẩy Pandas DataFrame và biểu đồ Matplotlib trực tiếp vào named range
- Chạy script Python được kích hoạt bởi nút Excel
- Hoạt động trên cả Windows và macOS
- Là thay thế mạnh hoặc bổ sung cho Python trong Excel cho quy trình desktop
Bạn có thể dùng xlwings khi cần tương tác hai chiều trực tiếp với Excel, khi thay thế macro VBA, khi xây dựng dashboard tương tác, hoặc khi cho phép đồng nghiệp không kỹ thuật kích hoạt phân tích Python bằng click nút.
Chọn Stack Thư Viện Tốt Nhất Cho Các Loại Chuyên Gia Excel
Không phải nhà phân tích nào cũng cần cả năm thư viện cùng lúc. Cách thực tế áp dụng là theo vai trò.
- Cho Nhà Phân Tích Báo Cáo: Kết hợp này cho bạn làm sạch dữ liệu, tạo tóm tắt, sinh biểu đồ, xuất workbook đẹp.
- Pandas
- Matplotlib
- Openpyxl
- Cho Nhà Phân Tích Tài Chính Và Vận Hành: Stack này phù hợp mô hình, tính KPI, phân bổ, báo cáo hàng tháng lặp lại.
- Pandas
- Seaborn
- Openpyxl
- Cho Nhóm Phân Tích Nâng Cao: Kết hợp này cho đường ống đầy đủ từ chuẩn bị dữ liệu đến chấm điểm dự báo đến giao workbook.
- Pandas
- Matplotlib
- Scikit-learn
- Openpyxl
- Seaborn
Tổng Kết
Đây là năm thư viện Python cho phân tích dữ liệu Excel nâng cao mà mọi chuyên gia nên dùng. Làm chủ các công cụ này, bạn có thể biến Excel từ ứng dụng bảng tính đơn giản thành nền tảng phân tích mạnh mẽ hơn. Lộ trình học hợp lý: bắt đầu Pandas, thêm openpyxl, học Matplotlib và Seaborn cùng lúc, rồi đối phó Scikit-learn. Mỗi thư viện làm việc với cùng file .xlsx bạn đã dùng. Bắt đầu khám phá để trở thành nhà phân tích dữ liệu mạnh hơn.
Nhận Bài Tập Excel Nâng Cao Miễn Phí Kèm Giải Pháp!