
Đúng khi nói dữ liệu là tiền bạc trong thế giới ngày nay. Cùng với sự chuyển đổi sang thế giới dựa trên ứng dụng là sự tăng trưởng cấp số nhân của dữ liệu. Tuy nhiên, hầu hết dữ liệu là phi cấu trúc và do đó cần quy trình và phương pháp để trích xuất thông tin hữu ích từ dữ liệu và chuyển đổi nó thành hình thức dễ hiểu và sử dụng được.
Khai phá dữ liệu (Data mining) hoặc "Khám phá kiến thức trong Cơ sở dữ liệu" (Knowledge Discovery in Databases) là quá trình khám phá mẫu trong tập dữ liệu lớn với trí tuệ nhân tạo, học máy, thống kê và hệ thống cơ sở dữ liệu.
Các công cụ khai phá dữ liệu miễn phí bao gồm từ môi trường phát triển mô hình hoàn chỉnh như Knime và Orange, đến nhiều thư viện viết bằng Java, C++ và thường nhất là Python. Có bốn loại nhiệm vụ thường涉及 trong Khai phá dữ liệu:
- Phân loại (Classification): Nhiệm vụ khái quát cấu trúc quen thuộc để áp dụng cho dữ liệu mới
- Gom cụm (Clustering): Nhiệm vụ tìm nhóm và cấu trúc trong dữ liệu giống nhau theo cách nào đó, không dùng cấu trúc đã biết trong dữ liệu.
- Học quy tắc liên kết (Association rule learning): Tìm mối quan hệ giữa các biến
- Hồi quy (Regression): Nhằm tìm hàm số mô hình hóa dữ liệu với sai số nhỏ nhất.
Dưới đây là danh sách phần mềm miễn phí cho Khai phá dữ liệu —
Danh sách Công cụ Khai phá dữ liệu miễn phí tốt nhất năm 2022:
1. Rapid Miner –
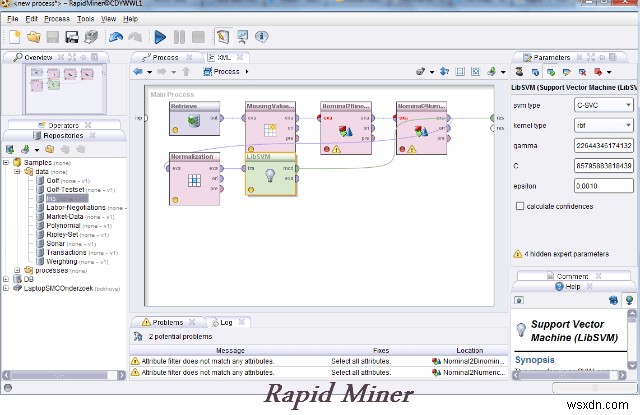
Rapid Miner, trước đây gọi là YALE (Yet another Learning Environment), là môi trường cho thí nghiệm học máy và khai phá dữ liệu được dùng cho cả nghiên cứu và tác vụ khai phá dữ liệu thực tế. Đây không thể phủ nhận là hệ thống mã nguồn mở hàng đầu thế giới cho khai phá dữ liệu. Viết bằng ngôn ngữ Java, công cụ này cung cấp phân tích nâng cao qua các khung mẫu (template-based frameworks).
Nó cho phép thí nghiệm được cấu thành từ số lượng lớn các toán tử lồng nhau tùy ý, được chi tiết trong file XML và tạo bằng giao diện đồ họa người dùng của Rapid Miner. Điểm tốt nhất là người dùng không cần viết code. Nó đã có nhiều mẫu và công cụ khác giúp chúng ta phân tích dữ liệu dễ dàng.
2. IBM SPSS Modeler –
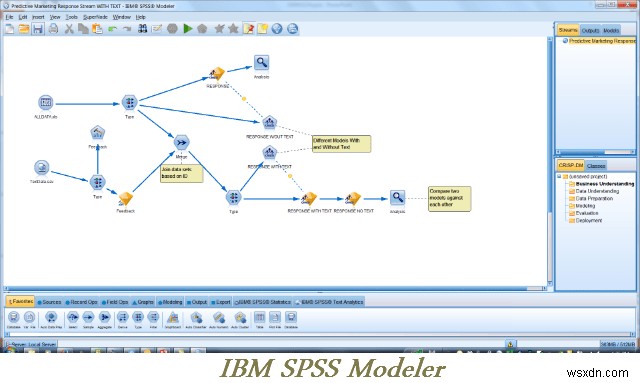
Bàn làm việc IBM SPSS Modeler tốt nhất cho dự án quy mô lớn như phân tích văn bản, và giao diện trực quan của nó cực kỳ có giá trị. Nó cho phép bạn tạo ra nhiều thuật toán khai phá dữ liệu mà không cần lập trình. Nó cũng có thể dùng cho phát hiện bất thường, mạng Bayesian, CARMA, hồi quy Cox và mạng nơ-ron cơ bản sử dụng perceptron đa lớp với học lan truyền ngược. Không dành cho người yếu tim.
3. Oracle Data Mining –
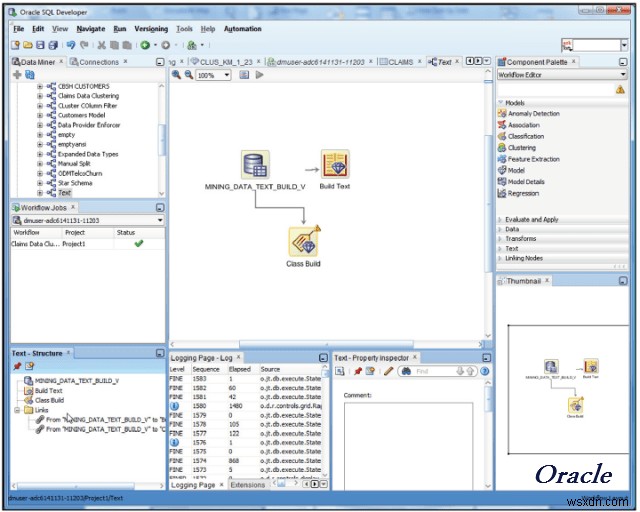
Một "người chơi lớn" khác trong lĩnh vực khai phá dữ liệu là Oracle. Là một phần của tùy chọn Advanced Analytics Database, Oracle Data Mining cho phép người dùng khám phá insight, dự đoán và tận dụng dữ liệu Oracle. Bạn có thể xây dựng mô hình để khám phá hành vi khách hàng, nhắm mục tiêu khách hàng tốt nhất và xây dựng hồ sơ.
Giao diện Oracle Data Miner cho phép nhà phân tích dữ liệu, nhà phân tích kinh doanh và nhà khoa học dữ liệu làm việc với dữ liệu bên trong cơ sở dữ liệu bằng giải pháp kéo thả khá thanh lịch. Nó cũng có thể tạo script SQL và PL/SQL cho tự động hóa, lập lịch và triển khai trên toàn doanh nghiệp.
4. Teradata –
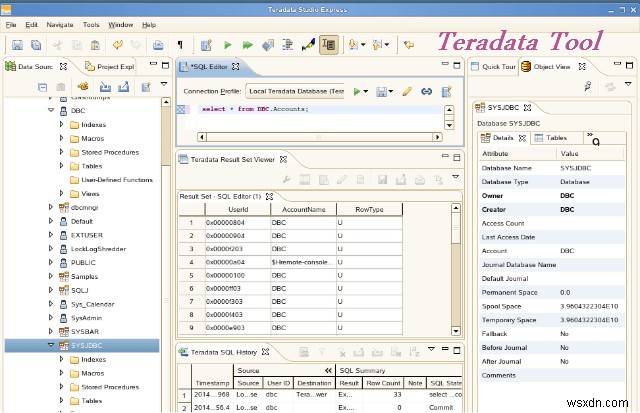
Teradata nhận ra thực tế rằng, dù Big Data tuyệt vời, nếu bạn không thực sự biết cách phân tích và sử dụng nó, nó vô nghĩa. Hãy tưởng tượng có hàng triệu điểm dữ liệu mà không có kỹ năng để truy vấn chúng. Đó là nơi Teradata xuất hiện. Họ cung cấp giải pháp và dịch vụ đầu cuối trong kho dữ liệu, Big Data và phân tích cũng như ứng dụng marketing.
Teradata cũng cung cấp toàn bộ dịch vụ bao gồm triển khai, tư vấn kinh doanh, đào tạo và hỗ trợ.
5. Framed Data –
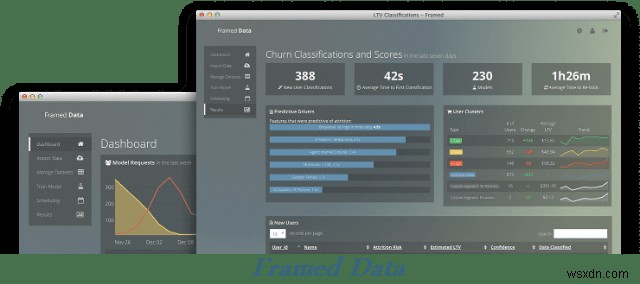
Đây là giải pháp được quản lý hoàn toàn nghĩa là bạn không cần làm gì ngoài ngồi chờ insight. Framed Data lấy dữ liệu từ doanh nghiệp và biến nó thành insight và quyết định có thể hành động. Họ huấn luyện, tối ưu và lưu trữ mô hình sản xuất hóa trong đám mây của họ và cung cấp dự đoán qua API, loại bỏ chi phí cơ sở hạ tầng. Họ cung cấp dashboard và công cụ phân tích kịch bản cho bạn biết đòn bẩy nào của công ty đang thúc đẩy các chỉ số bạn quan tâm.
6. Kaggle –
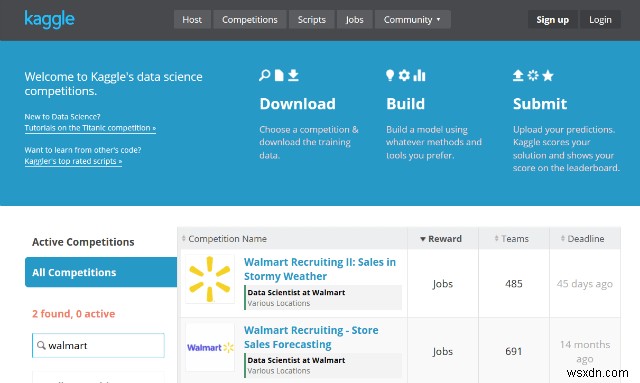
Kaggle là cộng đồng khoa học dữ liệu lớn nhất thế giới. Công ty và nhà nghiên cứu đăng dữ liệu và thống kê gia, nhà khai phá dữ liệu từ khắp nơi trên thế giới cạnh tranh để tạo ra mô hình tốt nhất.
Kaggle là nền tảng cho cuộc thi khoa học dữ liệu. Nó giúp bạn giải quyết vấn đề khó, tuyển đội ngũ mạnh, và khuếch đại sức mạnh tài năng khoa học dữ liệu của bạn.
3 bước làm việc —
- Tải lên bài toán dự đoán
- Nộp bài
- Đánh giá và Trao đổi
7. Weka –
WEKA là công cụ khai phá dữ liệu rất tinh vi. Nó cho thấy các mối quan hệ khác nhau giữa các tập dữ liệu, cụm, mô hình dự đoán, hình ảnh hóa v.v. Có một số bộ phân loại (classifiers) bạn có thể áp dụng để có insight sâu hơn vào dữ liệu.
8. Rattle –

Rattle là viết tắt của R Analytical Tool to Learn Easily (Công cụ phân tích R để học dễ dàng). Nó trình bày tóm tắt thống kê và trực quan của dữ liệu, chuyển đổi dữ liệu thành dạng có thể mô hình hóa dễ dàng, xây dựng cả mô hình có giám sát và không giám sát từ dữ liệu, trình bày hiệu suất mô hình bằng đồ họa, và chấm điểm tập dữ liệu mới.
Đây là bộ công cụ khai phá dữ liệu mã nguồn mở miễn phí viết bằng ngôn ngữ thống kê R sử dụng giao diện đồ họa Gnome. Nó chạy trên GNU/Linux, Macintosh OS X, và MS/Windows.
9. KNIME –
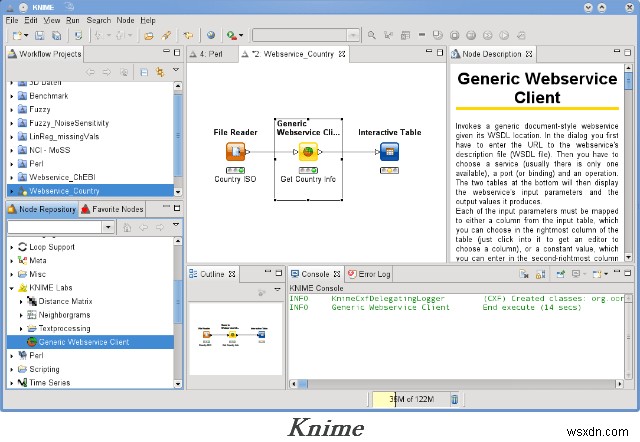
Konstanz Information Miner là nền tảng tích hợp, xử lý, phân tích và khám phá dữ liệu mã nguồn mở thân thiện, dễ hiểu và toàn diện. Nó có giao diện đồ họa người dùng giúp người dùng dễ dàng kết nối các node để xử lý dữ liệu.
KNIME cũng tích hợp các thành phần cho học máy và khai phá dữ liệu qua khái niệm ống dẫn dữ liệu mô-đun (modular data pipelining) và đã thu hút sự chú ý của trí tuệ kinh doanh và phân tích dữ liệu tài chính.
10. Python –
Là ngôn ngữ miễn phí và mã nguồn mở, Python thường được so sánh với R về dễ sử dụng. Khác với R, đường cong học tập của Python thường ngắn đến mức huyền thoại. Nhiều người dùng thấy họ có thể bắt đầu xây dựng tập dữ liệu và làm phân tích tương quan phức tạp trong vài phút. Các trường hợp trực quan hóa dữ liệu kinh doanh phổ biến nhất đều đơn giản miễn là bạn thoải mái với khái niệm lập trình cơ bản như biến, kiểu dữ liệu, hàm, điều kiện và vòng lặp.
11. Orange –
Orange là bộ phần mềm khai phá dữ liệu và học máy dựa trên thành phần (component-based) viết bằng ngôn ngữ Python. Nó là công cụ trực quan hóa và phân tích dữ liệu mã nguồn mở cho người mới và chuyên gia. Khai phá dữ liệu có thể thực hiện qua lập trình trực quan hoặc scripting Python. Nó cũng đầy đủ tính năng cho phân tích dữ liệu, các trực quan hóa khác nhau, từ scatter plots, biểu đồ cột, cây, đến dendrograms, mạng và heat maps.
12. SAS Data Mining –
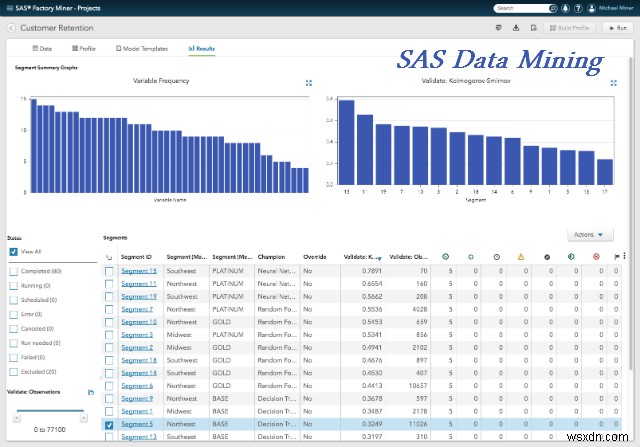
Khám phá mẫu tập dữ liệu bằng phần mềm thương mại SAS Data Mining. Mô hình mô tả và dự báo của nó cung cấp insight để hiểu dữ liệu tốt hơn. Họ cung cấp GUI dễ dùng. Họ có công cụ tự động từ xử lý dữ liệu, gom cụm đến cuối nơi bạn tìm thấy kết quả tốt nhất để đưa ra quyết định đúng. Là phần mềm thương mại nên cũng bao gồm công cụ nâng cao như xử lý có khả năng mở rộng, tự động hóa, thuật toán tập trung, mô hình hóa, trực quan hóa và khám phá dữ liệu v.v.
13. Apache Mahout –
Apache Mahout là dự án của Apache Software Foundation để tạo ra các triển khai miễn phí của thuật toán học máy phân tán hoặc có khả năng mở rộng, tập trung chủ yếu vào lọc cộng tác, gom cụm và phân loại.
Apache Mahout chủ yếu hỗ trợ ba trường hợp sử dụng: Khai phá khuyến nghị (Recommendation mining) lấy hành vi người dùng và từ đó tìm món hàng người dùng có thể thích. Gom cụm (Clustering) lấy ví dụ tài liệu văn bản và gom chúng thành nhóm chủ đề liên quan. Phân loại (Classification) học từ tài liệu đã phân loại hiện có tài liệu thuộc loại cụ thể trông như thế nào và có thể gán tài liệu chưa gán nhãn vào danh mục (hy vọng) đúng.
14. PSPP –
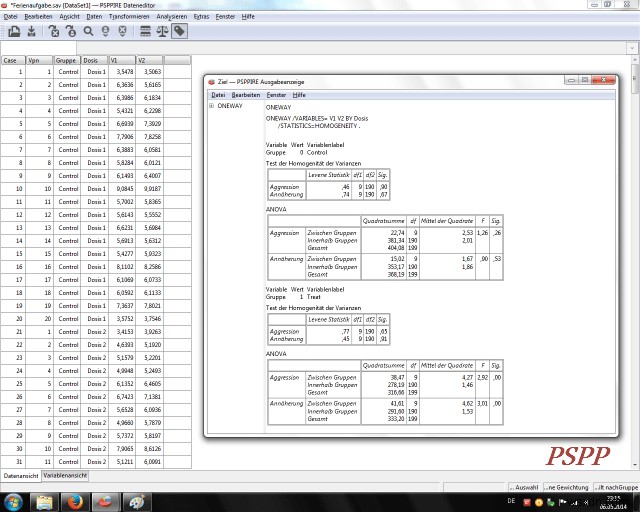
PSPP là chương trình phân tích thống kê dữ liệu mẫu. Nó có giao diện đồ họa và giao diện dòng lệnh truyền thống. Nó được viết bằng C, dùng GNU Scientific Library cho các thủ tục toán học, và plot UTILS để tạo đồ thị. Đây là bản thay thế miễn phí cho chương trình độc quyền SPSS (từ IBM) dự đoán với sự tự tin điều gì sẽ xảy ra tiếp theo để bạn có thể đưa ra quyết định thông minh, giải quyết vấn đề và cải thiện kết quả.
15. jHepWork –
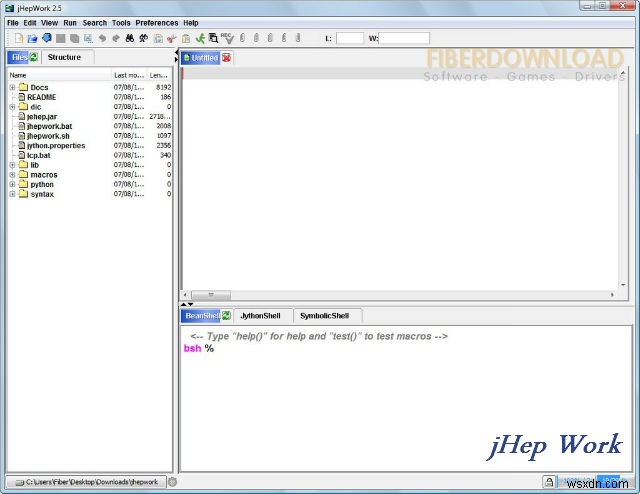
jHepWork là khung phân tích dữ liệu miễn phí và mã nguồn mở được tạo ra như một nỗ lực để tạo môi trường phân tích dữ liệu sử dụng các gói mã nguồn mở với giao diện người dùng dễ hiểu và tạo ra công cụ cạnh tranh với chương trình thương mại.
jHepWork hiển thị đồ thị 2D và 3D tương tác cho tập dữ liệu để phân tích tốt hơn. Có thư viện khoa học số và hàm toán học được triển khai bằng Java. jHepWork dựa trên ngôn ngữ lập trình cấp cao Jython, nhưng mã Java cũng có thể dùng để gọi thư viện số và đồ họa của jHepWork.
16. Ngôn ngữ lập trình R –
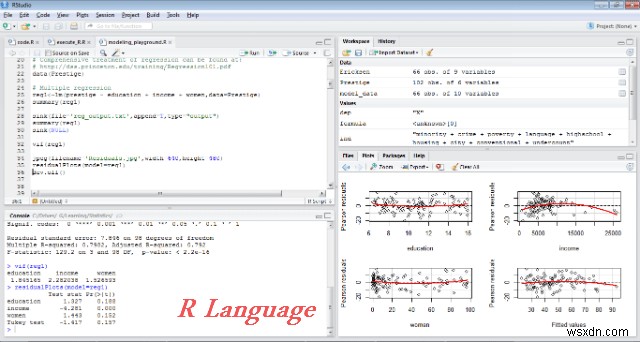
Không có gì bí ẩn tại sao R là siêu sao của các công cụ khai phá dữ liệu miễn phí trong danh sách này. Nó miễn phí, mã nguồn mở và dễ bắt đầu cho người ít hoặc không có kinh nghiệm lập trình. Có thực sự hàng nghìn thư viện có thể tích hợp vào môi trường R khiến nó trở thành môi trường khai phá dữ liệu mạnh mẽ. Nó là ngôn ngữ lập trình phần mềm miễn phí và môi trường phần mềm cho tính toán thống kê và đồ họa.
Ngôn ngữ R được sử dụng rộng rãi trong cộng đồng nhà khai phá dữ liệu để phát triển phần mềm thống kê và phân tích dữ liệu. Dễ sử dụng và khả năng mở rộng đã nâng cao độ phổ biến của R đáng kể trong những năm gần đây.
17. Pentaho –
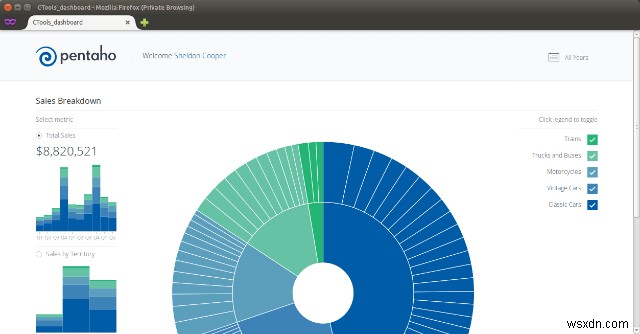
Pentaho cung cấp nền tảng toàn diện cho tích hợp dữ liệu, phân tích kinh doanh và Big Data. Với công cụ thương mại này bạn có thể dễ dàng kết hợp dữ liệu từ bất kỳ nguồn nào. Nhận insight vào dữ liệu kinh doanh và đưa ra quyết định chính xác hơn dựa trên thông tin cho tương lai.
18. Tanagra –
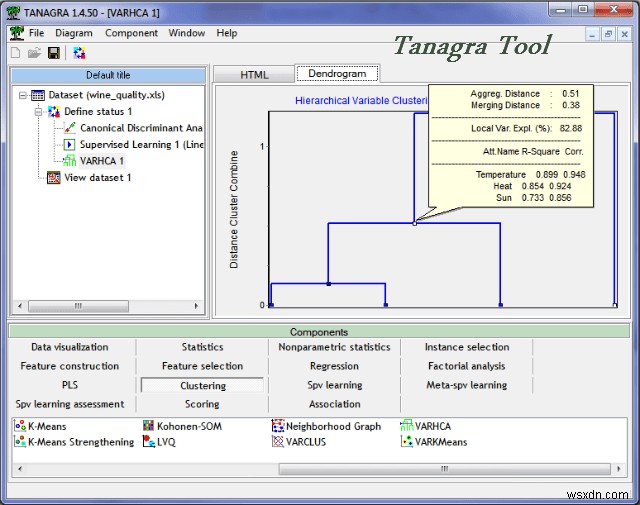
TANAGRA là phần mềm khai phá dữ liệu cho mục đích học thuật và nghiên cứu. Có công cụ cho phân tích dữ liệu khám phá, học thống kê, học máy và khu vực cơ sở dữ liệu. Tanagra chứa một số học có giám sát nhưng cũng có các mô hình khác như gom cụm, phân tích nhân tử, thống kê tham số và phi tham số, quy tắc liên kết, chọn lọc đặc trưng và thuật toán xây dựng.
19. NLTK –
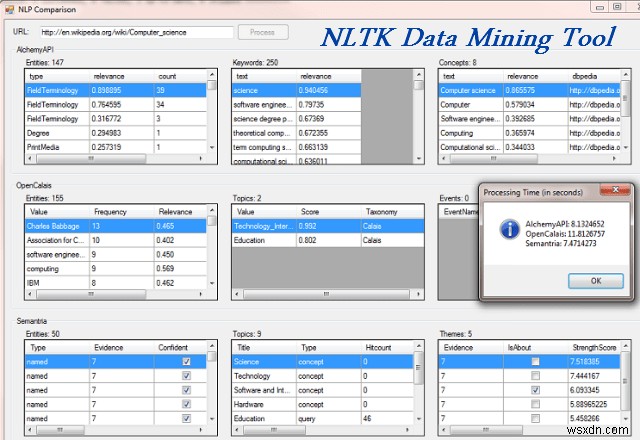
Natural Language Toolkit, là bộ thư viện và chương trình cho xử lý ngôn ngữ tự nhiên ký hiệu và thống kê (NLP) cho ngôn ngữ Python. Nó cung cấp kho công cụ xử lý ngôn ngữ bao gồm khai phá dữ liệu, học máy, thu thập dữ liệu, phân tích cảm xúc và nhiều tác vụ xử lý ngôn ngữ khác. Xây dựng chương trình Python để xử lý dữ liệu ngôn ngữ con người.
Chúng tôi hy vọng danh sách công cụ khai phá dữ liệu miễn phí tốt nhất này hữu ích cho bạn. Chúng tôi rất muốn biết ý kiến của bạn, xin vui lòng chia sẻ quan điểm trong phần bình luận bên dưới.