
Bạn có thể đã nghe về này. Google đang cân nhắc ý tưởng thay đổi cách con người tương tác với trang web. Cụ thể hơn, cách con người tương tác với URL, địa chỉ web đọc được bởi con người mà qua đó chúng ta chủ yếu nhận diện và nhớ các trang web chúng ta truy cập. Hiệu ứng lan tỏa quanh đề xuất này khá thú vị, phải nói. Và nó khiến tôi suy nghĩ.
Một, sự phản đối thực sự đối với thay đổi này tiết lộ nhiều hơn bản thân thay đổi. Hai, có thực sự có giá trị gì trong việc cố gắng làm cho URL trở nên có ý nghĩa và/hoặc hữu ích hơn hình thức hiện tại không? Để đạt đích đó, bạn đang đọc bài viết này.
URL một cái nhìn
Con người liên kết ký ức với từ chứ không phải số. Dễ dàng hơn nhiều để nhớ cả câu hoặc đoạn văn hơn một chuỗi số. Điều này là vì ngôn ngữ của chúng ta được xây dựng chủ yếu từ từ ngữ. Chúng ta संघर्ष với bất kỳ chuỗi số nào dài hơn tám hoặc chín chữ số. Lý do đơn giản là, với chữ cái, sự độc đáo của thông tin tương đối nhỏ – 1001 và 1002 chỉ khác một chữ cái, nếu nói như vậy, nhưng chỉ phần cuối mới cho ý nghĩa cho sự khác biệt. Với từ ngữ, có ít tổ hợp nào sẽ gây mơ hồ vượt quá một chuỗi ký tự và/hoặc âm thanh ngắn.
Do đó, khi Web xuất hiện, việc dùng từ – chuỗi ký tự – để nhận diện trang web thay vì bản dịch máy trở nên logic hơn. Đây là một chu kỳ thú vị. Chúng ta biến từ (code) thành ngôn ngữ máy, rồi làm ngược lại để con người có thể tương tác với máy tính một cách có ý nghĩa. Dùng số để lướt Web là cách của máy. Chuỗi ký tự là cách của con người.
Vấn đề là – URL là dạng lai giữa ngôn ngữ người và máy. Mặt một, bạn có yếu tố người, chính địa chỉ (như dedoimedo.com), nhưng phần còn lại hầu như là hướng dẫn cho máy chủ từ xa để tìm, tìm kiếm và trình bày thông tin trở lại người dùng. Điều này tạo ra vấn đề là con người tương tác với trang web theo cách không luôn có nghĩa đối với bộ não thường.
Vấn đề khác là – URL không có bất kỳ độ trung thực thông tin nhúng nào. Giống như địa chỉ thực tế trong thế giới thực. Nếu bạn đến 17 Orchard Drive, nó không cho bạn biết ĐÂU là địa chỉ đó. Có thể là văn phòng, nhà riêng, hoặc sảnh nhảy. Không có thông tin về NỘI DUNG, như những gì bạn sẽ tìm thấy đó – người,瓦砾, bàn thờ, v.v.
Cùng cách đó, URL không phản ánh đích đến (trang web bạn kết nối) theo bất kỳ cách nào. Đôi khi có tương quan, nhưng tổng thể, nó không có ý nghĩa trừ khi bạn biết trang web đó về gì, và nó nhằm làm gì. Điều này đúng cho cả trang web nhỏ lẫn công ty khổng lồ.
Ví dụ, Google không thực sự nói nó là công cụ tìm kiếm. Yahoo không nói nó là công cụ tìm kiếm. Bing có nghĩa gì? Amazon là một con sông, một rừng hay một chợ trực tuyến khổng lồ? Bạn đã tin tưởng các trang này nhờ sử dụng và uy tín chung, không phải vì có giá trị nguyên mẫu nào trong thông tin URL. Nhưng nó tốt hơn, hoặc tệ hơn:
- Không có tương quan giữa chuỗi trang web và mục đích trang web.
- Không có tương quan giữa chuỗi trang web và tên trang web (hoặc doanh nghiệp đằng sau).
- Không có tương quan giữa tiêu đề trang web và tên trang web.
- Không có thông tin về mục đích trang web.
Hơn nữa, khi bạn đến một trang cụ thể, có thể không có tương quan giữa tiêu đề trang, URL và nội dung. Bạn có thể vào một trang, trang gọi là kittens.html, nhưng nó có thể về decal hình mèo cho xe, hoặc thực sự về những con vật lông nhỏ. Hoặc thứ gì đó hoàn toàn khác. Và trang web đó thực sự có thể gọi là Dany's shop, và URL có thể là mysitenstuff.org.
Và nó tệ hơn nữa. Cho đến nay, chúng ta chỉ thảo luận yếu tố người của phương trình. Sau đó, có phần máy. Subdomain. Những thứ như m, www, www3. Giao thức như http, https, ftp. Bộ phân tách, thư mục con. Cách không đồng nhất mà trang trình bày trang – ngày, số ngẫu nhiên, chuỗi, v.v. Sau đó, bạn cũng có hướng dẫn. Một trang có thể có thứ như &uid=1234567&ref=true gắn ở cuối chuỗi URL, không có nghĩa gì với bạn như người dùng, nhưng nó nói điều gì đó cho máy chủ web và/hoặc ứng dụng đang phục vụ hoặc phân tích nội dung.
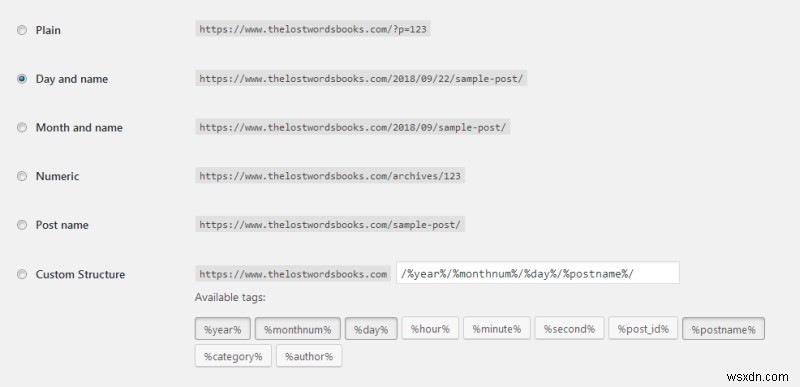
Tất cả các tùy chọn URL này sẽ giải quyết thành cùng nội dung, nhưng chúng trông và render khác nhau.
Cuối cùng, không có thước đo niềm tin. Trang web ngang nhau về giá trị cho đến khi được xác thực theo cách nào đó. Sớm, khi mua sắm trực tuyến phổ biến hơn, khái niệm chứng chỉ số xuất hiện, với các cơ quan uy tín bảo chứng cả độ tin cậy và bảo mật đằng sau huy hiệu mã hóa và chống giả mạo. Nỗ lực cộng đồng và xếp hạng trang (đôi khi độc quyền) trở thành biện pháp thứ hai của giá trị liên quan đến tên miền (trang web) và nội dung của chúng, nhưng về cơ bản, điều này không được phản ánh trong chính URL.
Vậy câu hỏi là, chúng ta cần thay đổi không? Có lẽ. Có lẽ không. Internet hoạt động và mở rộng tốt.
Câu trả lời nằm ở giải pháp. Nhưng trước, thêm chút triết học.
Bạn phản ứng thế nào khi nghe về đề xuất?
Từ những gì tôi thấy, có hai phe lớn ở đây. Những người hoan nghênh thay đổi, cảm thấy điều này sẽ làm Web tốt hơn (lượng "tốt hơn" cần được định nghĩa, nếu không đó chỉ là lời suông). Và những người chống đối thay đổi. Phe thứ hai có thể chia thành ba: người kháng cự thay đổi chỉ để thay đổi, những người phản đối giá trị kỹ thuật và lợi ích giảng giải, và nhóm ba là những người không tin một công ty lợi nhuận đề xuất hoặc dẫn dắt thay đổi này.
Thực sự, điều này đặt ra một câu hỏi triết học lớn hơn. Google có nên được phép dẫn dắt điều này không?
Dù sao, nhiều năm qua, nhiều công ty lợi nhuận đã tạo ra sản phẩm hay mà chúng ta dùng hôm nay mà không nghĩ đến. Sự phẫn nộ và tranh luận sớm đã bị lãng quên. Nhưng có tiền liên quan, đó là yếu tố động lực mạnh, và mọi việc được làm để củng cố lợi nhuận của công ty. Cùng điều sẽ chắc chắn xảy ra với bất kỳ công ty nào có trách nhiệm trước cổ đông, bất kể tên nó là gì. Google có vị trí dẫn dắt nhờ ảnh hưởng khổng lồ trong thế giới di động và tìm kiếm. Nhưng đây có thể là bất kỳ công ty nào, và cuối cùng, các yếu tố cơ bản là như nhau. Đối với một số người, đó là tất cả quan trọng. Nếu là lợi nhuận, nó không thể là giải pháp công chính có lợi cho nhân loại. Có lẽ, như tác động phụ, nhưng không phải mục tiêu chính.
Và đây là điều thực sự thú vị. Sự kháng cự phản ánh Google qua nhiều năm hơn là bất cứ điều gì liên quan đến công nghệ bản thân. Hình như, từ "do-no-evil" (biến mất khỏi bản tuyên ngôn công ty) đến chỉ một công ty "big-boy-suit" (công ty lớn mặc vest) thông thường.
Ví dụ khác củng cố trường hợp là sự kiên quyết của Google về AMP, dự án tối ưu di động của chính nó gói HTML thông thường trong các chỉ thị AMP đặc biệt. Mặc dù nó có giá trị gì về tải trang, tổng thể, điều này thực sự tệ. Đây là sự lặp lại vấn đề chúng ta thấy với Internet Explorer 6, nơi Microsoft tạo ra một loạt chỉ thị mới không tuân thủ tiêu chuẩn Web, tạo ra hỗn loạn HTML/CSS dành riêng trình duyệt mà chỉ gần đây mới được giải開 một phần.
Khi tôi bắt đầu Dedoimedo năm 2006, đây là vấn đề lớn. Gần như mọi trang web lúc đó có ghi đè IE6/7/8 trong HTML của họ. Tôi quyết định không triển khai những thứ đó và tuân thủ spec W3C, bất kể phạt khả năng về khách truy cập hay gì, vì cách duy nhất để thiết kế theo cách chung và chuẩn hóa là cách Tim Berners-Lee huyền thoại đã hình dung. Lịch sử đã chứng minh tôi đúng. ngay cả hôm nay, tôi đảm bảo mọi trang của tôi có HTML và CSS hợp lệ, thứ bạn hiếm khi thấy trên thị trường ngày nay. Và nếu bạn dùng ghi đè đặc biệt cho trình duyệt này hay kia, thì bạn đang giúp làm Internet kém đi.
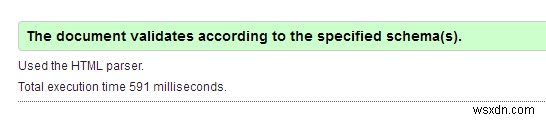
HTML hợp lệ, một loài đang tuyệt chủng.
Bây giờ, Google đang tái tạo vấn đề phân kỳ tuân thủ HTML/CSS với AMP. Web phải trung lập và tuân thủ các tiêu chuẩn quốc tế công chính. Nó không bao giờ nên được định hình theo ý muốn của công ty nào.
Do đó, URL chỉ là chất xúc tác cho sự không tin cậy dâng cao chống lại các tập đoàn lớn, đặc biệt những cái trong kinh doanh dữ liệu riêng tư. Đó là vấn đề cần được giải quyết trước để chúng ta có thể tách cảm xúc khỏi công nghệ. Nếu không, tất cả đề xuất tương lai sẽ bị lỗi, vì chúng sẽ tìm cách giải quyết nhu cầu cảm xúc thay vì nhu cầu kỹ thuật.
Tôi không có giải pháp cho điều này – chỉ Google có thể thay đổi Google. Nếu họ muốn, đương nhiên.
Sự thay đổi
Chúng ta không được quên điều này. Ý tưởng tử tế bị cuốn vào động lực cuộc sống, trở thành phiên bản bị bóp méo của khái niệm ban đầu. Điều này đôi khi xảy ra qua thiết kế có chủ đích, và đôi khi bởi tai nạn, qua một triệu quyết định và ràng buộc nhỏ không thể nhìn thấy hay lên kế hoạch trước. Hãy nghĩ về hầu như bất kỳ sản phẩm nào bạn đang dùng. Nhìn nó năm hay mười năm trước, nếu nó tồn tại那么久. Bạn thấy sự thay đổi? Bạn thích nó? Và nhớ rằng bạn cũng đã thay đổi như một con người, và cách bạn cảm nhận thế giới hôm nay không hoàn toàn giống như cảm giác vài năm trước.
Giải pháp của Google – hoặc của bất kỳ ai – có thể là điều tốt nhất trên đời. Mười bảy hoặc hai mươi năm từ nay, nó có thể thay đổi theo cách không thể dự đoán, dù ý định tốt nhất và tất cả deep learning trên thế giới. Không cần có ác ý. Chỉ sự trôi chậm của cách mọi việc được làm, người quen và chấp nhận quy chuẩn mới như truyền thống cũ, và tiếp tục, cho đến khi thứ gốc đã lâu bị quên.
Đó là vấn đề lớn. Bất kỳ đề xuất đồng thuận nào hôm nay, ngay cả nếu giải pháp của Google là HOÀN HẢO, không có gì ngăn cản bất kỳ công ty nào từ việc tạo triển khai riêng, độc quyền, bao gồm cả Google. Hay bất kỳ đối thủ.
Sự tư nhân hóa Internet thực sự đang xảy ra. Internet đang thu nhỏ. Trước hết, bạn tiêu thụ hầu hết thông tin qua trung gian – công cụ tìm kiếm, cổng tin tức. Bạn hiếm khi tìm thấy nội dung mới trừ khi nó được liệt kê trên trang tìm kiếm phổ biến, và ngay cả vậy, cao trên danh sách. Trên di động, tệ hơn. Người hầu như không lướt web nữa. Họ dùng app, được phục vụ bởi một cửa hàng tập trung đơn lẻ.
Chỉ nhìn điện thoại thông minh hoặc TV thông minh điển hình – một nền tảng kiểm soát chặt chẽ với nội dung được tuyển chọn và lọc. Khi bạn chạy app điện thoại, bạn không biết nó đang làm gì trong nền hoặc nó kết nối đến URL nào. Hoặc bạn tin nền tảng làm những gì nó nói, hoặc bạn không dùng nó, điều này càng ngày càng khó vì công nghệ trở nên xâm nhập và cần thiết trong đời sống hàng ngày. Và điều này xảy ra trong, gì, chỉ mười hoặc mười lăm năm kể từ khi Internet thực sự bùng nổ? Hãy tưởng tượng gì sẽ xảy ra trong hai mươi hoặc năm mươi năm.
Internet như một quyền con người
Internet, nói như vậy, đã được thêm vào Tuyên ngôn Nhân quyền Quốc tế. Nhưng đó chưa đủ xa.
Chúng ta đã có Internet task force (nhóm tác vụ Internet). Chúng ta có tiêu chuẩn. Chúng ta cũng có luật quyền riêng tư, chủ yếu quốc gia. Nhưng không có cơ quan siêu chính phủ nào đảm bảo tự do số và không can thiệp của bên tư nhân vào trung lập của Web xuống đến mức cá nhân. Rất có thể điều này sẽ không bao giờ xảy ra, vì chiếc bánh quá lớn và ngon để buông.
Vâng nếu hỏi tôi, cách duy nhất để thực sự đảm bảo một số phần của Web thực sự không thể chạm được là ghi chú chúng trong một công ước Geneva số (digital Geneva-like convention). Điều này nghe ngây thơ và lý tưởng, nhưng mà, hôm nay, bạn đang ở sự khoan nhượng của bất kỳ ai kiểm soát Internet của bạn và họ quyết định cho bạn nó như thế nào.
Đề xuất của tôi
Được rồi, cuối cùng, phần kỹ thuật.
Dù sao, cấu trúc URL chủ yếu là: máy | người | máy.
Các yếu tố điều khiển là: trung lập, bảo mật, toàn vẹn, dễ dùng. Bảo mật và toàn vẹn đã được giải quyết tương đối tốt bởi chứng chỉ số – nhưng có thể cải thiện. Trung lập được nhúng trong phần người của chuỗi URL, và dễ dùng nằm ở phần đầu và cuối.
Phần máy 1
Như bạn biết, trình duyệt hiện đại đã cố tách phần máy khỏi phần người của chuỗi địa chỉ web bằng cách không hiển thị https:// và/hoặc phần www của địa chỉ, vì các trình duyệt này hiếm khi phục vụ giao thức khác ngoài http hoặc https. Điều này không quá tệ. Tuy nhiên, khái niệm Secure-Not Secure (An toàn-Không an toàn) không đủ rõ ràng. Nó báo động và an ủi nhưng không vì lý do đúng – chúng ta sẽ nói về này ở phần người.
HTTP:// hoặc HTTPS:// không có nghĩa gì với 99% người. Chúng hữu ích nếu bạn trao chuỗi URL cho ứng dụng khác, để chúng dùng giao thức đúng để kết nối. Hơn nữa, chúng ta thực sự có sự dư thừa ở đây. Chứng chỉ đã làm việc xác nhận bảo mật kết nối.
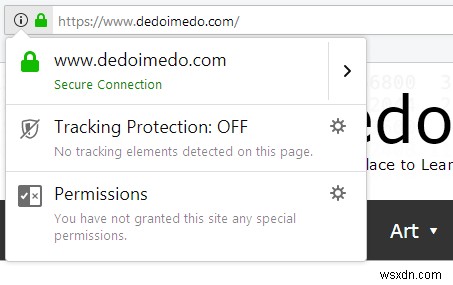
Câu trả lời là hoặc bỏ tiền tố (phần máy 1) hoàn toàn và chỉ dùng chứng chỉ, hoặc vì lý do biểu tượng, thay thế tiền tố bằng cái gì đó như web – bộ phân tách thực tế và những thứ khác mang sự kiểm tra riêng. Điều này có thể mở lối cho triển khai tương lai của các giao thức non-web khác, như thực tế ảo, truyền phát media thuần túy, chat, v.v. Và cũng giữ nhất quán với trang nội bộ trình duyệt như config, chrome, v.v.
Phần người
Phần người phải bất xâm phạm – bất kể địa chỉ trang web là gì, nó phải tồn tại và luôn được hiển thị cho người dùng mà không có bất kỳ che giấu nào. Nên có hướng dẫn cho thực hành URL tốt mà ứng dụng có thể tuân theo, bao gồm khớp tên miền, mục đích, logic, ngày và tiêu đề, mà một số máy chủ làm. Nhưng này giống như địa chỉ thực tế. Chúng ta không chọn tên đường, hay cách địa chỉ nhà hình thành, và có rất nhiều tùy chọn trên toàn cầu. Tương tự ở đây.
Đây là một phần của chúng ta – và thay đổi ngôn ngữ này cũng phá vỡ giao tiếp. Không có mảnh thông tin khách quan phổ quát nào trong tên miền, tiêu đề trang hoặc tương tự. Tất cả phụ thuộc vào những gì chúng ta muốn viết, và do đó, cố gắng "ruy băng" nó là sai lầm.
Nhưng niềm tin, toàn vẹn, giả mạo thì sao?
Nếu bạn gõ sai tên trang, bạn có thể đến trang sai. Hoặc người bỏ qua cảnh báo bảo mật và cho thông tin đăng nhập trên tên miền giả. Có cách khắc phục không phá vỡ giao tiếp người?
Vâng, chứng chỉ giúp – nhưng chúng không ngăn bạn đi đến trang đã ký số nhưng phục vụ nội dung giả. Cũng không ngăn bạn cho dữ liệu cá nhân. Nhưng riêng nó, công nghệ KHÔNG THỂ ngăn sự ngu dốt hoặc vô tri của con người. Nó có thể giảm thiểu, nhưng sự ám ảnh bất thánh với bảo mật làm giảm trải nghiệm người dùng và phá vỡ Internet. Vậy làm sao?
Tôi tin tốt hơn là thỏa hiệp về bảo mật hơn là trải nghiệm người dùng. Lợi ích vượt quá chi phí. Có tội phạm ngoài kia, nhưng phần lớn, không có sự sụp đổ xã hội và hỗn loạn. Vì nếu chúng ta thỏa hiệp tự do cho bảo mật, thế thì bạn biết nó dẫn đến đâu.
Tất cả nói vậy, nếu câu hỏi là làm thế nào để đảm bảo người dùng con người có thể phân biệt giữa nguồn hợp pháp và giả mạo phục vụ nội dung giống hệt nhau, vượt quá những gì chúng ta đã có, thì câu trả lời nằm ở một câu hỏi khác. Nếu bạn đưa hai trang giống hệt nhau cho người dùng, mảnh ghép nào tách biệt chúng? Câu trả lời ngay lập tức là: URL. Nhưng nếu người dùng không chú ý đến URL, thì sao?
Câu trả lời cho câu hỏi đó có thể là cơ chế whitelist (danh sách trắng). Nói cách khác, nếu người dùng cố nhập thông tin trên trang không được nhận diện (theo cách nào đó) là nguồn đã biết (đọc: tốt), trình duyệt có thể nhắc người dùng với thứ như: Bạn hiện đang ở trang XYZ và sắp điền thông tin cá nhân, có phải đây là điều bạn mong đợi không?
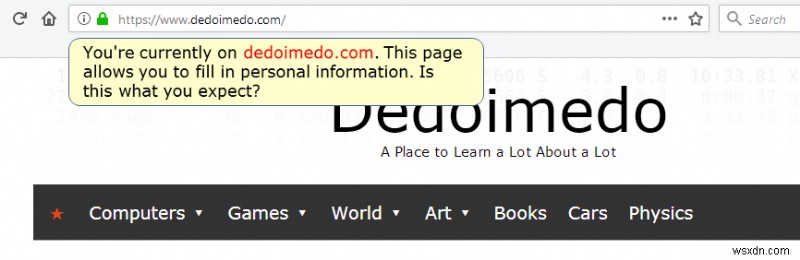
Mô phỏng sơ bộ những gì có thể dùng để cảnh báo người dùng khi họ sắp cung cấp thông tin cá nhân trên trang web không được "whitelist" theo cách nào.
Mọi người vẫn có thể tiếp tục và cho đi dữ liệu, nhưng mà, không có gì ngăn người ta tự điện tử mình với lò nướng bánh mì trong bồn tắm, cũng vậy. Đó KHÔNG phải là về thay đổi URL – đó là về giúp người hiểu họ đang ở ĐÚNG ĐỊA CHỈ. Theo cách không phá vỡ trải nghiệm người dùng.
Bây giờ, hãy nói thêm về chuỗi máy một chút, được không.
Phần máy 2
Phần thứ hai cần được chuẩn hóa. Hôm nay, máy chủ và ứng dụng phân tích, bóp méo và cấu trúc URL tùy ý. Bạn có thể thêm đủ loại qualifier và cặp khóa-giá trị, và kết thúc với thứ như tự động phát video, nội dung giỏ hàng, form điền sẵn, và hơn thế. Theo một cách, đây là code lười biếng, tiện lợi.
Chuẩn hóa cần phải trung lập – không phụ thuộc vào cách trình duyệt hay trang muốn trình bày thông tin, vì đó là một phần của vấn đề hôm nay (bao gồm lừa đảo). Tôi nghĩ trang web cần bị ép buộc trình bày cấu trúc URL đơn giản cho người dùng phản hồi theo cách hợp lệ.
Câu trả lời là: Ngôn ngữ URL. Cùng cách trình duyệt phân tích HTML và CSS, có thể có tiêu chuẩn URL cho phần máy. Đây có thể là từ điển tương đối nhỏ, và nó sẽ bao gồm các khóa VẪN KHÁ ĐỌC ĐƯỢC BỞI CON NGƯỜI như (chỉ một tập con nhỏ của các ví dụ có thể):
unique-user-identifier– giá trị này ánh xạ đến trình duyệt/người dùng cá nhân.javascript-status– nếu client hỗ trợ hoặc chạy Javascript.media-autoplay– liệu media có nên phát.media-timestamp– vị trí phát lại cho media.page– phần tử điều hướng.- Các khóa tương tự khác.
Phần còn lại sẽ bị trình duyệt bỏ qua – miễn là tất cả trình duyệt tuân thủ tiêu chuẩn quốc tế và cung cấp hành vi và phản hồi giống nhau. Vâng, cùng cách nếu bạn phát minh class CSS mới hoặc chỉ thị HTML, và nó không tồn tại và/hoặc chưa được khai báo đúng, nó bị bỏ qua. Cùng cách ứng dụng từ xa nên bỏ qua khóa tiêu chuẩn không tồn tại.
Phải có khóa đặc biệt (cờ), như dev=1 hoặc debug=1 sẽ ép trình duyệt giải thích tất cả phần máy được cung cấp và chuyển tiếp chúng đến máy chủ, điều này cũng cho phép dev/chủ trang khắc phục sự cố ứng dụng và cung cấp tương thích ngược hoàn toàn với mọi thứ chúng ta có trên thị trường hôm nay. Nhưng sau đó, người dùng có thể được nhắc nếu combo như vậy được phát hiện trong địa chỉ URL:
Trang này muốn chạy ở chế độ dev. Bạn có muốn cho phép không?
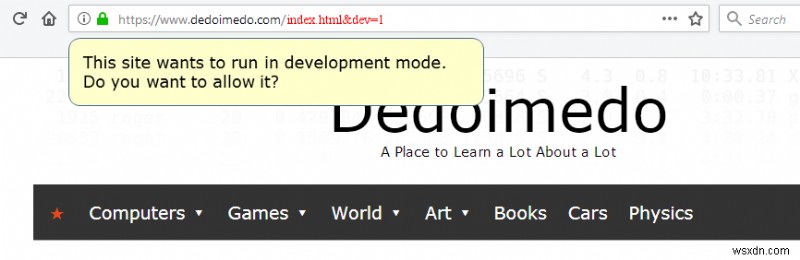
Mô phỏng sơ bộ cấu trúc URL chuẩn hóa có thể có, với cờ dev/debug.
Điều này có thể tăng cường bảo mật. Về lý thuyết, trình duyệt có thể cho phép người dùng chặn theo dõi qua URL và không chỉ trên trang tải. Ví dụ, nhiều lời mời email và 그런 đi kèm toàn bộ theo dõi, nhúng trong URL. Trình duyệt quan tâm quyền riêng tư có thể gọt bỏ chúng – hoặc hỏi người dùng.
URL tiện lợi để truyền thông tin cho ứng dụng – nhưng không có lý do thực sự cho việc này. Khi bạn nhấn Mua trên Amazon hay PayPal, bạn không thấy gì xảy ra. Khi bạn đọc Gmail, bạn không thấy gì xảy ra. Nút ẩn chức năng, và nó không phản ánh trong URL.
Tóm lại: phần máy của URL sẽ chứa từ điển giới hạn các khóa tiêu chuẩn cho phép thông tin được truyền theo cách này, nhưng phần còn lại sẽ bị bỏ qua trừ khi cờ đặc biệt như dev hoặc debug được dùng, với tùy chọn nhắc người dùng. Bảo mật tăng cường, quyền riêng tư tăng cường.
Nếu אי פעם được định nghĩa, chuẩn hóa và áp dụng, điều này sẽ mất thời gian – nỗ lực toàn ngành. Bây giờ, có cách nào bỏ qua bốn mươi năm kế thừa và triển khai hiện có? Câu trả lời là, không hề có cách. Thay đổi cấu trúc URL là thứ sẽ mất thập kỷ. Nếu bạn nghĩ IPv4 sang IPv6 phức tạp, hành trình URL sẽ dài hơn nữa.
Cuối cùng, Quis custodiet ipsos custodes? (Ai trông coi những người trông coi?). Quay về điểm xuất phát.
Kết luận
Thay đổi URL không quan trọng về mặt bản thân – nó quan trọng, nhưng phần kỹ thuật tương đối dễ. Vấn đề lớn hơn là, tại thời điểm này, mọi người vẫn có quyền truy cập Web tương đối không bị hạn chế, phần lớn do bản chất "nerd" của địa chỉ web đọc được bởi người. URL là một trong những mảnh cũ của Internet, và như vậy, nó phần lớn không được lọc và không có trừu tượng. Khi nó biến mất, chúng ta thực sự mất kiểm soát thông tin. Thế giới trở thành một vườn có rào (walled garden).
Lời kêu gọi hành động chung của Google có lý do, từ góc độ kỹ thuật, nhưng thay đổi có thể vô tình dẫn đến thứ lớn hơn nhiều. Thứ ác độc. Thứ buồn bã. cái chết của Internet như chúng ta biết. URL xấu xí, cồng kềnh được phát minh trong kỷ nguyên ngây thơ và khám phá. Dù khó hiểu đến đâu, nó là mảnh ghép không thực sự thuộc về ai. Bất kỳ thay đổi tương lai nào phải bảo toàn sự trung lập đó.
Nếu tôi là Google, tôi sẽ không lo về URL. Tôi sẽ tập trung vào tại sao người không muốn Google là trọng tài của Internet của họ. Hiểu tại sao người chống đối bạn, bất kể chi tiết kỹ thuật. Vì, cuối cùng, nó không về URL. Nó về tự do. Khi mảnh ghép đó vừa khớp, giải pháp kỹ thuật sẽ tầm thường.
Thức ăn cho suy nghĩ.
Cheers.