
"Đơn giản là sự tinh tế tối thượng" — Leonardo da Vinci
"Hầu hết thông tin đều không liên quan và hầu hết nỗ lực đều bị lãng phí, nhưng chỉ chuyên gia mới biết bỏ qua gì" — James Clear, Atomic Habits
Bạn có một đường ống dữ liệu (data pipeline) sang trọng với nhiều hệ thống khác nhau. Trên bề mặt nó trông rất tinh vi, nhưng thực tế dưới capa là một hỗn loạn phức tạp. Nó có thể cần nhiều công việc "lắp ống" để kết nối các mảnh khác nhau, cần giám sát liên tục, có thể yêu cầu một đội ngũ lớn với chuyên môn độc đáo để chạy, debug và quản lý. Chưa nói đến việc càng nhiều hệ thống bạn dùng, càng nhiều nơi bạn nhân bản dữ liệu và càng nhiều cơ hội để dữ liệu bị out-of-sync (không đồng bộ) hoặc stale (lỗi thời). Hơn nữa, vì từng hệ thống con được phát triển độc lập bởi các công ty khác nhau, các bản nâng cấp hoặc sửa lỗi của chúng có thể làm hỏng đường ống và lớp dữ liệu của bạn.
Nếu bạn không cẩn thận, bạn có thể rơi vào tình huống như được mô tả trong video 3 phút dưới đây. Tôi mạnh mẽ khuyên bạn nên xem nó trước khi tiếp tục.
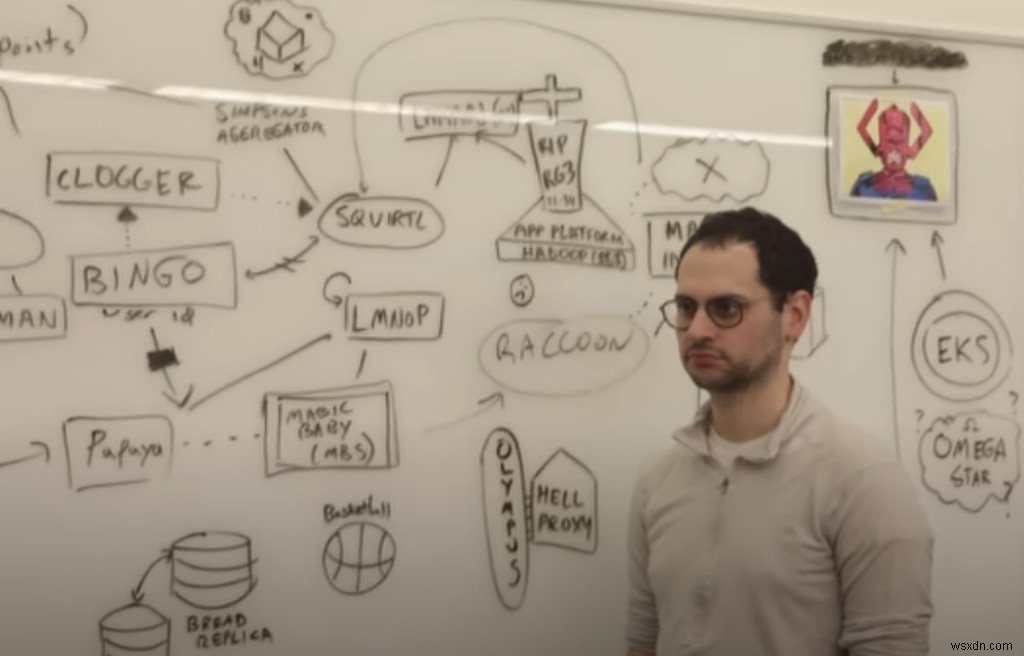
Sự phức tạp xuất hiện vì ngay cả khi mỗi hệ thống có vẻ đơn giản trên bề mặt, chúng thực sự mang các biến số sau vào đường ống của bạn và có thể thêm rất nhiều phức tạp:
- Giao thức (Protocol) — hệ thống truyền dữ liệu như thế nào? (HTTP, TCP, REST, GraphQL, FTP, JDBC)
- Định dạng dữ liệu (Data format) — hệ thống hỗ trợ định dạng nào? (Binary, CSV, JSON, Avro)
- Schema dữ liệu và tiến hóa (Data schema and evolution) — dữ liệu được lưu trữ như thế nào? (bảng, Streams, đồ thị, tài liệu)
- SDK và API — hệ thống có cung cấp SDK và API cần thiết không?
- ACID và BASE — nó cung cấp tính nhất quán ACID hay BASE?
- Di chuyển (Migration) — hệ thống có cung cấp cách dễ dàng để di chuyển toàn bộ dữ liệu vào hoặc ra khỏi hệ thống không?
- Độ bền (Durability) — hệ thống có những đảm bảo gì về độ bền?
- Khả dụng (Availability) — hệ thống có những đảm bảo gì về khả dụng? (99,9%, 99,999%)
- Khả năng mở rộng (Scalability) — nó mở rộng như thế nào?
- Bảo mật (Security) — hệ thống an toàn như thế nào?
- Hiệu suất (Performance) — hệ thống xử lý dữ liệu nhanh như thế nào?
- Tùy chọn lưu trữ (Hosting options) — nó được lưu trữ hay chỉ on-premise hay kết hợp?
- Đám mây (Clouds) — nó hoạt động trên đám mây, khu vực của tôi, v.v.?
- Hệ thống bổ sung (Additional systems) — nó có cần hệ thống bổ sung không? (ví dụ: Zookeeper cho Kafka)
Các biến số như định dạng dữ liệu, schema và giao thức cộng lại thành cái gọi là "chi phí biến đổi" (transformation overhead). Các biến số khác như hiệu suất, độ bền và khả năng mở rộng cộng lại thành "chi phí đường ống" (pipeline overhead). Cùng nhau, các phân loại này đóng góp vào cái gọi là "impedance mismatch" (sự không khớp trở kháng). Nếu chúng ta có thể đo lường được điều đó, chúng ta có thể tính toán độ phức tạp và dùng nó để đơn giản hóa hệ thống. Chúng ta sẽ đến phần đó sau chút.
Bây giờ, bạn có thể lập luận rằng hệ thống của bạn, dù có vẻ phức tạp, thực sự là hệ thống đơn giản nhất cho nhu cầu của bạn. Nhưng bạn chứng minh điều đó như thế nào?
Nói cách khác, làm thế nào để thực sự đo lường và biết liệu lớp dữ liệu của bạn có thực sự đơn giản hay phức tạp? Và thứ hai, làm thế nào để ước lượng hệ thống của bạn có vẫn đơn giản khi bạn thêm nhiều tính năng hơn? Đó là, nếu bạn thêm nhiều tính năng trong lộ trình, bạn có cũng cần thêm nhiều hệ thống không?
Đó là lúc "bài kiểm tra impedance mismatch" xuất hiện. Nhưng trước hãy xem impedance mismatch là gì rồi mới đến bài kiểm tra.
Impedance Mismatch là gì?
Thuật ngữ này xuất phát từ kỹ thuật điện để giải thích sự không khớp trong trở kháng điện, dẫn đến mất năng lượng khi năng lượng được chuyển từ điểm A đến điểm B.
Nói đơn giản, nó có nghĩa là những gì bạn có không khớp với những gì bạn cần. Để sử dụng nó, bạn lấy những gì bạn đang có, biến đổi nó thành những gì bạn cần, rồi sử dụng. Do đó có sự không khớp và chi phí liên quan đến việc khắc phục sự không khớp đó.
Trong trường hợp của chúng ta, bạn có dữ liệu dưới một dạng hoặc số lượng nào đó, và bạn cần biến đổi nó trước khi có thể sử dụng. Việc biến đổi có thể xảy ra nhiều lần và thậm chí có thể sử dụng nhiều hệ thống trung gian.
Trong thế giới cơ sở dữ liệu, impedance mismatch xảy ra vì hai lý do:
- Chi phí biến đổi (Transformational overhead): Cách hệ thống xử lý hoặc lưu trữ dữ liệu khác với dạng dữ liệu thực tế hoặc cách bạn nghĩ về nó. Ví dụ: Trên server của bạn, bạn có sự linh hoạt để lưu trữ dữ liệu trong nhiều cấu trúc dữ liệu, như collection, streams, List, Set, Array, v.v. Nó giúp bạn mô hình hóa dữ liệu một cách tự nhiên. Tuy nhiên, bạn cần ánh xạ dữ liệu này vào các bảng trong RDBMS hoặc kho tài liệu JSON để lưu trữ. Sau đó làm ngược lại để đọc dữ liệu. Lưu ý rằng sự không khớp cụ thể giữa mô hình hướng đối tượng và mô hình bảng quan hệ được gọi là "Object-relational impedance mismatch".
- Chi phí đường ống (Pipeline overhead): Số lượng và loại dữ liệu bạn xử lý trên server khác với lượng dữ liệu cơ sở dữ liệu của bạn có thể xử lý. Ví dụ: nếu bạn đang xử lý hàng triệu sự kiện từ thiết bị di động, RDBMS hoặc document store điển hình có thể không thể lưu trữ nó, hoặc cung cấp API để dễ dàng tổng hợp hoặc tính toán các sự kiện đó. Vì vậy, bạn cần các hệ thống xử lý stream đặc biệt, như Kafka hoặc Redis Streams, để xử lý nó và có thể cả data warehouse để lưu trữ.
Bài Kiểm Tra Impedance Mismatch
Mục tiêu của bài kiểm tra là đo lường độ phức tạp của toàn bộ nền tảng và xem độ phức tạp đó tăng hay giảm khi bạn thêm nhiều tính năng trong tương lai.
Cách bài kiểm tra hoạt động là đơn giản tính "chi phí biến đổi" và "chi phí đường ống", sử dụng "Điểm số Impedance Mismatch" (IMS). Điều này sẽ cho bạn biết hệ thống của bạn đã phức tạp như thế nào so với các hệ thống khác, và cũng xem độ phức tạp đó có tăng theo thời gian khi bạn thêm nhiều tính năng hay không.
Dưới đây là công thức tính IMS:

Công thức đơn giản chỉ cộng cả hai loại chi phí rồi chia cho số lượng tính năng. Cách này, bạn sẽ nhận được tổng chi phí/tính năng (ví dụ: điểm độ phức tạp).
Để hiểu rõ hơn, hãy so sánh bốn đường ống dữ liệu đơn giản khác nhau và tính điểm của chúng. Thứ hai, hãy tưởng tượng chúng ta đang xây dựng một ứng dụng đơn giản trong hai giai đoạn, để xem điểm IMS thay đổi như thế nào khi thêm nhiều tính năng theo thời gian.
Giai đoạn 1: Xây dựng bảng điều khiển thời gian thực
Giả sử bạn nhận được hàng triệu sự kiện nhấn nút từ thiết bị di động và cần cảnh báo nếu có bất kỳ sự giảm hoặc tăng đột biến nào. Ngoài ra, bạn coi toàn bộ điều này là một tính năng của ứng dụng lớn hơn.
Trường hợp 1: Giả sử bạn chỉ dùng RDBMS để lưu trữ các sự kiện này, dù bảng có thể không phù hợp.
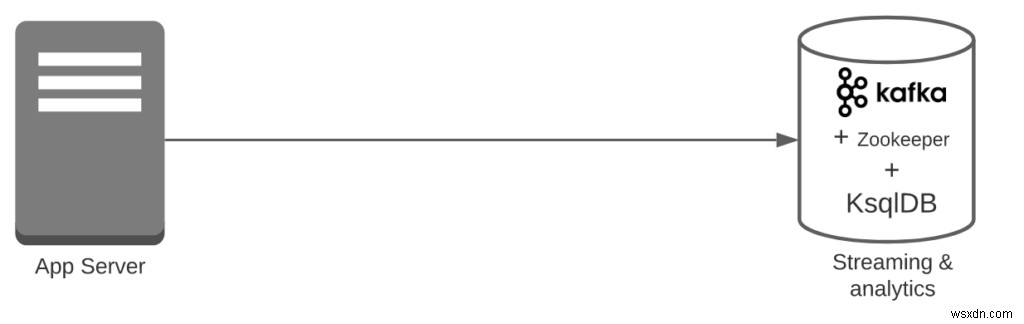
- Chi phí biến đổi = 1
- Bạn cần biến đổi luồng sự kiện thành bảng.
- Chi phí đường ống = 1
- Bạn có một DB duy nhất trong đường ống.
- Số tính năng = 1
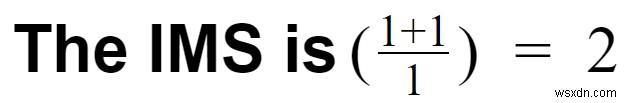
Trường hợp 2: Giả sử bạn dùng Kafka để xử lý các sự kiện rồi lưu vào RDBMS.
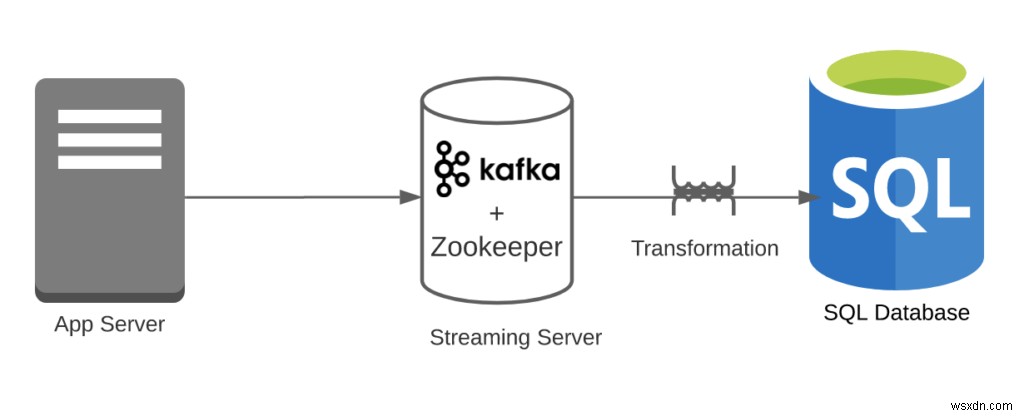
- Chi phí biến đổi = 1
- Kafka xử lý click stream dễ dàng; tuy nhiên, Kafka đến RDBMS là một chi phí.
- Chi phí đường ống = 2
- Bạn có hai hệ thống (RDBMS và Kafka). Lưu ý rằng chúng tôi bỏ qua Zookeeper.
- Số tính năng = 1
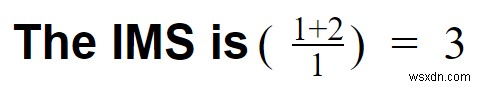
Trường hợp 3: Giả sử bạn dùng Kafka để xử lý các sự kiện rồi lưu vào KsqlDB.
- Chi phí biến đổi = 0
- Kafka xử lý click stream dễ dàng
- Chi phí đường ống = 1
- Bạn chỉ có một hệ thống (Kafka + KSqlDB). Lưu ý: bỏ qua Zookeeper.
- Số tính năng = 1
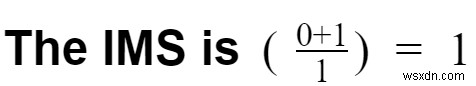
Trường hợp 4: Giả sử bạn dùng Redis Streams để xử lý các sự kiện rồi lưu vào RedisTimeSeries (cả hai đều là một phần của Redis và làm việc bản địa với Redis).
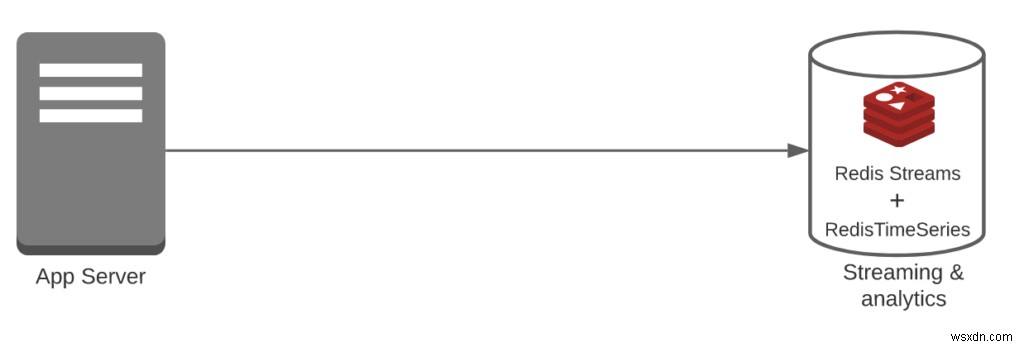
- Chi phí biến đổi = 0
- Redis Streams xử lý click stream dễ dàng
- Chi phí đường ống = 1
- Bạn chỉ có một hệ thống (Redis Streams + RedisTimeSeries)
- Số tính năng = 1
Kết luận sau Giai đoạn 1:
Chúng tôi so sánh bốn hệ thống trong ví dụ này và thấy "Trường hợp 3" hoặc "Trường hợp 4" là đơn giản nhất với IMS = 1. Lúc này, cả hai giống nhau, nhưng chúng có giữ nguyên khi thêm nhiều tính năng không?
Hãy thêm nhiều tính năng vào hệ thống và xem IMS giữ vững như thế nào.
Giai đoạn 2: Xây dựng Bảng Điều Khiển Thời Gian Thực Với IP-Whitelisting
Giả sử bạn xây dựng cùng ứng dụng nhưng muốn đảm bảo chúng chỉ đến từ các địa chỉ IP được whitelist. Bây giờ bạn đang thêm một tính năng mới.
Trường hợp 1: Giả sử bạn chỉ dùng RDBMS lưu sự kiện, dù bảng có thể không phù hợp và dùng Redis hoặc MemCached cho IP-whitelisting.
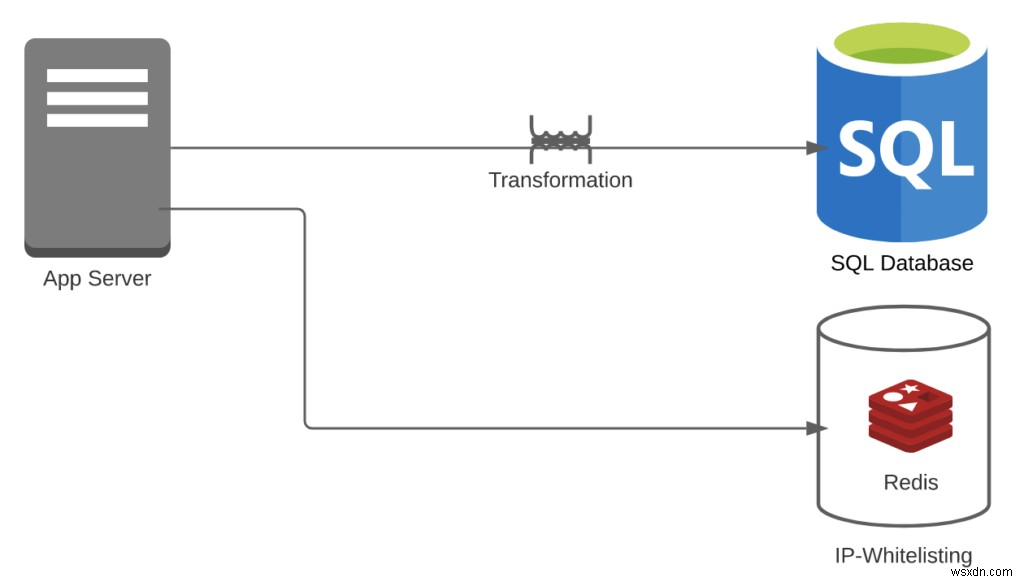
- Chi phí biến đổi = 1
- Đối với IP-whitelisting, không cần biến đổi. Tuy nhiên, bạn cần biến đổi luồng sự kiện thành bảng
- Chi phí đường ống = 2
- Bạn có Redis + RDBMS
- Số tính năng = 2
Trường hợp 2: Giả sử bạn dùng Redis + Kafka + RDBMS.
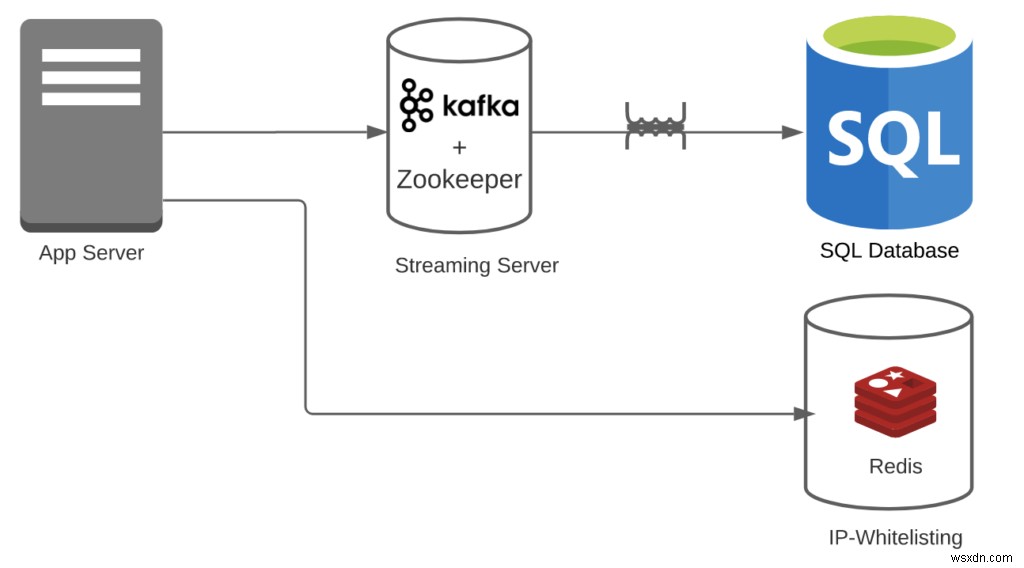
- Chi phí biến đổi = 1
- Đối với IP-whitelisting, không cần biến đổi. Cũng vậy, Kafka xử lý stream dễ dàng.
- Chi phí đường ống = 3
- Bạn có Redis + Kafka + RDBMS. Lưu ý: Chúng tôi bỏ qua việc Kafka cũng cần Zookeeper. Nếu thêm vào, con số sẽ giảm thêm.
- Số tính năng = 2
Trường hợp 3: Giả sử bạn dùng Redis + Kafka + KsqlDB.
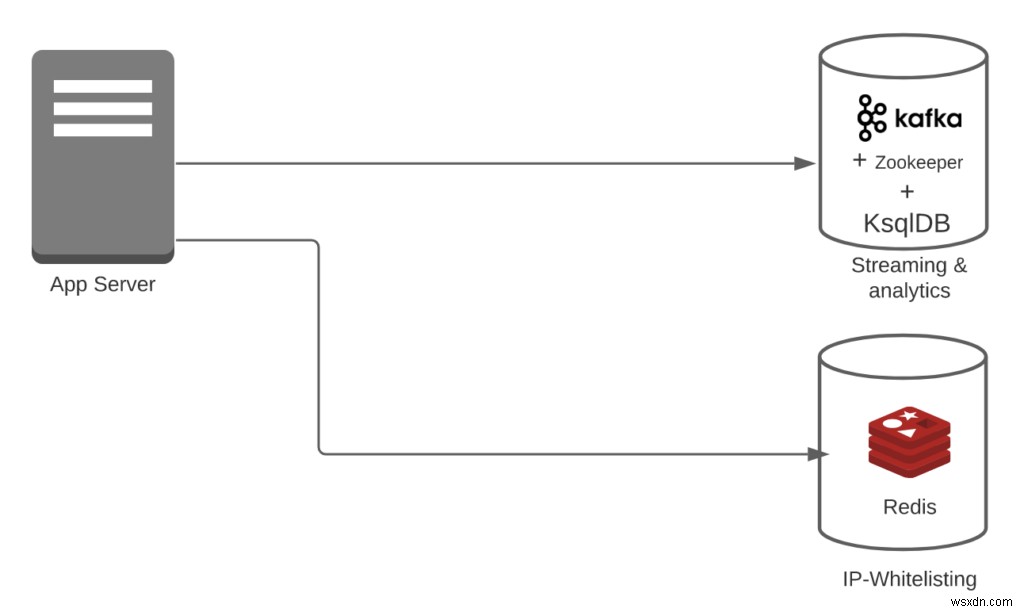
- Chi phí biến đổi = 0
- Đối với IP-whitelisting, không cần biến đổi. Cũng vậy, Kafka và KsqlDB xử lý stream dễ dàng.
- Chi phí đường ống = 2
- Bạn có Redis + (Kafka + KsqlDB). Lưu ý: Ở đây, chúng tôi coi Kafka + KsqlDB là một phần của cùng một hệ thống.
- Số tính năng = 2
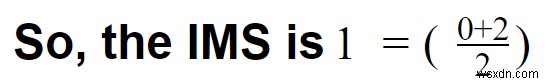
Trường hợp 4: Giả sử bạn dùng Redis + Redis Streams + RedisTimeSeries.
- Chi phí biến đổi = 0
- Đối với IP-whitelisting, không cần biến đổi. Cũng vậy, Redis Streams và RedisTimeSeries xử lý stream và cảnh báo dễ dàng.
- Chi phí đường ống = 1
- Bạn có Redis + Redis Streams + Redis TimeSeries. Lưu ý: Ở đây, cả ba đều là một phần của cùng một hệ thống.
- Số tính năng = 2
Kết luận sau Giai đoạn 2:
Khi chúng ta thêm một tính năng bổ sung,
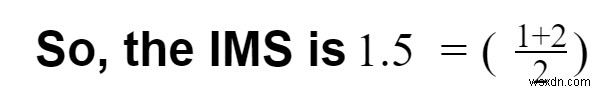
- Trường hợp 1 ở mức 2 ở Giai đoạn-1 và giảm xuống 1,5.
- Trường hợp 2 ở mức 3 ở Giai đoạn-1 và giảm xuống 2
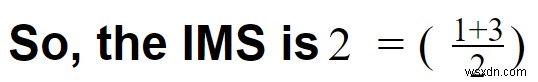
- Trường hợp 3 ở mức 1 ở Giai đoạn-1 và giữ nguyên ở 1
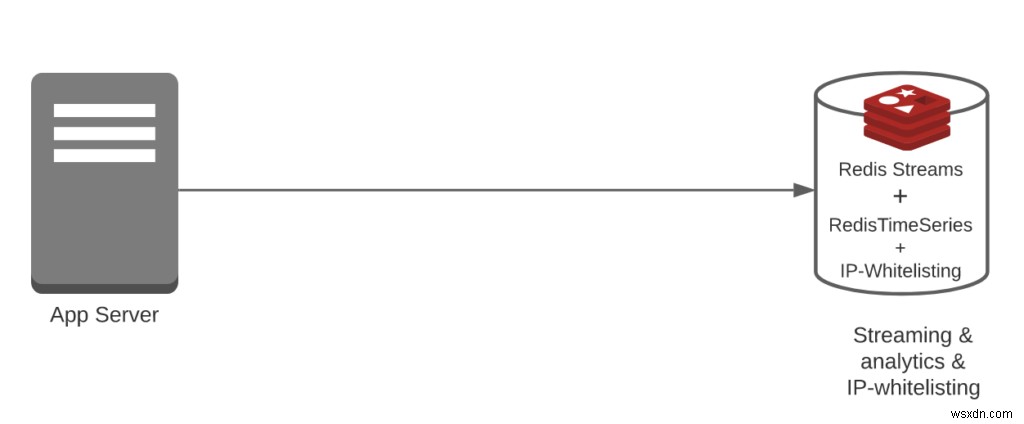
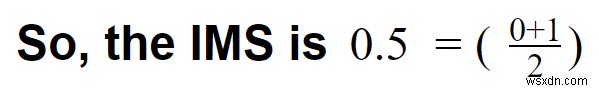
- Trường hợp 4 ở mức 1 ở Giai đoạn-1 và giảm xuống 0,5 (Tốt nhất)
Vì vậy trong ví dụ của chúng tôi, Trường hợp 4, có một trong những điểm IMS thấp nhất là 1, thực sự tốt hơn khi thêm tính năng mới và kết thúc ở 0,5.
Lưu ý: Nếu bạn thêm nhiều hoặc các tính năng khác, Trường hợp 4 có thể không còn là đơn giản nhất. Nhưng đó chính là ý tưởng của điểm IMS. Chỉ cần liệt kê tất cả các tính năng, so sánh các kiến trúc khác nhau, và xem cái nào tốt nhất cho trường hợp sử dụng của bạn.
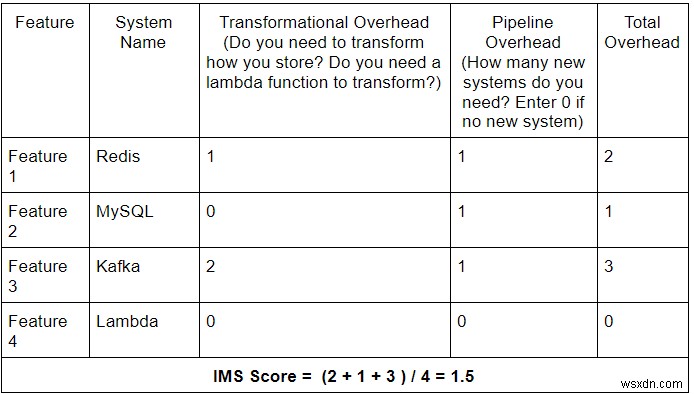
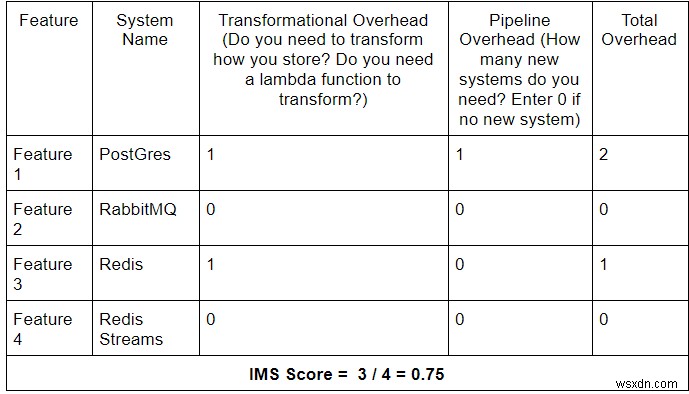
Để làm cho nó thậm chí đơn giản hơn để sử dụng, chúng tôi cung cấp cho bạn một máy tính toán mà bạn có thể triển khai trong một bảng tính đơn giản để tính điểm IMS.
Máy Tính Toán IMS
Cách sử dụng nó:
- Đối với mỗi lớp dữ liệu hoặc đường ống dữ liệu, chỉ cần liệt kê:
- Các tính năng bạn hiện có.
- Các tính năng trong lộ trình. Điều này quan trọng, vì bạn muốn đảm bảo lớp dữ liệu của bạn có thể tiếp tục hỗ trợ các tính năng sắp tới mà không có chi phí bổ sung.
- Sau đó ánh xạ chi phí biến đổi và chi phí đường ống cho mỗi tính năng.
- Và cuối cùng, chia tổng tất cả các chi phí cho số lượng tính năng.
- Lặp lại bước 2 và 3 cho các đường ống với các hệ thống khác nhau để so sánh và đối chiếu chúng.
Đường Ống Dữ Liệu 1
Đường Ống Dữ Liệu 2
Tóm Tắt
Rất dễ bị cuốn theo và xây dựng một lớp dữ liệu phức tạp mà không suy nghĩ về hậu quả. Điểm IMS được tạo ra để giúp bạn có ý thức về quyết định của mình.
Bạn có thể dùng điểm IMS để dễ dàng so sánh và đối chiếu nhiều hệ thống cho trường hợp sử dụng của bạn và xem cái nào thực sự tốt nhất cho tập tính năng của bạn. Bạn cũng có thể kiểm tra xem hệ thống của bạn có chịu đựng được mở rộng tính năng và tiếp tục đơn giản nhất có thể hay không.
Luôn nhớ:
"Đơn giản là sự tinh tế tối thượng" — Leonardo da Vinci
"Hầu hết thông tin đều không liên quan và hầu hết nỗ lực đều bị lãng phí, nhưng chỉ chuyên gia mới biết bỏ qua gì" — James Clear, Atomic Habits