
Hôm nay chúng tôi vui mừng công bố bản General Availability của RedisGraph 2.8. Bài blog này chi tiết các tính năng chính mới hiện có.
Về RedisGraph
RedisGraph là cấu trúc dữ liệu đồ thị (graph data structure) hiệu suất cao, memory-first cho Redis. RedisGraph hỗ trợ multi-tenancy đồ thị (có thể giữ nhiều đồ thị cùng lúc) và phục vụ nhiều client truy cập đồ thị cùng lúc. Giờ cũng có sẵn như một phần của Redis Stack.
Tính Năng Chính Mới Trong RedisGraph 2.8
- Mô hình đồ thị phong phú hơn
- Node đa nhãn (Multi-labeled nodes)
- Khả năng truy vấn nâng cao
- Full-text search nâng cao
- Hỗ trợ thêm construct, function, operator Cypher
- Cải tiến hiệu suất
- Index trên thuộc tính relationship
- Delta Matrices
- Node creation buffer có thể điều khiển
- Benchmarks
https://redis.com/blog/redisgraph-2-8-is-generally-available/ (mở tab mới)
Mô Hình Đồ Thị Phong Phú Hơn
Node Đa Nhãn (Multi-labeled nodes)
Nhiều định nghĩa của mô hình dữ liệu Labelled Property Graph (LPG) (ví dụ: The Property Graph Database Model – Angles, 2018, và ISO/IEC JTC 1/SC 32 – GQL draft) quy định node có thể có nhiều nhãn. Cho đến v2.8, RedisGraph chỉ hỗ trợ một nhãn đơn. Kể từ giờ, có thể thêm nhiều nhãn cho mỗi node mà không giảm hiệu suất hoặc tăng bộ nhớ đáng kể.
Để tạo node với nhiều nhãn, chỉ cần liệt kê tất cả nhãn phân tách bằng dấu hai chấm:
GRAPH.QUERY g "CREATE (e:Employee:BoardMember {Name: 'Vincent Chan', Title: 'Web marketing lead'}) return e"
Để match node với nhiều nhãn (điều kiện AND), dùng cùng ký hiệu dấu hai chấm:
GRAPH.QUERY g "MATCH (e:Employee:BoardMember) return e"
Khả Năng Truy Vấn Nâng Cao
Full-Text Search Nâng Cao
RedisGraph nhúng sẵn RedisSearch và tận dụng cho secondary indexing nhưng cũng có thể dùng cho indexing và tìm kiếm nâng cao. Ví dụ – tìm node dựa trên gần địa lý (geographical proximity) với điểm cho trước trên Trái Đất, hoặc chấm điểm (scoring) item liên quan cao hơn.
Phiên bản 2.8 thêm tùy chọn cấu hình language và stopwords. language định nghĩa ngôn ngữ dùng cho stemming văn bản – thêm dạng gốc của từ vào index. Điều này cho phép query "going" cũng trả kết quả cho "go" và "gone". stopwords là từ rất phổ biến (như "is, the, an, and...") không thêm nhiều thông tin cho search nhưng chiếm nhiều chỗ trong index. Các từ này không được index và bị bỏ qua khi tìm kiếm. Query term có stopword, như "in Paris" sẽ được xem như chỉ "Paris".
Để tạo full-text index trên thuộc tính title của movie dùng ngôn ngữ Đức và stopwords tùy chỉnh cho tất cả node nhãn Movie:
GRAPH.QUERY DEMO_GRAPH "CALL db.idx.fulltext.createNodeIndex({ label: 'Movie', language: 'German', stopwords: ['a', 'ab'] }, 'title')"
RediSearch cung cấp 3 tùy chọn cấu hình field thêm:
- weight – quan trọng của văn bản trong field
- nostem – bỏ qua stemming khi index văn bản
- phonetic – bật tìm kiếm âm thanh (phonetic search) trên văn bản
Để tạo full-text index trên thuộc tính title với phonetic search cho tất cả node nhãn Movie:
GRAPH.QUERY DEMO_GRAPH "CALL db.idx.fulltext.createNodeIndex('Movie', {field: 'title', phonetic: 'dm:en'})"
Hỗ Trợ Thêm Construct, Function, Operator Cypher
RedisGraph 2.8 mở rộng覆盖率 Cypher support:
- Pattern comprehensions
- Hỗ trợ function
allShortestPaths
- Cypher functions:
keys, reduce, replace, none,
vàsingle
- Sao chép attribute-set node trong mệnh đề
SET
- Lọc theo nhãn node trong mệnh đề
WHERE
- Cypher operators:
XOR
và^
Pattern comprehensions
Pattern comprehension là cấu trúc cú pháp (syntactic construct) có sẵn trong Cypher. Trong khi list comprehensions cho phép tạo list dựa trên list hiện có, pattern comprehension là cách điền list với kết quả matching của một pattern. Nó sẽ match pattern chỉ định như mệnh đề
MATCHchuẩn, với predicates như mệnh đề
WHEREchuẩn, nhưng yield một projection chỉ định.
Ví dụ, truy vấn sau trả về list chứa tất cả loại grant (grant types) nhận được bởi nhân viên nam (male employees) nơi số tiền grant lớn hơn $1000.
GRAPH.QUERY g "CREATE (e:Employee {gender:'Male'})-[:granted]->(g:Grant {type: 'Research', amount: 2000})"
GRAPH.QUERY g "MATCH (e:Employee {gender:'Male'}) RETURN [(e)-[:granted]->(g:Grant) WHERE g.amount > 1000 | g.type] AS grantTypes"
Hỗ Trợ Function allShortestPaths
Function
allShortestPathstrả về tất cả shortest paths giữa cặp entity match tất cả tiêu chí. Cả hai entity phải được bound trong scope
WITHtrước đó.
GRAPH.QUERY DEMO_GRAPH "MATCH (c:Actor {name: 'Charlie Sheen'}), (k:Actor {name: 'Kevin Bacon'}) WITH c, k MATCH p = allShortestPaths((c)-[:PLAYED_WITH*]->(k)) RETURN nodes(p) as actors"
Truy vấn này sản xuất tất cả path độ dài tối thiểu kết nối node actor Charlie Sheen đến Kevin Bacon. Có vài path 2-hop giữa hai actor, tất cả sẽ được trả về. Tính toán path sau đó kết thúc, vì chúng ta không quan tâm path dài hơn 2.
Độ dài tối thiểu (phải là 1) và tối đa (phải ít nhất 1) cho tìm kiếm có thể chỉ định. Không hoặc nhiều loại relationship có thể chỉ định (ví dụ
[:R|Q*1..3]). Không property filter được giới thiệu trong pattern.
Hỗ Trợ Function keys Cypher
Function
keyschấp nhận node, relationship, hoặc map làm input, trả về mảng tất cả key input chứa.
MATCH (a) RETURN keys(a)
MATCH ()-[e]->() RETURN keys(e)
RETURN keys({a:1, b:2})
Hỗ Trợ Function reduce Cypher
Function
reducechấp nhận giá trị bắt đầu và một list. Nó cập nhật giá trị bằng cách evaluate biểu thức chống lại mỗi element của list.
GRAPH.QUERY g "RETURN reduce(sum = 0, n IN range(1,10) | sum + n)"
Output của function này sẽ là 55 – tổng số nguyên 1 đến 10.
GRAPH.QUERY g "RETURN reduce(arr = [], n IN range(1,10) | arr + [n*n])"
Output sẽ là mảng chứa bình phương các số nguyên 1 đến 10.
Hỗ Trợ Function replace Cypher String
Thay thế tất cả occurrence của substring cho trước bằng substring khác. Function nhận 3 tham số: chuỗi gốc, occurrence cần thay, và thay bằng gì.
GRAPH.QUERY g "RETURN replace('abc*efg', '*', 'd')"
Giá trị trả về sẽ là 'abcdefg'.
Function này cũng có thể xóa substring bằng cách thay bằng chuỗi rỗng ('').
Hỗ Trợ Function none và single Cypher
Cho một list, none trả true nếu predicate không đúng cho bất kỳ element nào, single trả true nếu predicate đúng cho đúng một element.
GRAPH.QUERY g "RETURN none(x IN range(1,10) WHERE x>10)"
GRAPH.QUERY g "RETURN single(x IN range(1,10) WHERE x>9)"
Các function này tương tự function all và any.
Use case khả thi: lọc path:
graph.query DEMO_GRAPH “MATCH p = (a {name:’Johnny Depp’})-[*2..5]->(b {name:’Kevin Bacon’}) WHERE none(n IN nodes(p) WHERE n.year > 1970) RETURN p”
Truy vấn này trả về tất cả path độ dài 2 đến 5 từ Johnny Depp đến Kevin Bacon, không bao gồm actor sinh sau 1970.
Hỗ Trợ Sao Chép Node Attribute Set Trong Mệnh Đề SET
Mệnh đề
SETcó thể dùng để thay thế hoặc append tất cả giá trị property của một node bằng property của node khác.
Truy vấn sau match hai entity, rồi thay thế tất cả property của a bằng property của b:
GRAPH.QUERY g "MATCH (a {v: 1}), (b {v: 2}) SET a = b"
Truy vấn sau match hai entity, rồi thêm (hoặc thay giá trị) property của a bằng property của b:
GRAPH.QUERY g "MATCH (a {v: 1}), (b {v: 2}) SET a += b"
Chúng ta cũng có thể thay loại relationship mà không thay property:
GRAPH.QUERY g "MATCH (a)-[b]->(c) WHERE ID(b)=0 CREATE (a)-[d:bar]->(c) SET d=b DELETE b RETURN d"
Hỗ Trợ Lọc Theo Nhãn Node Trong Mệnh Đề WHERE
Giờ có thể lọc theo nhãn node hoặc loại relationship cũng trong mệnh đề WHERE:
GRAPH.QUERY g "MATCH (a) WHERE a:L RETURN a"
GRAPH.QUERY g "MATCH (a)-[b]-(c) WHERE b:L RETURN b"
Hỗ Trợ Toán Tử Cypher XOR và ^
GRAPH.QUERY g "RETURN true XOR true”
GRAPH.QUERY g "RETURN 2 ^ 3”
Kết quả lần lượt là
falsevà
8.
Cải Tiến Hiệu Suất
Index Trên Thuộc Tính Relationship
Đối với node, ta tạo index bằng lệnh:
GRAPH.QUERY g "CREATE INDEX FOR (n:GRANTS) ON (n.GrantedBy)"
Giờ có thể tạo index cho relationship:
GRAPH.QUERY g "CREATE INDEX FOR ()-[r:R]-() ON (r.prop)"
Xét truy vấn:
GRAPH.QUERY g "MATCH (a)-[r:R {prop:5}]-(b) return *"
Quan sát execution plan trước khi tạo index:
redis:6379> GRAPH.EXPLAIN g "MATCH (a)-[r:R {prop:5}]-(b) return *"
1) "Results" 2) " Project" 3) " Filter" 4) " Conditional Traverse | (a)-[r:R]->(b)" 5) " All Node Scan | (a)" |
Execution plan sau khi tạo index:
redis:6379> GRAPH.EXPLAIN g "MATCH (a)-[r:R {prop:5}]-(b) return *"
1) "Results" 2) " Project" 3) " Edge By Index Scan | [r:R]" |
Delta Matrices
Kể từ v2.8, thêm/xóa node và relationship đồ thị nhanh hơn nhiều, vì chúng được cập nhật trước trong delta matrices nhỏ. Main matrices sau đó bulk-updated.
Trong RedisGraph, đồ thị được biểu diễn bằng adjacency matrices. Mỗi nhãn node và mỗi loại relationship trong đồ thị có matrix riêng. Trước đây, mỗi lần thêm node mới, tất cả matrix cần resize, và database càng lớn, càng tốn thời gian.
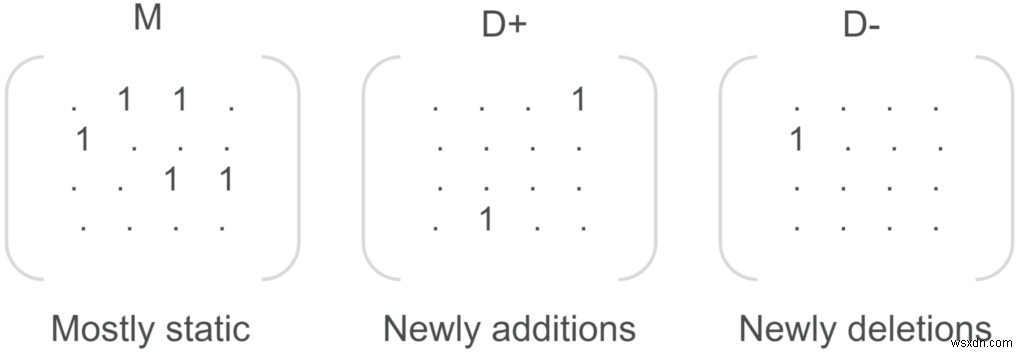
Kể từ v2.8, thời gian chèn node và relationship mới nhỏ đáng kể và không phụ thuộc vào kích thước đồ thị nữa. Tối ưu này đạt được bằng giới thiệu hai delta matrix cho mỗi matrix trong đồ thị: một cho thêm node (D+) và một cho xóa node (D-). Thêm/xóa node phản ánh trong delta matrix thích hợp, và khi delta matrix đạt ngưỡng 10000 node (có thể cấu hình qua tham số
DELTA_MAX_PENDING_CHANGES), nó đồng bộ với main matrix trong một bulk operation đơn, làm rỗng, và chu kỳ giống nhau bắt đầu lại.
Node Creation Buffer Có Thể Điều Khiển
Tham số cấu hình load-time mới, NODE_CREATION_BUFFER, kiểm soát lượng bộ nhớ dự trữ trong matrices cho tạo node tương lai. Ví dụ, khi set 16,384, matrices sẽ có không gian thêm cho 16384 node khi tạo. Khi không gian thêm cạn kiệt, kích thước matrices tăng thêm 16384.
Giảm giá trị này sẽ giảm tiêu thụ bộ nhớ, nhưng gây giảm hiệu suất do tăng tần suất reallocate matrix. Ngược lại, tăng nó có thể cải thiện hiệu suất workload write-heavy nhưng tăng tiêu thụ bộ nhớ.
Nếu đối số không phải lũy thừa của 2, nó sẽ làm tròn lên lũy thừa 2 tiếp theo để cải thiện memory alignment.
Benchmarks
Chúng tôi cũng thêm nhiều cải tiến hiệu suất khác ngoài delta matrices. Chúng tôi demo cải tiến dưới dùng benchmark LDBC SNB.
LDBC SNB (Linked Data Benchmark Council – Social Network Benchmarks) là benchmark tiêu chuẩn ngành so sánh workload đọc/ghi thực tế của graph database.
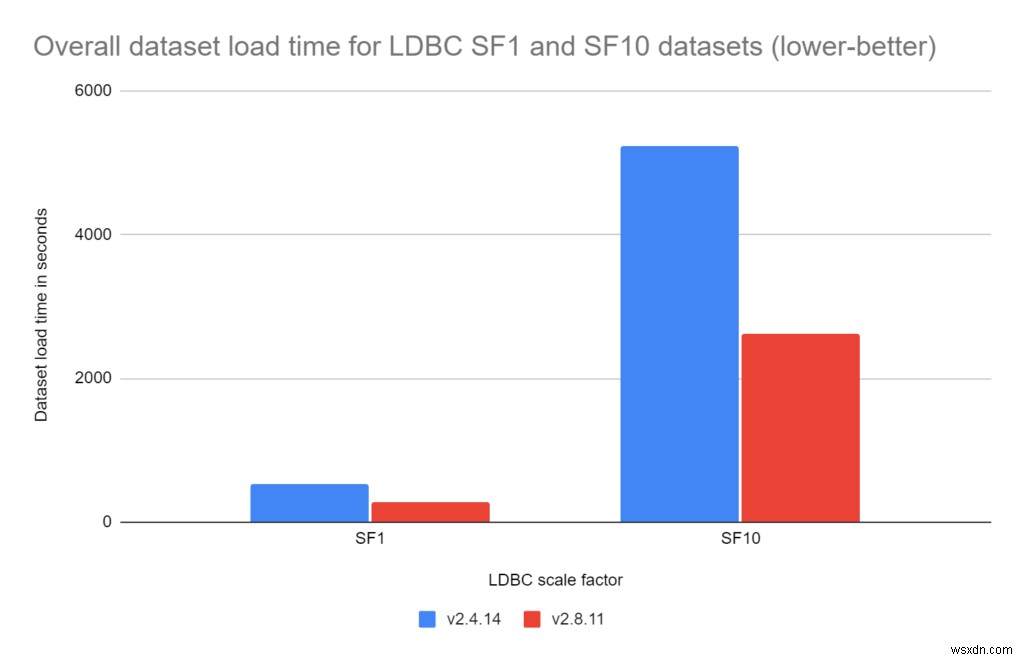
Tổng thể data load nhanh hơn nhiều trong RedisGraph 2.8:
- LDBC scale factor 1:
RedisGraph 2.8 nhanh 1.92 lần RedisGraph 2.4 - LDBC scale factor 10:
RedisGraph 2.8 nhanh 2.00 lần RedisGraph 2.4
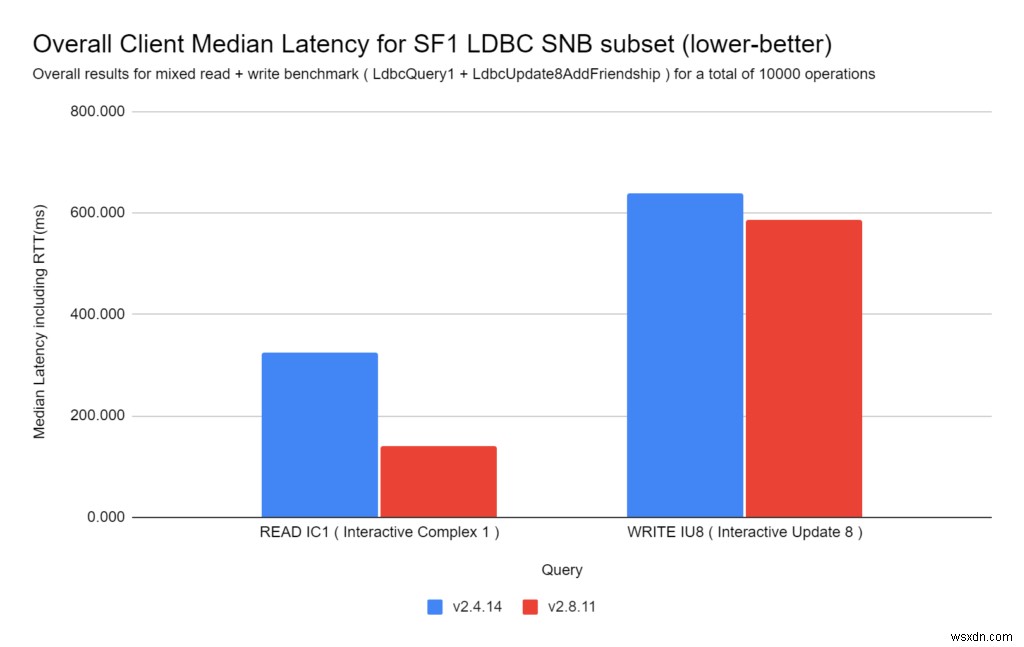
LDBC queries (cả read và write) thực thi nhanh hơn nhiều trong RedisGraph 2.8:
- Read queries:
RedisGraph 2.8 nhanh 2.32 lần RedisGraph 2.4 - Write queries:
RedisGraph 2.8 nhanh 1.09 lần RedisGraph 2.4
Khôi phục và đồng bộ dữ liệu (RDB và AOF) cũng nhanh hơn nhiều (lên tới vài bậc magnitude trong một số tình huống).
RedisGraph Là Phần Của Redis Stack
RedisGraph giờ là phần của Redis Stack. Bạn có thể tải binary Redis Stack Server mới nhất cho macOS, Ubuntu, hoặc Redhat, hoặc cài đặt với Docker, Homebrew, hoặc Linux.
Trải Nghiệm RedisGraph Dùng RedisInsight
RedisInsight là công cụ trực quan cho dev cung cấp cách tuyệt vời khám phá dữ liệu từ RedisTimes trong quá trình phát triển dùng Redis hoặc Redis Stack.
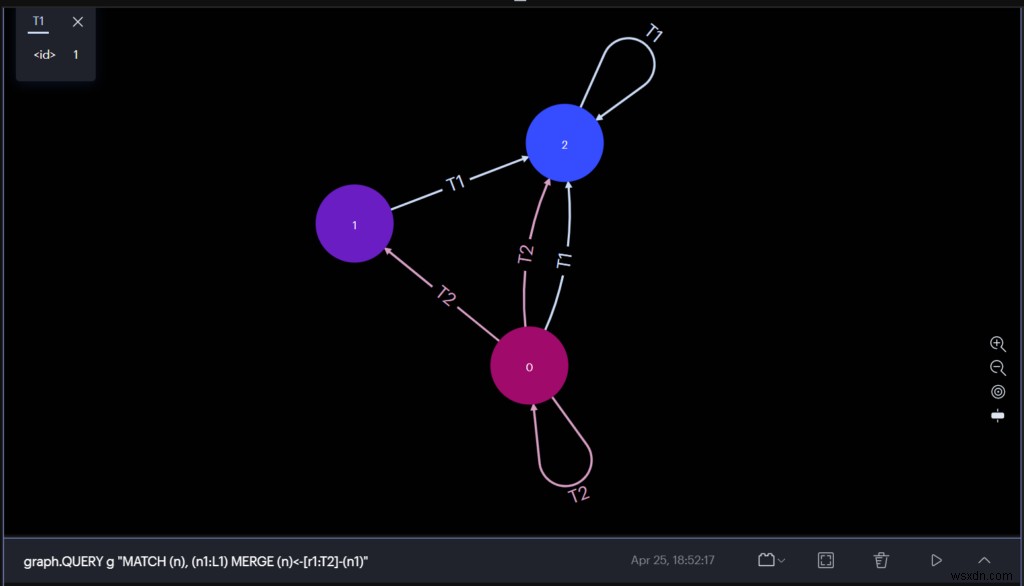
Bạn có thể thực thi graph query và quan sát kết quả trực tiếp từ giao diện đồ họa. RedisInsight giờ có thể visualize kết quả truy vấn RedisGraph.
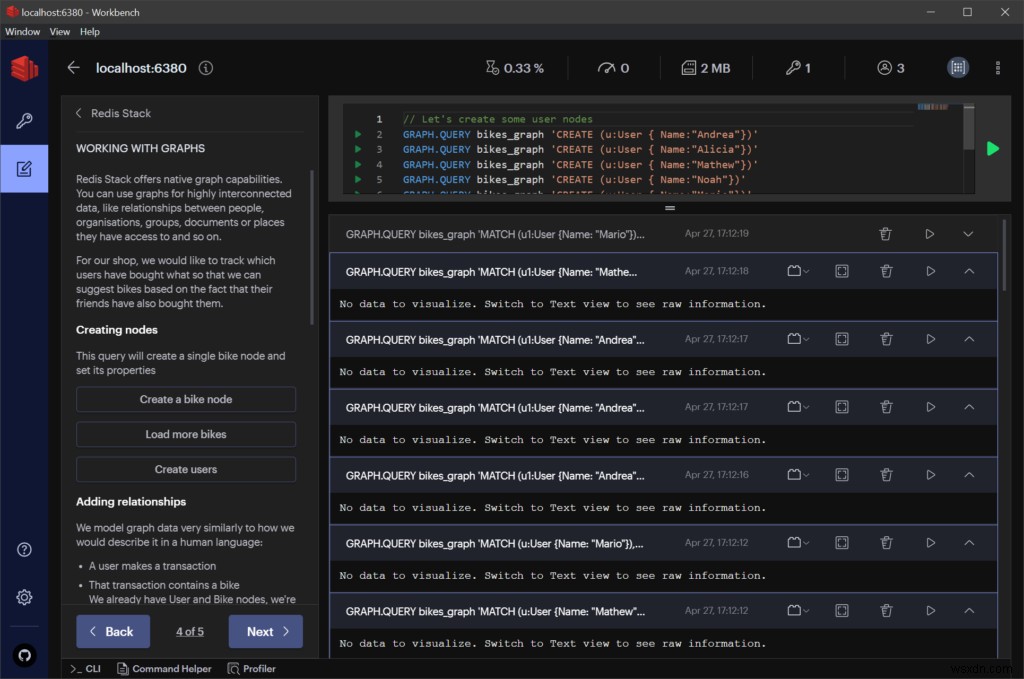
Thêm vào đó, RedisInsight chứa quick guide và tutorial học RedisGraph tương tác.
Tìm hiểu thêm về RedisGraph trên redis.io và developer.redis.com.