Điều tra dân số (Census) là việc ghi nhận thông tin về một dân số cho trước theo cách hệ thống. Dữ liệu thu thập bao gồm nhiều loại thông tin như dân số, kinh tế, nhà ở v.v. Điều này giúp chính phủ hiểu tình hình hiện tại cũng như lập kế hoạch cho tương lai. Trong bài viết này, chúng ta sẽ thấy cách tận dụng Python để phân tích dữ liệu điều tra dân số của Ấn Độ. Chúng ta sẽ xem xét các khía cạnh dân số và kinh tế. Sau đó vẽ biểu đồ thể hiện phân tích dưới dạng đồ họa. Nguồn dữ liệu thu thập từ Kaggle.
Tổ chức dữ liệu
Trong chương trình dưới đây, trước tiên ta lấy dữ liệu bằng chương trình Python ngắn. Nó chỉ load dữ liệu vào pandas DataFrame để phân tích tiếp. Kết quả hiển thị một vài trường để biểu diễn đơn giản.
Ví dụ
import pandas as pd
du_lieu_vao = pd.read_csv('E:\\india-districts-census-2011.csv')
# https://www.kaggle.com/danofer/india-census#india-districts-census-2011.csv
print(du_lieu_vao)
Kết quả
Chạy mã trên cho kết quả sau:
   District code ... Total_Power_Parity
0              1 ...             1119
1              2 ...             1066
2              3 ...              242
3              4 ...              214
4              5 ...              629
..           ... ...              ...
635          636 ...            10027
636          637 ...             4890
637          638 ...             3151
638          639 ...             3151
639          640 ...             5782
[640 rows x 118 columns]
Phân tích sự tương đồng giữa hai bang
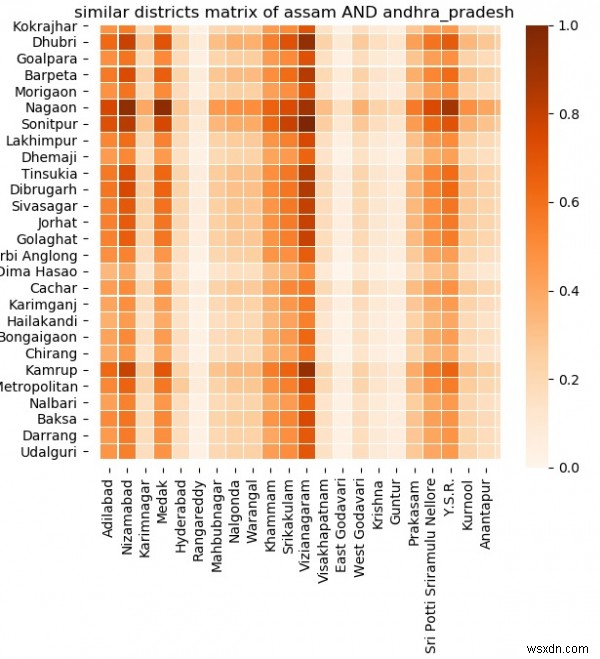
Sau khi thu thập dữ liệu, ta có thể phân tích sự tương đồng trên nhiều mặt giữa hai bang. Sự tương đồng có thể dựa trên nhóm tuổi, sở hữu máy tính, nhà ở, trình độ học vấn, v.v. Trong ví dụ dưới đây, ta lấy hai bang Assam và Andhra Pradesh. Sau đó so sánh hai bang sử dụng similarity_matrix. Tất cả các trường dữ liệu được so sánh cho mỗi cặp quận có thể từ cả hai bang. Heatmap kết quả cho thấy hai bang liên quan như thế nào. Màu càng đậm càng liên quan chặt chẽ.
Ví dụ
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib.colors import Normalize
import seaborn as sns
import math

du_lieu_vao = pd.read_csv('E:\\india-districts-census-2011.csv')
df_ASSAM = du_lieu_vao.loc[du_lieu_vao['State name'] == 'ASSAM']
df_ANDHRA_PRADESH = du_lieu_vao.loc[du_lieu_vao['State name'] == 'ANDHRA PRADESH']

def doan(x1, x2):
    # Đặt chỉ số cho cả hai DataFrame
    x1.set_index('District code')
    x2.set_index('District code')
    # Ma trận tương đồng kích thước len(x1) x len(x2)
    ma_tran_tuong_dong = []
    # Duyệt qua hàng của df1
    for r1 in x1.iterrows():
        # Tạo list giữ điểm tương đồng của hàng 1 với các hàng khác của x2
        y = []
        # Duyệt qua hàng của x2
        for r2 in x2.iterrows():
            # Tính tổng bình phương hiệu
            n = 0
            for c in list(du_lieu_vao)[3:]:
                max_c = max(du_lieu_vao[c])
                min_c = min(du_lieu_vao[c])
                n += pow((r1[1][c] - r2[1][c]) / (max_c - min_c), 2)
            # Căn bậc hai và nghịch đảo kết quả
            y.append(1 / math.sqrt(n))
        # Thêm điểm tương đồng
        ma_tran_tuong_dong.append(y)
    p = q = r = 0
    for m in range(len(ma_tran_tuong_dong)):
        for n in range(len(ma_tran_tuong_dong[m])):
            if ma_tran_tuong_dong[m][n] > p:
                p = ma_tran_tuong_dong[m][n]
                q = m
                r = n
    print("%s từ ASSAM và %s từ ANDHRA PRADESH giống nhất" % (x1['District name'].iloc[q], x2['District name'].iloc[r]))
    return ma_tran_tuong_dong

m = doan(df_ASSAM, df_ANDHRA_PRADESH)
chu_hoa = Normalize()
s = plt.axes()
sns.heatmap(chu_hoa(m), xticklabels=df_ANDHRA_PRADESH['District name'], yticklabels=df_ASSAM['District name'], linewidths=0.05, cmap='Oranges').set_title("Ma trận quận tương đồng Assam và Andhra Pradesh")
plt.rcParams['figure.figsize'] = (20, 20)
plt.show()
Kết quả
Chạy mã trên cho kết quả sau:
So sánh tham số cụ thể
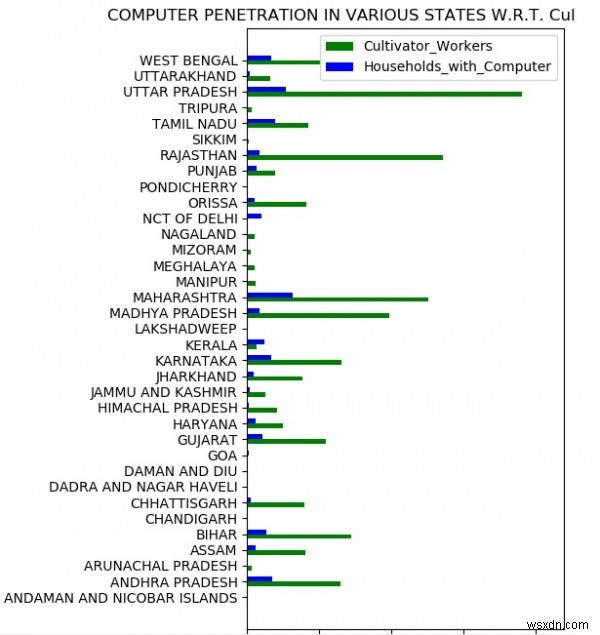
Ta cũng có thể so sánh các địa điểm theo tham số cụ thể. Trong ví dụ dưới đây, ta so sánh sự sẵn có của máy tính trong hộ gia đình đối với lao động nông nghiệp. Ta tạo biểu đồ so sánh hai tham số này cho từng bang.
Ví dụ
import pandas as pd
import matplotlib.pyplot as plt
from numpy import *

du_lieu_vao = pd.read_csv('E:\\india-districts-census-2011.csv')
z = du_lieu_vao.groupby(by="State name")
m = []
w = []
for k, g in z:
    t = 0
    t1 = 0
    for r in g.iterrows():
        t += r[1][36]
        t1 += r[1][21]
    m.append((k, t))
    w.append((k, t1))

mp = pd.DataFrame({
    'state': [x[0] for x in m],
    'Households_with_Computer': [x[1] for x in m],
    'Cultivator_Workers': [x[1] for x in w]
})

d = arange(35)
wi = 0.3
fig, f = plt.subplots()
plt.xlim(0, 22000000)
r1 = f.barh(d, mp['Cultivator_Workers'], wi, color='g', align='center')
r2 = f.barh(d + wi, mp['Households_with_Computer'], wi, color='b', align='center')
f.set_xlabel('Dân số')
f.set_title('XUẤT HIỆN MÁY TÍNH CÁC BANG THEO LAO ĐỘNG NÔNG NGHIỆP')
f.set_yticks(d + wi / 2)
f.set_yticklabels((x for x in mp['state']))
f.legend((r1[0], r2[0]), ('Cultivator_Workers', 'Households_with_Computer'))
plt.rcParams.update({'font.size': 15})
plt.rcParams['figure.figsize'] = (15, 15)
plt.show()
Kết quả
Chạy mã trên cho kết quả sau: