Thống kê là nền tảng để học Machine Learning và AI. Vì Python là ngôn ngữ lựa chọn cho các công nghệ này, chúng ta sẽ thấy cách viết chương trình Python kết hợp phân tích thống kê. Trong bài viết này, chúng ta sẽ thấy cách tạo đồ thị và biểu đồ sử dụng các mô-đun Python khác nhau. Sự đa dạng biểu đồ giúp chúng ta phân tích dữ liệu nhanh chóng và rút ra kết luận trực quan.
Chuẩn bị dữ liệu
Chúng ta lấy bộ dữ liệu chứa thông tin về các loại hạt. Bộ dữ liệu này có sẵn tại Kaggle. Nó có tám cột sẽ được dùng để tạo các loại biểu đồ so sánh đặc điểm của các loại hạt khác nhau. Chương trình dưới đây tải bộ dữ liệu từ môi trường local và hiển thị mẫu các hàng.
Ví dụ
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
du_lieu_vao = pd.read_csv('E:\\seeds.csv')
# https://www.kaggle.com/jmcaro/wheat-seeds
print(du_lieu_vao)
Kết quả
Chạy mã trên cho kết quả sau:
     Area  Perimeter  Compactness ... Asymmetry.Coeff  Kernel.Groove  Type
0   15.26      14.84       0.8710 ...           2.221          5.220     1
1   14.88      14.57       0.8811 ...           1.018          4.956     1
2   14.29      14.09       0.9050 ...           2.699          4.825     1
3   13.84      13.94       0.8955 ...           2.259          4.805     1
4   16.14      14.99       0.9034 ...           1.355          5.175     1
..    ...        ...          ... ...             ...            ...   ...
194 12.19      13.20       0.8783 ...           3.631          4.870     3
195 11.23      12.88       0.8511 ...           4.325          5.003     3
196 13.20      13.66       0.8883 ...           8.315          5.056     3
197 11.84      13.21       0.8521 ...           3.598          5.044     3
198 12.30      13.34       0.8684 ...           5.637          5.063     3
[199 rows x 8 columns]
Tạo Histogram (Biểu đồ tần suất)
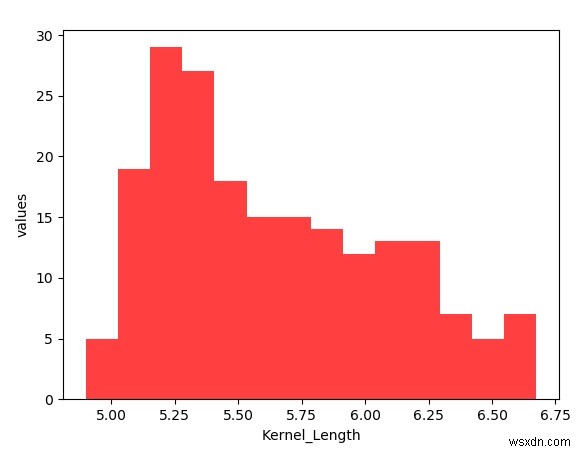
Để tạo histogram, chúng ta bỏ hàng tiêu đề khỏi file csv và đọc file như mảng numpy. Sau đó dùng mô-đun genfromtxt để đọc file. Trường kernel length (độ dài hạt) nằm ở chỉ số cột 3 trong mảng. Cuối cùng dùng matplotlib để vẽ histogram từ tập dữ liệu do numpy tạo và thêm nhãn cần thiết.
Ví dụ
import matplotlib.pyplot as plt
import numpy as np
from numpy import genfromtxt

du_lieu_hat = genfromtxt('E:\\seeds.csv', delimiter=',')
do_dai_hat = du_lieu_hat[:, [3]]
x = len(do_dai_hat)
y = np.sqrt(x)
y = int(y)
z = plt.hist(do_dai_hat, bins=y, color='#FF4040')
z = plt.xlabel('Kernel_Length')
z = plt.ylabel('values')
plt.show()
Kết quả
Chạy mã trên cho kết quả sau:
Hàm phân phối tích lũy kinh nghiệm (Empirical Cumulative Distribution Functions - ECDF)
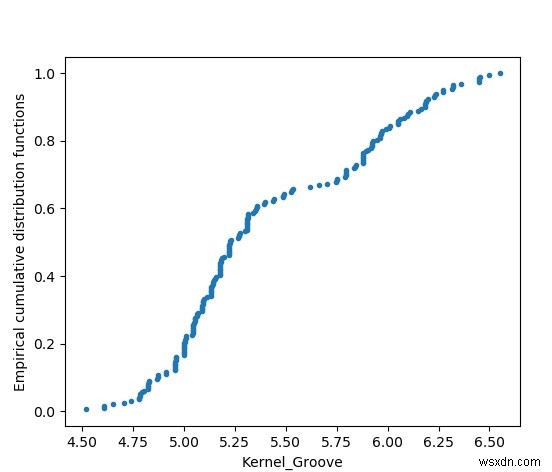
Biểu đồ này cho thấy đồ thị kích thước rãnh hạt phân bố trên tập dữ liệu. Nó được sắp xếp từ giá trị nhỏ nhất đến lớn nhất và hiển thị dưới dạng phân phối.
Ví dụ
import matplotlib.pyplot as plt
import numpy as np
from numpy import genfromtxt

du_lieu_hat = genfromtxt('E:\\seeds.csv', delimiter=',')
ranh_hat = du_lieu_hat[:, 6]

def ECDF(du_lieu):
    # Empirical cumulative distribution functions
    n = len(du_lieu)
    x = np.sort(du_lieu)
    y = np.arange(1, n + 1) / n
    return x, y

x, y = ECDF(ranh_hat)
plt.plot(x, y, marker='.', linestyle='none')
plt.xlabel('Kernel_Groove')
plt.ylabel('Empirical cumulative distribution functions')
plt.show()
Kết quả
Chạy mã trên cho kết quả sau:
Biểu đồ bầy ong (Bee swarm plots)
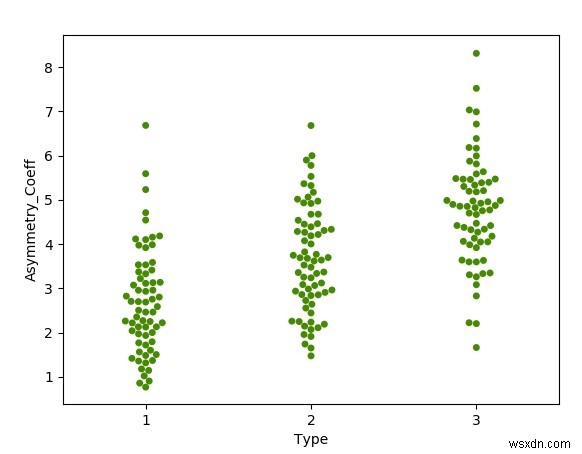
Biểu đồ bầy ong (beeswarm plot) hiển thị kích thước một nhóm điểm dữ liệu bằng cách nhóm trực quan từng điểm dữ liệu riêng lẻ. Chúng ta dùng thư viện seaborn để tạo biểu đồ này. Chúng ta dùng cột Type từ tập dữ liệu để gom các loại hạt tương tự lại với nhau.
Ví dụ
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

du_lieu_vao = pd.read_csv('E:\\seeds.csv')
sns.swarmplot(x='Type', y='Asymmetry.Coeff', data=du_lieu_vao, color='#458B00')
plt.xlabel('Type')
plt.ylabel('Asymmetry_Coeff')
plt.show()
Kết quả
Chạy mã trên cho kết quả sau: