
Mọi doanh nghiệp đều phụ thuộc vào sự trung thành của khách hàng. Doanh thu lặp lại từ khách hàng là một trong những yếu tố then chốt cho lợi nhuận kinh doanh. Vì vậy, việc biết lý do khách hàng rời bỏ một doanh nghiệp là rất quan trọng. Khách hàng rời bỏ được gọi là customer churn. Bằng cách nhìn vào xu hướng quá khứ, chúng ta có thể đánh giá những yếu tố ảnh hưởng đến customer churn và dự đoán xem một khách hàng cụ thể có khả năng rời bỏ hay không. Trong bài viết này, chúng ta sẽ dùng thuật toán ML để nghiên cứu xu hướng quá khứ về customer churn và sau đó dự đoán khách hàng nào có khả năng churn.
Chuẩn bị dữ liệu
Là ví dụ, chúng ta xem xét customer churn trong viễn thông. Dữ liệu nguồn có sẵn tại Kaggle. URL tải dữ liệu được đề cập trong chương trình dưới đây. Chúng ta dùng thư viện Pandas để load file csv vào chương trình Python và xem một vài hàng mẫu.
Ví dụ
import pandas as pd
# Tải Telco-Customer-Churn.csv dataset
# https://www.kaggle.com/blastchar/telco-customer-churn
du_lieu_vao = pd.read_csv('E:\\Telecom_customers.csv')
print("Dữ liệu đầu vào:\n", du_lieu_vao)
Kết quả
Chạy mã trên cho kết quả sau:
Given input data:
   customerID gender SeniorCitizen ... MonthlyCharges TotalCharges Churn
0  7590-VHVEG Female 0 ... 29.85 29.85 No
1  5575-GNVDE Male 0 ... 56.95 1889.5 No
2  3668-QPYBK Male 0 ... 53.85 108.15 Yes
3  7795-CFOCW Male 0 ... 42.30 1840.75 No
4  9237-HQITU Female 0 ... 70.70 151.65 Yes
... ... ... ... ... ... ... ...
7038 6840-RESVB Male 0 ... 84.80 1990.5 No
7039 2234-XADUH Female 0 ... 103.20 7362.9 No
7040 4801-JZAZL Female 0 ... 29.60 346.45 No
7041 8361-LTMKD Male 1 ... 74.40 306.6 Yes
7042 3186-AJIEK Male 0 ... 105.65 6844.5 No
[7043 rows x 21 columns]
Nghiên cứu mô hình hiện có
Tiếp theo, chúng ta nghiên cứu tập dữ liệu để tìm các mô hình hiện có khi churn xảy ra. Chúng ta cũng loại bỏ một số cột không ảnh hưởng đến điều kiện. Ví dụ, cột customerID không ảnh hưởng đến việc khách hàng rời bỏ hay không, nên loại bỏ bằng phương thức drop hoặc pop. Sau đó vẽ biểu đồ tròn thể hiện tỷ lệ churn trong tập dữ liệu.
Ví dụ 2
import pandas as pd
import matplotlib.pyplot as plt
from matplotlib import rcParams

du_lieu_vao = pd.read_csv('E:\\Telecom_customers.csv')
print("Dữ liệu đầu vào:\n", du_lieu_vao)

# Loại bỏ cột
du_lieu_vao.drop(['customerID'], axis=1, inplace=True)
du_lieu_vao.pop('TotalCharges')
du_lieu_vao['OnlineBackup'].unique()
data = du_lieu_vao['Churn'].value_counts(sort=True)
mau_sac = ["#BDFCC9", "#FFDEAD"]
rcParams['figure.figsize'] = 9, 9
explode = [0.2, 0.2]
plt.pie(data, explode=explode, colors=mau_sac, autopct='%1.1f%%', shadow=True, startangle=180)
plt.title('Tỷ lệ Churn trong dữ liệu cho trước')
plt.show()
Kết quả
Chạy mã trên cho kết quả sau:
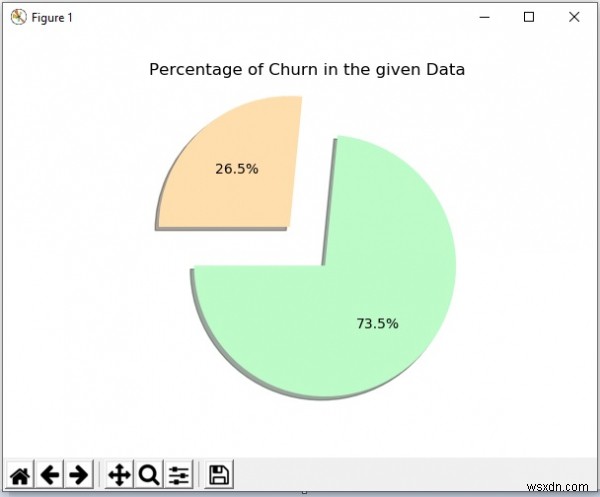
Tiền xử lý dữ liệu
Để dữ liệu sẵn sàng cho thuật toán ML, chúng ta gán nhãn (label encoding) cho tất cả các trường. Chuyển đổi giá trị văn bản thành cờ số. Ví dụ, giá trị trong cột gender thay thành 0 và 1 thay vì male và female. Điều này giúp sử dụng các trường đó trong tính toán và thuật toán đánh giá tác động của các trường này lên giá trị churn. Chúng ta dùng phương thức LabelEncoder từ sklearn.
Ví dụ 3
import pandas as pd
from sklearn import preprocessing

label_encoder = preprocessing.LabelEncoder()
du_lieu_vao['gender'] = label_encoder.fit_transform(du_lieu_vao['gender'])
du_lieu_vao['Partner'] = label_encoder.fit_transform(du_lieu_vao['Partner'])
du_lieu_vao['Dependents'] = label_encoder.fit_transform(du_lieu_vao['Dependents'])
du_lieu_vao['PhoneService'] = label_encoder.fit_transform(du_lieu_vao['PhoneService'])
du_lieu_vao['MultipleLines'] = label_encoder.fit_transform(du_lieu_vao['MultipleLines'])
du_lieu_vao['InternetService'] = label_encoder.fit_transform(du_lieu_vao['InternetService'])
du_lieu_vao['OnlineSecurity'] = label_encoder.fit_transform(du_lieu_vao['OnlineSecurity'])
du_lieu_vao['OnlineBackup'] = label_encoder.fit_transform(du_lieu_vao['OnlineBackup'])
du_lieu_vao['DeviceProtection'] = label_encoder.fit_transform(du_lieu_vao['DeviceProtection'])
du_lieu_vao['TechSupport'] = label_encoder.fit_transform(du_lieu_vao['TechSupport'])
du_lieu_vao['StreamingTV'] = label_encoder.fit_transform(du_lieu_vao['StreamingTV'])
du_lieu_vao['StreamingMovies'] = label_encoder.fit_transform(du_lieu_vao['StreamingMovies'])
du_lieu_vao['Contract'] = label_encoder.fit_transform(du_lieu_vao['Contract'])
du_lieu_vao['PaperlessBilling'] = label_encoder.fit_transform(du_lieu_vao['PaperlessBilling'])
du_lieu_vao['PaymentMethod'] = label_encoder.fit_transform(du_lieu_vao['PaymentMethod'])
du_lieu_vao['Churn'] = label_encoder.fit_transform(du_lieu_vao['Churn'])

print("Dữ liệu sau label encoder:\n", du_lieu_vao)

# Tách đặc trưng (X) và nhãn (y)
du_lieu_vao["Churn"] = du_lieu_vao["Churn"].astype(int)
y = du_lieu_vao["Churn"].values
X = du_lieu_vao.drop(labels=["Churn"], axis=1)
print("\nĐã tách X và y:")
print("y -", y)
print("X -", X)
Kết quả
Chạy mã trên cho kết quả sau:
input data after label encoder ...
separated X and y:
y - [0 0 1 ... 0 1 0]
X -   customerID gender ... MonthlyCharges TotalCharges
0 7590-VHVEG 0 ... 29.85 29.85
1 5575-GNVDE 1 ... 56.95 1889.5
...
[7043 rows x 20 columns]
Huấn luyện và kiểm thử dữ liệu
Bây giờ chia tập dữ liệu thành hai phần: một để huấn luyện, một để kiểm thử. Tham số test_size quyết định phần trăm dữ liệu chỉ dùng cho kiểm thử. Bài tập này giúp ta tin cậy vào mô hình đang tạo. Sau đó áp dụng thuật toán Logistic Regression và tìm giá trị dự đoán.
Ví dụ
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

du_lieu_vao = pd.read_csv('E:\\Telecom_customers.csv')
du_lieu_vao.drop(['customerID'], axis=1, inplace=True)
du_lieu_vao.pop('TotalCharges')
du_lieu_vao['OnlineBackup'].unique()

from sklearn import preprocessing
label_encoder = preprocessing.LabelEncoder()
du_lieu_vao['gender'] = label_encoder.fit_transform(du_lieu_vao['gender'])
du_lieu_vao['Partner'] = label_encoder.fit_transform(du_lieu_vao['Partner'])
du_lieu_vao['Dependents'] = label_encoder.fit_transform(du_lieu_vao['Dependents'])
du_lieu_vao['PhoneService'] = label_encoder.fit_transform(du_lieu_vao['PhoneService'])
du_lieu_vao['MultipleLines'] = label_encoder.fit_transform(du_lieu_vao['MultipleLines'])
du_lieu_vao['InternetService'] = label_encoder.fit_transform(du_lieu_vao['InternetService'])
du_lieu_vao['OnlineSecurity'] = label_encoder.fit_transform(du_lieu_vao['OnlineSecurity'])
du_lieu_vao['OnlineBackup'] = label_encoder.fit_transform(du_lieu_vao['OnlineBackup'])
du_lieu_vao['DeviceProtection'] = label_encoder.fit_transform(du_lieu_vao['DeviceProtection'])
du_lieu_vao['TechSupport'] = label_encoder.fit_transform(du_lieu_vao['TechSupport'])
du_lieu_vao['StreamingTV'] = label_encoder.fit_transform(du_lieu_vao['StreamingTV'])
du_lieu_vao['StreamingMovies'] = label_encoder.fit_transform(du_lieu_vao['StreamingMovies'])
du_lieu_vao['Contract'] = label_encoder.fit_transform(du_lieu_vao['Contract'])
du_lieu_vao['PaperlessBilling'] = label_encoder.fit_transform(du_lieu_vao['PaperlessBilling'])
du_lieu_vao['PaymentMethod'] = label_encoder.fit_transform(du_lieu_vao['PaymentMethod'])
du_lieu_vao['Churn'] = label_encoder.fit_transform(du_lieu_vao['Churn'])

du_lieu_vao["Churn"] = du_lieu_vao["Churn"].astype(int)
Y = du_lieu_vao["Churn"].values
X = du_lieu_vao.drop(labels=["Churn"], axis=1)

X_train, X_test, Y_train, Y_test = train_test_split(X, Y, test_size=0.2)

classifier = LogisticRegression()
classifier.fit(X_train, Y_train)
Y_pred = classifier.predict(X_test)
print("\nGiá trị dự đoán:\n", Y_pred)
Kết quả
Chạy mã trên cho kết quả sau:
predicted values: [0 0 1 ... 0 1 0]
Tìm các tham số đánh giá
Khi độ chính xác ở bước trên chấp nhận được, ta tiến hành đánh giá mô hình bằng các tham số khác. Chúng ta dùng Accuracy (độ chính xác) và confusion matrix (ma trận nhầm lẫn) để đánh giá. Độ chính xác cao hơn cho thấy mô hình phù hợp hơn. Tương tự, confusion matrix cho thấy ma trận true positives, true negatives, false positives, false negatives. Tỷ lệ giá trị true cao hơn false là dấu hiệu mô hình tốt.
Ví dụ
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
from sklearn.linear_model import LogisticRegression
from sklearn import metrics
from sklearn.metrics import confusion_matrix
from sklearn.model_selection import train_test_split
from sklearn import preprocessing

du_lieu_vao = pd.read_csv('E:\\Telecom_customers.csv')
du_lieu_vao.drop(['customerID'], axis=1, inplace=True)
du_lieu_vao.pop('TotalCharges')
du_lieu_vao['OnlineBackup'].unique()

label_encoder = preprocessing.LabelEncoder()
du_lieu_vao['gender'] = label_encoder.fit_transform(du_lieu_vao['gender'])
du_lieu_vao['Partner'] = label_encoder.fit_transform(du_lieu_vao['Partner'])
du_lieu_vao['Dependents'] = label_encoder.fit_transform(du_lieu_vao['Dependents'])
du_lieu_vao['PhoneService'] = label_encoder.fit_transform(du_lieu_vao['PhoneService'])
du_lieu_vao['MultipleLines'] = label_encoder.fit_transform(du_lieu_vao['MultipleLines'])
du_lieu_vao['InternetService'] = label_encoder.fit_transform(du_lieu_vao['InternetService'])
du_lieu_vao['OnlineSecurity'] = label_encoder.fit_transform(du_lieu_vao['OnlineSecurity'])
du_lieu_vao['OnlineBackup'] = label_encoder.fit_transform(du_lieu_vao['OnlineBackup'])
du_lieu_vao['DeviceProtection'] = label_encoder.fit_transform(du_lieu_vao['DeviceProtection'])
du_lieu_vao['TechSupport'] = label_encoder.fit_transform(du_lieu_vao['TechSupport'])
du_lieu_vao['StreamingTV'] = label_encoder.fit_transform(du_lieu_vao['StreamingTV'])
du_lieu_vao['StreamingMovies'] = label_encoder.fit_transform(du_lieu_vao['StreamingMovies'])
du_lieu_vao['Contract'] = label_encoder.fit_transform(du_lieu_vao['Contract'])
du_lieu_vao['PaperlessBilling'] = label_encoder.fit_transform(du_lieu_vao['PaperlessBilling'])
du_lieu_vao['PaymentMethod'] = label_encoder.fit_transform(du_lieu_vao['PaymentMethod'])
du_lieu_vao['Churn'] = label_encoder.fit_transform(du_lieu_vao['Churn'])

du_lieu_vao["Churn"] = du_lieu_vao["Churn"].astype(int)
Y = du_lieu_vao["Churn"].values
X = du_lieu_vao.drop(labels=["Churn"], axis=1)

X_train, X_test, Y_train, Y_test = train_test_split(X, Y, test_size=0.2)

classifier = LogisticRegression()
classifier.fit(X_train, Y_train)
Y_pred = classifier.predict(X_test)

# Accuracy
LR = metrics.accuracy_score(Y_test, Y_pred) * 100
print("\nĐộ chính xác sử dụng LR:", LR)

# Confusion matrix
cm = confusion_matrix(Y_test, Y_pred)
print("\nConfusion matrix:\n", cm)
Kết quả
Chạy mã trên cho kết quả sau:
Độ chính xác sử dụng LR: 80.8374733853797
confusion matrix:
[[928 109]
 [161 211]]
Trọng số các biến (Weight of Variables)
Tiếp theo, chúng ta đánh giá cách mỗi trường/biến ảnh hưởng đến giá trị churn. Điều này giúp nhắm vào các biến cụ thể có tác động lớn hơn lên churn và cố gắng xử lý các biến đó để ngăn chặn customer churn. Để làm này, ta đặt hệ số trong classifier về 0 và lấy trọng số của từng biến.
Ví dụ
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn import preprocessing

du_lieu_vao = pd.read_csv('E:\\Telecom_customers.csv')
du_lieu_vao.drop(['customerID'], axis=1, inplace=True)
du_lieu_vao.pop('TotalCharges')
du_lieu_vao['OnlineBackup'].unique()

label_encoder = preprocessing.LabelEncoder()
du_lieu_vao['gender'] = label_encoder.fit_transform(du_lieu_vao['gender'])
du_lieu_vao['Partner'] = label_encoder.fit_transform(du_lieu_vao['Partner'])
du_lieu_vao['Dependents'] = label_encoder.fit_transform(du_lieu_vao['Dependents'])
du_lieu_vao['PhoneService'] = label_encoder.fit_transform(du_lieu_vao['PhoneService'])
du_lieu_vao['MultipleLines'] = label_encoder.fit_transform(du_lieu_vao['MultipleLines'])
du_lieu_vao['InternetService'] = label_encoder.fit_transform(du_lieu_vao['InternetService'])
du_lieu_vao['OnlineSecurity'] = label_encoder.fit_transform(du_lieu_vao['OnlineSecurity'])
du_lieu_vao['OnlineBackup'] = label_encoder.fit_transform(du_lieu_vao['OnlineBackup'])
du_lieu_vao['DeviceProtection'] = label_encoder.fit_transform(du_lieu_vao['DeviceProtection'])
du_lieu_vao['TechSupport'] = label_encoder.fit_transform(du_lieu_vao['TechSupport'])
du_lieu_vao['StreamingTV'] = label_encoder.fit_transform(du_lieu_vao['StreamingTV'])
du_lieu_vao['StreamingMovies'] = label_encoder.fit_transform(du_lieu_vao['StreamingMovies'])
du_lieu_vao['Contract'] = label_encoder.fit_transform(du_lieu_vao['Contract'])
du_lieu_vao['PaperlessBilling'] = label_encoder.fit_transform(du_lieu_vao['PaperlessBilling'])
du_lieu_vao['PaymentMethod'] = label_encoder.fit_transform(du_lieu_vao['PaymentMethod'])
du_lieu_vao['Churn'] = label_encoder.fit_transform(du_lieu_vao['Churn'])

du_lieu_vao["Churn"] = du_lieu_vao["Churn"].astype(int)
Y = du_lieu_vao["Churn"].values
X = du_lieu_vao.drop(labels=["Churn"], axis=1)

X_train, X_test, Y_train, Y_test = train_test_split(X, Y, test_size=0.2)

classifier = LogisticRegression()
classifier.fit(X_train, Y_train)
Y_pred = classifier.predict(X_test)

# Trọng số tất cả biến
trong_so = pd.Series(classifier.coef_[0], index=X.columns.values)
print("\nTrọng số tất cả biến:")
print(trong_so.sort_values(ascending=False))
Kết quả
Chạy mã trên cho kết quả sau:
Trọng số tất cả biến:
PaperlessBilling     0.389379
SeniorCitizen        0.246504
InternetService      0.209283
Partner              0.067855
StreamingMovies      0.054309
MultipleLines        0.042330
PaymentMethod        0.039134
MonthlyCharges       0.027180
StreamingTV         -0.008606
gender              -0.029547
tenure              -0.034668
DeviceProtection    -0.052690
OnlineBackup        -0.143625
Dependents          -0.209667
OnlineSecurity      -0.245952
TechSupport         -0.254740
Contract            -0.729557
PhoneService        -0.950555
dtype: float64