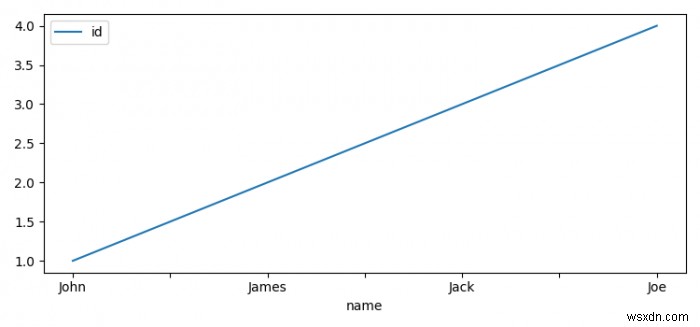
Để sử dụng Matplotlib vẽ biểu đồ từ kết quả truy vấn PySpark SQL, bạn có thể thực hiện theo các bước sau:
- Thiết lập kích thước hình vẽ và điều chỉnh khoảng đệm giữa các subplot.
- Khởi tạo
SparkContext– điểm vào chính cho chức năng Spark. - Tạo
HiveContextđể tích hợp với dữ liệu lưu trữ trong Hive. - Chuẩn bị danh sách bản ghi dưới dạng tuple.
- Song song hóa tập hợp Python cục bộ thành RDD.
- Ánh xạ từng bản ghi theo lược đồ (schema) mong muốn.
- Tạo DataFrame từ RDD và đăng ký thành bảng tạm "my_table".
- Thực thi truy vấn SQL để lấy dữ liệu.
- Chuyển kết quả sang Pandas DataFrame để vẽ đồ thị.
- Đặt cột name làm chỉ số (index) và vẽ biểu đồ.
- Sử dụng phương thức show() để hiển thị hình vẽ.
Ví dụ minh họa
from pyspark.sql import Row
from pyspark.sql import HiveContext
import pyspark
import matplotlib.pyplot as plt

plt.rcParams["figure.figsize"] = [7.50, 3.50]
plt.rcParams["figure.autolayout"] = True

sc = pyspark.SparkContext()
sqlContext = HiveContext(sc)

test_list = [(1, 'John'), (2, 'James'), (3, 'Jack'), (4, 'Joe')]
rdd = sc.parallelize(test_list)
people = rdd.map(lambda x: Row(id=int(x[0]), name=x[1]))
schemaPeople = sqlContext.createDataFrame(people)
sqlContext.registerDataFrameAsTable(schemaPeople, "my_table")

df = sqlContext.sql("Select * from my_table")
df = df.toPandas()
df.set_index('name').plot()
plt.show()
Kết quả đầu ra