
Background task là một trong những trụ cốt cốt lõi khi xem xét ứng dụng web cho quy mô. Ý tưởng cơ bản đơn giản: Client gửi request đến ứng dụng web của bạn và khi xử lý request đó, app của bạn thực hiện một số tác vụ tốn thời gian. Để cho phép nó phản hồi client nhanh hơn, app sẽ enqueue một background job vào hệ thống xử lý background. Xử lý background sau đó đảm nhận tất cả việc nặng nhọc, như tính toán hoặc hoạt động I/O. Việc tận dụng background job hiệu quả là một trong những khối xây dựng quan trọng nhất khi scale ứng dụng web của bạn.
Như các lập trình viên Rails, chúng ta được ban cho một số thư viện tuyệt vời để lựa chọn, tất cả với lợi thế, nhược điểm, thậm chí backend database khác nhau. Những thư viện này làm cho việc offload bất kỳ heavy lifting nào trở nên dễ dàng, cho phép ứng dụng của chúng ta phản hồi nhanh hơn và phục vụ nhiều người dùng hơn với ít tài nguyên hơn.
Cho đến gần đây, chúng ta dùng Sidekiq để thực hiện phần lớn background processing job của Honeybadger. Nó đã đóng vai trò then chốt trong việc giúp chúng ta duy trì trải nghiệm người dùng cực nhanh và một pipeline mạnh mẽ để xử lý lượng dữ liệu khổng lồ chúng ta ingest.
Sidekiq Thiếu Hụt Ở Đâu Đối Với Chúng Tôi?
Mặc dù độ tin cậy, Redis có một số hạn chế. Cho đến gần đây, chúng ta dùng Sidekiq cho tất cả xử lý job, bao gồm xử lý ingest cho endpoint theo dõi lỗi của chúng ta. Lượng traffic lỗi biến động mạnh. Chúng ta thường thấy 10x hoặc 20x số lượng job trong hàng đợi — dẫn đến backlog lớn cho đến khi autoscaling có thể spin up đủ worker để đuổi kịp. Nhưng vấn đề lớn hơn là cạn kiệt bộ nhớ trong cluster ElastiCache.
Chúng ta có đủ traffic job đi qua cluster ElastiCache mà bất kỳ độ trễ đáng kể nào trong xử lý downstream đều có rủi ro làm cluster hết bộ nhớ. Mặc dù chúng ta dùng cluster riêng cho lưu trữ dữ liệu non-queue, theo thời gian, chúng ta đã có một số dữ liệu non-queue xuất hiện trong cluster chính cũng vậy, điều này sau đó có thể bị evict trong trường hợp lỗi out-of-memory. Vấn đề quan trọng hơn, tuy nhiên, là không thể chấp nhận job mới khi cluster hết bộ nhớ.
Một vấn đề thứ hai là Redis/ElastiCache dùng chính sách eviction volatile-lru mặc định. Hậu quả của điều này là vào lúc sử dụng bộ nhớ cao, Redis sẽ xóa dữ liệu ít được dùng gần đây nhất có TTL set. Tại một thời điểm, Honeybadger có sự kiện mà mức sử dụng bộ nhớ đủ cao để Redis bắt đầu xóa cache khi chúng ta không ý định. May mắn thay, dữ liệu bị evict có thể tái tạo (do TTL), vì vậy chúng ta không mất dữ liệu vĩnh viễn.
Vẫn vậy, điều này để lại một câu hỏi cần giải quyết - Điều gì xảy ra nếu sự kiện tương tự xảy ra và chúng ta bắt đầu mất dữ liệu không thể rebuild? Làm thế nào để đảm bảo chúng ta không bao giờ mất dữ liệu khách hàng? Việc xử lý dữ liệu lỗi khách hàng là cốt lõi nghiệp vụ của chúng ta, vì vậy chúng ta cần một hệ thống có khả năng chịu đựng mất dữ liệu.
Sử Dụng Kafka Cho Ingest Dữ Liệu
Kafka là một event pipeline phân tán cung cấp cả scalability và resiliency. Với việc ra mắt Insights gần đây, chúng ta đã có nhiều kinh nghiệm standing up Kafka như infrastructure để xử lý dữ liệu event của chúng ta. Sau đó, chúng ta muốn dùng cùng technology stack để xử lý dữ liệu ingest lỗi. Chúng ta nhắm đến việc đạt được redundant storage với expandability tốt hơn và chi phí hợp lý hơn bằng cách dùng Kafka.
Vì chúng ta đang chạy cluster AWS MSK riêng cho Insights, chúng ta đã có sẵn infrastructure và setup autoscaling. Điều này có nghĩa là chúng ta "chỉ" cần thiết lập một vài topic và tạo một vài consumer chạy cùng code với worker Sidekiq của chúng ta. Khái niệm khá đơn giản, cho phép chúng ta tập trung hơn vào fine-tuning consumer Kafka của chúng ta.
Chuyển Đổi Từ Sidekiq Sang Karafka
Honeybadger được kiến trúc như một majestic monolith, và Karafka giúp chúng ta giữ nguyên kiến trúc đó. Chúng ta đã dùng Karafka để xử lý một phần dữ liệu Insights, vì vậy thêm một vài consumer mới là nhiệm vụ đơn giản.
Một trong những khác biệt chính giữa Karafka và Sidekiq là cách job được retrieve. Với Karafka, job được batched và xử lý cùng nhau trong một lần chạy consumer. Trong consumer, chúng ta có thể lặp qua mảng message và chạy Sidekiq worker inline:
class NoticeConsumer < ApplicationConsumer def consume messages.each do |message| NoticeWorker.new.perform(message.payload) end end end Một khác biệt khác chúng ta phải cân nhắc là cách xử lý lỗi hoạt động. Với Sidekiq, vì mỗi job là atomic, một worker xử lý lỗi của riêng nó qua retry và failure callback. Với hành vi batching của Kafka, có nhiều tùy chọn hơn cho xử lý lỗi. Đáng chú ý nhất, Karafka cung cấp một cơ chế gọi là Dead Letter Queue. Điều này cho phép bạn chỉ định xử lý lỗi trên cơ sở batch hoặc individual.
dead_letter_queue( topic: "ingestion.errors.dead", max_retries: 5, independent: true ) Khi nào consumer Karafka gặp thất bại xử lý bất kỳ message individual nào, nó sẽ cố gắng reprocess 5 lần. Nếu thất bại lần thứ 5, message sẽ được gửi đến topic chỉ định. Tùy chọn independent: true báo cho consumer rằng chỉ message thất bại cần được gửi đến DLQ thay vì toàn bộ batch.
Giám Sát Và Scale Karafka
Như kết quả, giám sát và scale Karafka consumer khá phức tạp. Có nhiều thứ bạn có thể theo dõi từ cả AWS/MSK và Karafka, và nhiều nút bạn có thể vặn để tune hệ thống. Nó đòi hỏi sự chú ý cẩn thận đến những gì code của bạn đang làm, hành vi của luồng dữ liệu.
Với AWS CloudWatch chúng ta giám sát nhiều thứ, nhưng đây là một vài metric Kafka-specific chúng ta nhìn:
- SumOffsetLag — Đối với topic và consumer group chỉ định, đây là tổng của tất cả offset lag trên tất cả partition.
- EstimatedMaxTimeLag — Đối với topic và consumer group chỉ định, đây là lượng thời gian ước tính sẽ cần để bắt kịp tất cả partition đến offset hiện tại.
Karafka cũng cung cấp một số instrumentation tuyệt vời, nhưng bạn sẽ cần publish dữ liệu này và lưu trữ nó yourself:
- processing_lag* — Giá trị này có sẵn cho mỗi batch message được consume. Nó cho bạn biết thời gian Karafka lấy message từ Kafka và bắt đầu xử lý nó.
- consumption_lag* — Giá trị này tương tự processing_lag trừ đó là thời gian từ khi message cuối cùng của batch vào hệ thống Kafka, cho đến khi consumer của bạn bắt đầu xử lý nó.
- duration* — Đây là thời gian consumer xử lý một batch message hoàn chỉnh.
Như kết quả, scale tiến trình Sidekiq rất khác scale tiến trình Karafka consumer. Khi tăng parallelization của Sidekiq, bạn có thể thêm nhiều tiến trình hơn cho bất cứ thứ gì instance Redis của bạn có thể xử lý. Với Kafka, bạn bị giới tối đa 1 tiến trình mỗi partition trong topic. Như một quy tắc chung, bạn sẽ muốn có nhiều partition hơn bạn dự định vì một Kafka consumer có thể được gán cho hơn 1 partition.
Điều khác cần nhớ là scale up và scale down Kafka consumer có thể là một operation rất dài. Thêm và xóa consumer từ consumer group yêu cầu group rebalance chính nó. Điều này có nghĩa là reassign partition khi cần thiết. Trong quá trình reassign, consumer dừng xử lý message. Mặc dù bạn có thể mitigate vấn đề này một chút với assignment sticky-cooperative, bạn thường muốn tránh rebalancing nếu có thể bằng cách over-provisioning tài nguyên.
Chúng ta hiện đang giám sát SumOffsetLag như một trong những metric scaling. Một điều quan trọng cần lưu ý là trong quá trình rebalancing, metric này không được báo cáo. Vì vậy như bạn hình dung, trong giai đoạn rebalancing, metric này sẽ tăng vọt cho đến khi rebalancing kết thúc. Đây là lý do khác tại sao quan trọng để giữ scaling tối thiểu.
Tiếp Theo Cho Karafka Tại Honeybadger?
Chúng ta đã chạy implementation Kafka/Karafka ở 100% hơn một tháng nay và có thể nói chúng ta khá hài lòng. Vẫn thì, thật tuyệt khi biết chúng ta luôn có thể fallback về Sidekiq chỉ với một nút bấm nếu cần. Điều này cho chúng ta sự resilient lớn hơn khi maintenance work cần thiết trên bất kỳ hệ thống nào.
Trong quá trình migrate từ Sidekiq sang Karafka, chúng ta cũng học được nhiều hơn về làm việc với Kafka và Karafka. Nếu bạn chưa cập nhật lên phiên bản mới nhất của gem Honeybadger, bạn nên xem nó! Tôi đã thêm một số tính năng mới cho plugin karafka. Khi bạn bật Insights, gem của chúng ta sẽ bắt đầu theo dõi một số stat quan trọng để cho bạn cái nhìn tốt hơn về sức khỏe tổng thể của hệ thống Kafka của bạn.
Ngoài ra, chúng ta hiện có Insights Karafka Dashboard để giúp bạn visualize dữ liệu này và cho bạn hiểu tốt hơn về cách Kafka consumer của bạn hoạt động. Karafka Dashboard yêu cầu metrics được bật cho plugin. Để làm điều đó, thêm config sau trong honeybadger.yml:
karafka: insights: metrics: true Đây là mẫu dashboard trông như thế nào:
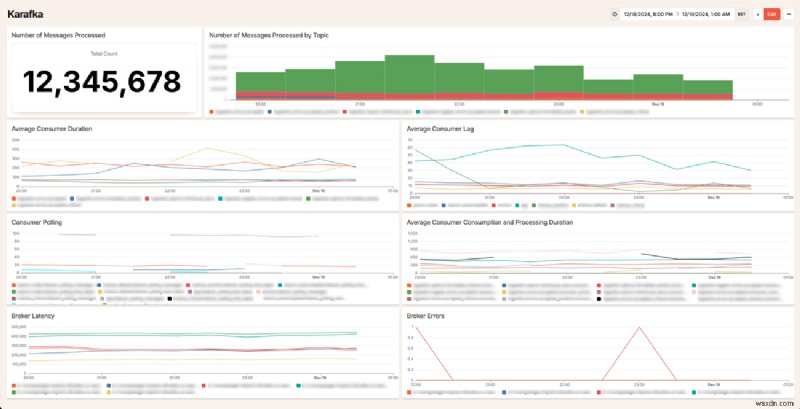
Chúng ta hào hứng xem khách hàng của chúng ta dùng dữ liệu này để cải thiện hệ thống Kafka của họ. Nếu bạn có bất kỳ câu hỏi nào về cách chúng ta migrate từ Sidekiq sang Karafka, hoặc cách chúng ta dùng Kafka nói chung, đừng ngần ngại liên hệ!