
Hiểu về hiệu suất của NGINX có thể khiến bạn choáng ngợp. Có quá nhiều điểm dữ liệu để theo dõi, và việc xác định những chỉ số nào liên quan đến bạn và những chỉ số nào có thể bỏ qua thường rất khó khăn.
Trong bài viết này, chúng tôi sẽ giải thích cách sử dụng AppSignal để giám sát NGINX, mở rộng khả năng quan sát hiệu suất ứng dụng của bạn.
Biến Tất Cả Chỉ Số Của Bạn Thành "Phép Màu"
AppSignal cho phép bạn tạo các bảng điều khiển tùy chỉnh với các chỉ số hiệu suất từ thông lượng (throughput) đến thời gian phản hồi. Việc tạo bảng điều khiển thủ công tốn thời gian và khó xác định những chỉ số thực sự quan trọng. Vì vậy, AppSignal đã tự động hóa quy trình này thông qua Magic Dashboards (Bảng Điều Khiển Ma Thuật). Khi bạn cài đặt AppSignal, agent của chúng tôi sẽ quét cơ sở hạ tầng và tự động tạo các bảng điều khiển quan trọng nhất cho bạn, bao gồm cả bảng điều khiển NGINX.
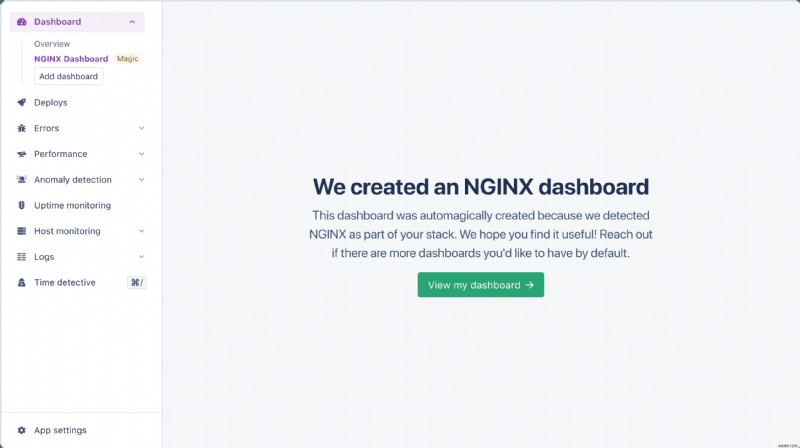
Magic Dashboards của bạn sẽ tự động xuất hiện trong danh sách bảng điều khiển của ứng dụng. Sau khi bảng điều khiển được thiết lập, bạn có thể tùy chỉnh nó để hiển thị các chỉ số phù hợp với ngữ cảnh độc đáo của ứng dụng.
Trực Quan Hóa Chỉ Số NGINX Với Magic Dashboards
Hãy xem Magic Dashboards giúp bạn tận dụng các hành động của NGINX khi khả năng sẵn sàng của ứng dụng bị đe dọa, do lưu lượng truy cập cao gây ra sự cố ngừng hoạt động.
Hãy tưởng tượng bạn có một ứng dụng tên SnapGram cho phép người dùng tải lên ảnh và xem, thích ảnh của những người dùng khác. Ứng dụng của bạn có một lượng người dùng chuyên tâm nhỏ và tương đối ổn định, không có vấn đề về khả năng sẵn sàng.
Tất cả thay đổi khi một đối thủ lớn bất ngờ cấm chia sẻ ảnh mèo và cappuccino, khiến người dùng chuyển sang SnapGram. Chỉ trong vài giờ, số lượng người dùng hoạt động của bạn tăng vọt từ vài trăm lên hàng nghìn. Đột ngột hàng nghìn người than phiền không thể sử dụng SnapGram. Tuy nhiên, khi bạn kiểm tra nhật ký ứng dụng, mọi thứ dường như chạy bình thường, không có sự gia tăng về sự cố lỗi.
Nhưng Magic Dashboard NGINX của bạn kể một câu chuyện khác:
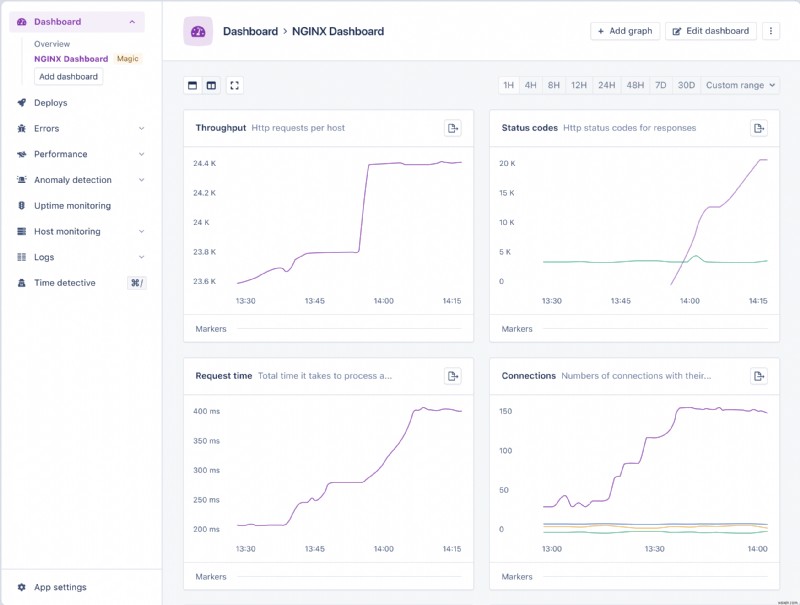
Biểu đồ Thông lượng (Throughput) cung cấp thông tin nhanh chóng về số lượng yêu cầu ứng dụng đang nhận được. Nhìn vào biểu đồ, ta thấy SnapGram đang "làm sập internet" - nó nhận được rất nhiều yêu cầu. Biểu đồ Thời gian yêu cầu (Request time) cũng tăng lên, nghĩa là SnapGram mất nhiều thời gian hơn để phản hồi các yêu cầu. Biểu đồ Kết nối (Connections), thể hiện trạng thái kết nối đến ứng dụng, cho thấy nhiều người đang chờ SnapGram phản hồi. Nó không thể đáp ứng nhu cầu.
Vì SnapGram không thể theo kịp nhu cầu, biểu đồ Mã trạng thái (Status codes) cho thấy số lượng time-out tăng vọt. Hầu hết những người cố gắng tương tác với SnapGram đều nhận được lỗi time-out. Vì điều này xảy ra trước khi quy trình ứng dụng của SnapGram nhận được yêu cầu, việc chỉ phân tích nhật ký sẽ không cảnh báo cho chúng ta về vấn đề (chúng ta chỉ thấy tỷ lệ nhỏ các yêu cầu SnapGram xử lý thành công).
Bây giờ bạn biết vấn đề không nằm ở mã nguồn, bạn có thể cải thiện khả năng sẵn sàng của SnapGram bằng cách khởi động thêm máy chủ để ứng dụng xử lý lưu lượng tốt hơn. Mỗi máy chủ mới sẽ xuất hiện dưới dạng một dấu hiệu khác nhau trong biểu đồ Thời gian phản hồi Upstream và Mã trạng thái Upstream của Magic Dashboard, cung cấp thông tin chi tiết cho từng quy trình.
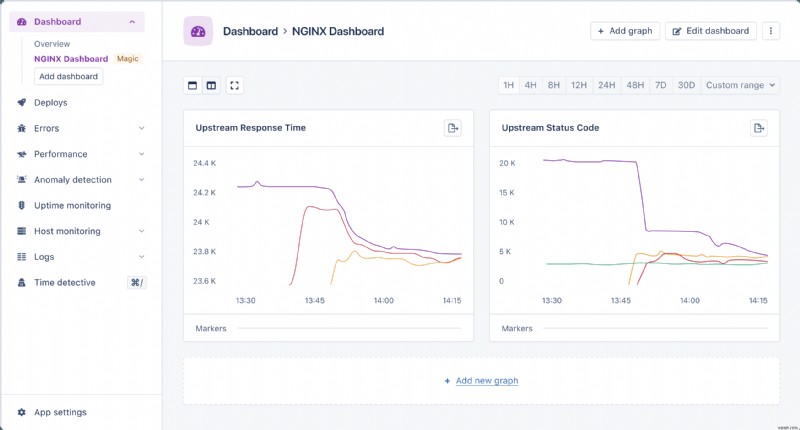
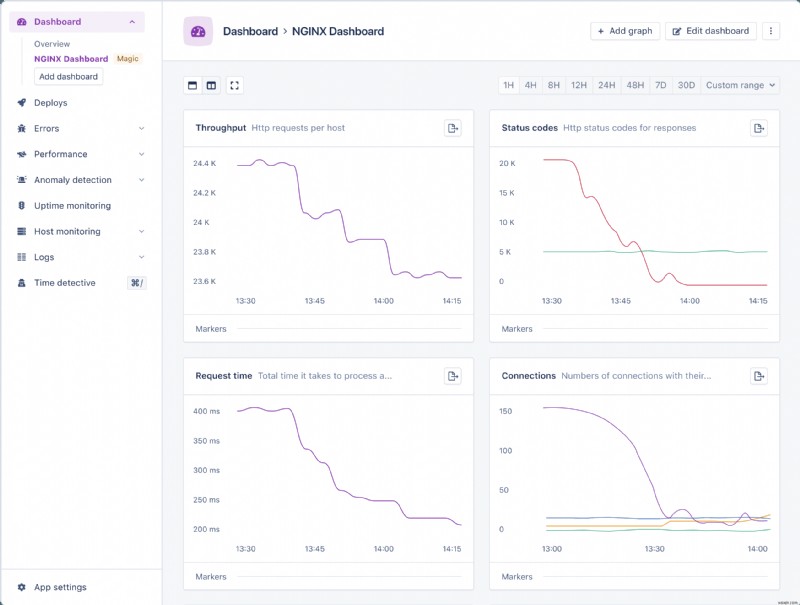
Để giảm thêm tải cho SnapGram, bạn cũng bật bộ nhớ đệm upstream. Khi càng nhiều yêu cầu được lưu vào bộ nhớ đệm, thời gian yêu cầu (và thời gian yêu cầu upstream) giảm xuống khi áp lực trên ứng dụng giảm. Khi SnapGram ổn định và các yêu cầu của người dùng được phục vụ, bạn sẽ thấy người dùng ngừng than phiền và quay lại chia sẻ ảnh mèo và cappuccino.
Nhiều Chỉ Số Hơn = Phép Màu Hơn
SnapGram chỉ là một ví dụ đơn giản về việc truy cập các chỉ số dễ đọc có thể giúp bạn giữ ứng dụng ổn định và tận dụng tối đa tích hợp NGINX.
Magic Dashboards NGINX của chúng tôi có thể theo dõi các chỉ số sau:
- Thời gian yêu cầu (Request Time): thời gian máy chủ NGINX mất để phản hồi một yêu cầu, dưới dạng trung bình mỗi phút và phân vị 95.
- Thông lượng (Throughput): số lượng yêu cầu được xử lý bởi máy chủ NGINX.
- Độ dài yêu cầu (Request Length): độ dài tính bằng byte của yêu cầu nhận được từ client bởi máy chủ NGINX, dưới dạng trung bình mỗi phút và phân vị 95.
- Độ dài phản hồi (Response Length): độ dài tính bằng byte của phản hồi gửi đến client bởi máy chủ NGINX, dưới dạng trung bình mỗi phút và phân vị 95.
- Mã trạng thái (Status Codes): số lượng mã trạng thái của các phản hồi do máy chủ NGINX gửi.
- Kết nối (Connections): một gauge của các kết nối hiện đang được xử lý bởi máy chủ NGINX, đo lường mỗi phút và phân đoạn theo trạng thái kết nối.
- Mã trạng thái Upstream (Upstream Status Codes): số lượng mã trạng thái của các phản hồi do các máy chủ upstream mà máy chủ NGINX proxy gửi.
- Thời gian phản hồi Upstream (Upstream Response Time): thời gian mất để phản hồi yêu cầu bởi các máy chủ upstream mà máy chủ NGINX proxy, dưới dạng trung bình mỗi phút và phân vị 95.
- Trạng thái bộ nhớ đệm Upstream (Upstream Cache Status): trạng thái bộ nhớ đệm (như HIT hoặc MISS) khi xử lý yêu cầu được lưu trong bộ nhớ đệm từ máy chủ upstream.
Nếu bạn sẵn sàng bắt đầu với NGINX và AppSignal, hãy tìm hiểu thêm về cách cấu hình tích hợp AppSignal trong tài liệu chỉ số NGINX của chúng tôi.
Magic Dashboards của AppSignal chỉ là một trong nhiều tính năng hướng tới nhà phát triển giúp bạn tận dụng tối đa việc giám sát ứng dụng. Các nhà phát triển cũng thích sử dụng giám sát của chúng tôi vì chúng tôi có:
- Giao diện trực quan, dễ điều hướng.
- Giá cả đơn giản và dễ dự đoán.
- Hỗ trợ từ nhà phát triển cho nhà phát triển.
Nếu bạn là người dùng dùng thử mới, bạn cũng có thể nhận được một hộp stroopwafels miễn phí. Khi bạn bắt đầu đẩy dữ liệu, hãy liên hệ với chúng tôi, và chúng tôi sẽ gửi gói quà đến cho bạn 🍪!
Connor James
Quản lý Marketing Nhà Phát Triển tại AppSignal. Nghiện podcast, yêu cannoli đến mức đang cân nhắc đổi tên thành Connoli. Anh nghĩ từ "color" có chữ "u". Bạn có thể tìm thấy anh trên mic, trên sân khấu, hoặc nằm trên ghế sofa khi không trực.
Tất cả bài viết của Connor James