
Bạn sẽ làm gì nếu được cho một bộ sưu tập văn bản lớn và muốn trích xuất ý nghĩa từ nó?
Khởi đầu tốt là chia nhỏ văn bản thành n-gram.
Dưới đây là mô tả:
Trong lĩnh vực ngôn ngữ học tính toán và xác suất, n-gram là chuỗi liên tiếp n mục từ một chuỗi văn bản cho trước. – Wikipedia
Ví dụ:
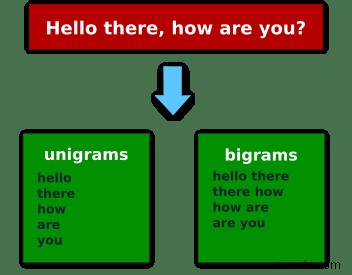
Nếu chúng ta lấy cụm từ "Hello there, how are you?", thì unigram (n-gram một phần tử) sẽ là: "Hello", "there", "how", "are", "you", và bigram (n-gram hai phần tử): ["Hello", "there"], ["there", "how"], ["how", "are"], ["are", "you"].
Nếu bạn học tốt hơn với hình ảnh, đây là hình minh họa:
Giờ hãy xem cách triển khai trong Ruby!
Tải dữ liệu mẫu
Trước khi bám tay vào việc, chúng ta cần dữ liệu mẫu.
Nếu bạn không có dữ liệu để làm việc, bạn có thể tải vài bài Wikipedia hoặc blog. Trong trường hợp này, tôi quyết định tải log IRC từ kênh #ruby của freenode.
Log có thể tìm thấy tại:
irclog.whitequark.org/ruby
Lưu ý về định dạng dữ liệu:
Nếu phiên bản văn bản thuần túy của tài nguyên bạn muốn phân tích không có sẵn, bạn có thể dùng Nokogiri để phân tích trang và trích xuất dữ liệu.
Log IRC có sẵn dạng văn bản thuần túy bằng cách thêm .txt cuối URL, nên chúng ta sẽ tận dụng điều đó.
Lớp này sẽ tải và lưu dữ liệu cho chúng ta:
require 'restclient'
class LogParser
  LOG_DIR = 'irc_logs'
  def initialize(date)
    @date = date
    @log_name = "#{LOG_DIR}/irc-log-#{@date}.txt"
  end
  def download_page(url)
    return log_contents if File.exist? @log_name
    RestClient.get(url).body
  end
  def save_page(page)
    File.open(@log_name, "w+") { |f| f.puts page }
  end
  def log_contents
    File.readlines(@log_name).join
  end
  def get_messages
    page = download_page("https://irclog.whitequark.org/ruby/#{@date}.txt")
    save_page(page)
    page
  end
end
log = LogParser.new("2015-04-15")
msg = log.get_messages
Đây là một lớp khá đơn giản.
Chúng ta dùng RestClient làm HTTP client và lưu kết quả vào tệp để không phải yêu cầu nhiều lần khi sửa chương trình.
Phân tích dữ liệu
Giờ chúng ta có dữ liệu, có thể phân tích.
Đây là lớp Ngram đơn giản.
Trong lớp này, chúng ta dùng phương thức Array#each_cons tạo ra n-gram.
Vì phương thức này trả về Enumerator, chúng ta cần gọi to_a để lấy Array.
class Ngram
  def initialize(input)
    @input = input
  end
  def ngrams(n)
    @input.split.each_cons(n).to_a
  end
end
Sau đó, gắn mọi thứ lại dùng vòng lặp, Hash#merge! và Enumerable#sort_by.
Như thế này:
# Lọc từ xuất hiện ít hơn ngưỡng này
MIN_REPETITIONS = 20
total = {}
# Lấy log 15 ngày đầu tháng và trả về trigram
(1..15).each do |n|
  day = '%02d' % [n]
  total.merge!(get_trigrams_for_date "2015-04-#{day}") { |k, old, new| old + new }
end
# Sắp xếp giảm dần
total = total.sort_by { |k, v| -v }.reject { |k, v| v < MIN_REPETITIONS }
total.each { |k, v| puts "#{v} => #{k}" }
Lưu ý: phương thức
get_trigrams_for_datekhông có ở đây cho gọn, nhưng bạn có thể tìm trên github.
Đây là giao diện đầu ra:
112 => i want to
83 => link for more
82 => is there a
71 => you want to
66 => i don't know
66 => i have a
65 => i need to
Như bạn thấy, "muốn làm điều gì đó" rất phổ biến trong #ruby 🙂
Kết luận
Giờ đến lượt bạn!
Mở editor và bắt đầu chơi với phân tích n-gram. Cách khác xem n-gram hoạt động là Google Ngram Viewer.
Xử lý ngôn ngữ tự nhiên (NLP) có thể là chủ đề thú vị, Wikipedia có tổng quan tốt về chủ đề này.
Bạn có thể tìm mã hoàn chỉnh cho bài viết này tại: https://github.com/matugm/ngram-analysis/blob/master/irc_histogram.rb