
Tôi gần đây đã xuất bản một bài viết trong đó tôi kiểm tra hầu hết các phương thức chuỗi của Ruby với một số ký tự Unicode để xem chúng có hành vi bất ngờ hay không. Nhiều phương thức có.
Một lời chỉ trích mà một vài người có đối với bài viết là tôi đang dùng chuỗi unnormalized để test. Thực sự, tôi hơi mờ mờ về Unicode normalization. Tôi nghi ngờ nhiều Rubyists cũng vậy.
Sử dụng normalization, bạn có thể lấy nhiều chuỗi Unicode hành vi bất ngờ trong test của tôi và chuyển đổi chúng thành chuỗi chơi tốt với các phương thức chuỗi của Ruby. Tuy nhiên:
- Việc chuyển đổi không hoàn hảo. Một số chuỗi Unicode sẽ luôn khiến các phương thức chuỗi của Ruby hành vi sai.
- Đây là việc bạn phải làm thủ công. Không phải Ruby, cũng không phải Rails hay DB tự động normalize theo mặc định.
Bài viết này sẽ là giới thiệu ngắn gọn về Unicode normalization trong Ruby. Hy vọng nó sẽ cho bạn điểm khởi đầu cho các khám phá của riêng bạn.
Hãy normalize một chuỗi
Phương thức
String#unicode_normalizeđược giới thiệu trong Ruby 2.2. Vì được viết bằng Ruby, nó không nhanh bằng các thư viện normalization như utf8_proc và unicode gems tận dụng C.
Lý do chúng ta cần normalization là trong Unicode có nhiều hơn một cách để viết một ký tự. Chữ cái "Å" có thể được biểu diễn như code point "\u00c5" hoặc như sự kết hợp của chữ "A" và dấu nhấn: "A\u030A".
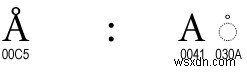
Normalization chuyển đổi một dạng sang dạng khác:
"A\u030A".unicode_normalize #=> 'Å' (giống như "\u00C5")
Tất nhiên, không chỉ có một cách để normalize Unicode. Đó sẽ quá đơn giản! Có bốn cách để normalize, gọi là "normalization forms." Chúng được đặt tên bằng các acronym bí ẩn: NFD, NFC, NFKD và NFKC.
String#unicode_normalize dùng NFC mặc định, nhưng chúng ta có thể bảo nó dùng dạng khác như sau:
"a\u0300".unicode_normalize(:nfkc) #=> 'à' (giống như "\u00E0")
Nhưng điều này thực sự có nghĩa gì? Các dạng normalization này thực sự làm gì? Hãy xem.
Các dạng chuẩn hóa
Có hai loại thao tác chuẩn hóa:
- Composition (Kết hợp): Chuyển đổi ký tự multi-code-point thành single code point. Ví dụ:
"a\u0300"thành"\u00E0", cả hai đều mã hóa ký tựà. - Decomposition (Phân rã): Ngược lại của composition. Chuyển đổi ký tự single-code-point thành nhiều code point. Ví dụ:
"\u00E0"thành"a\u0300".
Composition và decomposition mỗi cái có thể làm theo hai cách:
- Canonical (Quán chuẩn): Giữ nguyên glyph. Ví dụ:
"2⁵"vẫn là"2⁵"dù một số hệ thống có thể không hỗ trợ ký tự superscript-five. - Compatibility (Tương thích): Có thể thay thế glyph bằng các ký tự tương thích. Ví dụ:
"2⁵"sẽ được chuyển thành"2 5".
Hai thao tác và hai tùy chọn được kết hợp theo nhiều cách để tạo ra bốn "normalization forms." Tôi liệt kê tất cả trong bảng dưới đây, cùng với mô tả và ví dụ input/output:
| Tên | Mô tả | Input | Output |
|---|---|---|---|
| NFD | Canonical Decomposition | Å "\u00c5" |
Å "A\u030A" |
| NFC | Canonical Decomposition Followed by Canonical Composition | Å "A\u030A" |
Å "\u00c5" |
| NFKD | Compatibility Decomposition | ẛ̣ "\u1e9b\u0323" |
ṩ "\u0073\u0323\u0307" |
| NFKC | Compatibility Decomposition Followed by Canonical Composition | ẛ̣ "\u1e9b\u0323" |
ṩ "\u1e69" |
Nếu bạn nhìn bảng này vài phút, bạn có thể bắt đầu thấy các acronym có vẻ hợp lý:
- "NF" là "normalization form."
- "D" là "decomposition"
- "C" là "composition"
- "K" là "kompatibility" :)
Để có thêm ví dụ và giải thích kỹ thuật kỹ hơn, xem Unicode Standard Annex #15.
Chọn dạng chuẩn hóa
Dạng chuẩn hóa bạn nên dùng phụ thuộc vào tác vụ đang thực hiện. Khuyến nghị dưới đây dựa trên Unicode Normalization FAQ.
Dùng NFC cho tương thích chuỗi
Nếu mục tiêu là làm cho các phương thức chuỗi của Ruby chơi tốt với hầu hết Unicode, bạn rất có thể muốn dùng NFC. Có lý do nó là mặc định cho String#unicode_normalize.
- Nó compose các ký tự multi-code-point thành single code point nơi có thể. Ký tự multi-code-point là nguồn gốc của hầu hết vấn đề với phương thức String.
- Nó không thay đổi glyph, vì vậy end-users của bạn sẽ không thấy bất kỳ thay đổi nào trong văn bản họ nhập.
Đó nói, không phải tất cả ký tự multi-code-point đều có thể compose thành single code point. Trong những trường hợp đó, phương thức String của Ruby sẽ hành vi kém:
s = "\u01B5\u0327\u0308" # => "Ƶ̧̈", một ký tự un-composable
s.unicode_normalize(:nfc).size # => 3, dù chỉ có một ký tự
Dùng NFKC cho bảo mật và tương thích DB
Nếu bạn đang làm việc với văn bản liên quan đến bảo mật như username, hoặc chủ yếu quan tâm đến việc văn bản chơi tốt với database của bạn, thì NFKC có lẽ là lựa chọn tốt.
- Nó chuyển đổi các ký tự có thể gây vấn đề thành ký tự tương thích của chúng.
- Sau đó nó compose tất cả ký tự thành single code points.
Để thấy tại sao điều này hữu ích cho bảo mật, hãy tưởng tượng bạn có user với username "HenryIV". Một kẻ xấu có thể cố gắng mạo danh user này bằng cách đăng ký username mới: "HenryⅣ".
Tôi biết, chúng trông giống nhau. Đó là ý. Nhưng thực tế chúng là hai chuỗi khác nhau. Cái trước dùng ký tự ascii "IV" trong khi cái sau dùng ký tự Unicode cho số La Mã 4: "Ⅳ".
Bạn có thể ngăn chặn loại việc này bằng cách dùng NFKC để normalize chuỗi trước khi validate tính duy nhất. Trong trường hợp này, NFKC chuyển đổi unicode "\u2163" thành chữ ascii "IV".
a = "Henry\u2163"
b = "HenryIV"
a.unicode_normalize(:nfc) == b.unicode_normalize(:nfc) # => false, vì NFC giữ glyph
a.unicode_normalize(:nfkc) == b.unicode_normalize(:nfkc) # => true, vì NFKC đánh giá cả hai thành ascii "IV"
Lời kết
Bây giờ tôi đã tìm hiểu kỹ hơn, tôi hơi ngạc nhiên Unicode normalization không phải là chủ đề lớn hơn trong cộng đồng Ruby và Rails. Bạn có thể mong đợi nó được làm cho bạn bởi Rails, nhưng theo tôi biết thì không. Và không normalize dữ liệu user cung cấp nghĩa là nhiều phương thức chuỗi của Ruby không đáng tin cậy.
Nếu các bạn độc giả thân mến biết điều gì tôi không biết, hãy liên hệ qua twitter @StarrHorne hoặc email tại starr@honeybadger.io. Unicode là chủ đề lớn và tôi đã chứng minh tôi không biết mọi thứ về nó. :)