
Bài viết gốc đăng tải ngày 12 tháng 12 năm 2019 tại ObjectRocket.com/blog
Mùa lễ hội đang đến, và mùa này đánh dấu mốc một năm của một cột mốc quan trọng trong lịch sử Rackspace ObjectRocket. Đúng lúc cho mùa lễ hội 2019, chúng tôi giới thiệu High Availability (HA) trên dịch vụ PostgreSQL® của ObjectRocket. Mọi datastore chúng tôi cung cấp trên ObjectRocket đều được xây dựng cho workload sản xuất, yêu cầu HA cho tất cả khách hàng của chúng tôi.
Tại sao HA quan trọng?
Nếu thuật ngữ HA còn lạ với bạn, hãy làm một cái nhìn nhanh về lý do HA quan trọng. Trước hết và quan trọng nhất, ba lợi ích chính của HA là:
- Downtime bằng không hoặc giảm đáng kể
- Bảo vệ chống lại mất dữ liệu
- Tăng hiệu suất cơ sở dữ liệu
Có một vài phương pháp để triển khai HA trên các datastore và một vài công nghệ có sẵn. Tuy nhiên, một thành phần then chốt của hầu hết mọi giải pháp HA là data replica. Điều này nghĩa là bạn chỉ thấy một dataset hoặc database, nhưng phía sau, có một hoặc nhiều replica (bản sao) chính xác của dữ liệu đó. Nếu database chính, primary trong hầu hết các схéma replication, gặp sự cố như lỗi phần cứng, lỗi phần mềm hoặc hỏng dữ liệu, một replica có thể thay thế master. Điểm cuối cùng chạm đến thành phần chính thứ hai của hầu hết hệ thống HA, cơ chế failover tự động (promotion, hoặc election, trong các схéma khác). Replication đảm bảo nhiều bản sao khỏe mạnh của dữ liệu. Tuy nhiên, bạn cũng nên sẵn sàng:
- Phát hiện vấn đề bất ngờ trên primary.
- Chọn replica phù hợp để promote lên primary.
- Sửa primary bị lỗi và tạo replica mới (để thay thế replica đã được promote).
Thành phần cuối cùng, đôi khi kết hợp với thành phần thứ hai, là thiết bị định tuyến yêu cầu đến đúng node. Nếu bạn trỏ ứng dụng của bạn đến primary để ghi dữ liệu (best practice) và primary đó thất bại, ứng dụng của bạn sẽ không trỏ đến primary mới được promote. Một lần nữa, có nhiều cách để giải quyết, nhưng phổ biến nhất là sử dụng proxy hoặc load balancer. Trỏ ứng dụng của bạn đến proxy hoặc load balancer, và nó xác định nơi đúng để gửi lưu lượng của bạn mà không cần trỏ ứng dụng trực tiếp đến server database.
Để gắn kết tất cả lại, hệ thống failover tự động và proxy/load balancer làm việc cùng nhau khi failover xảy ra. Khi bạn promote master mới, proxy hoặc load balancer định tuyến lưu lượng đến master mới. Không có gì thay đổi trong ứng dụng của bạn, và ngoài một chút gián đoạn tiềm năng trong phản hồi trong quá trình promotion, ứng dụng thậm chí không cần biết một promotion đã xảy ra. Đây là cái nhìn tổng quan cấp cao về quy trình, bao gồm các thành phần cơ bản. Bây giờ hãy đi sâu vào công nghệ chúng tôi sử dụng cho từng thành phần của giải pháp của chúng tôi.
Công nghệ chúng tôi sử dụng
Bây giờ chúng tôi đã xem lại các thành phần then chốt, hãy đi sâu vào cách chúng tôi cung cấp từng thành phần trước đó:
Replication
Postgres hỗ trợ nhiều lược đồ replication gốc. Bạn hiện có thể cấu hình một hoặc hai replica, nhưng chúng tôi sẽ mở rộng tùy chọn trong tương lai. Một điểm tinh tế khác của replication là khái niệm replication synchronous và asynchronous. Với synchronous replication, primary chờ mỗi replica xác nhận việc ghi kết thúc trước khi primary coi việc ghi là hoàn tất. Trong asynchronous, primary bắn ghi đến replica nhưng không xác nhận hoàn thành của chúng trước khi xác nhận ghi của ứng dụng hoặc client. Giải pháp chúng tôi sử dụng cho phép chúng tôi hỗ trợ cả asynchronous và synchronous replication. Theo mặc định, chúng tôi bật synchronous replication, và chúng tôi cấu hình replication trong môi trường của chúng tôi để xác nhận việc ghi đã được ghi vào Write-ahead Log (WAL) trên primary và ít nhất một replica. Bạn có thể thay đổi cài đặt cho mỗi transaction hoặc session.
Failover và promotion
Có một vài công cụ mã nguồn mở và bên thứ ba để cung cấp chức năng failover và promotion, nhưng chúng tôi chọn Patroni vì các đặc điểm ưu việt sau:
- Hỗ trợ Kubernetes® gốc: Chúng tôi xây dựng nền tảng mới dựa trên Kubernetes, vì vậy bạn có thể áp dụng một công cụ chỉ cần plug vào Kubernetes, thay vì cần một state hoặc cơ chế consensus khác. Tùy chọn này là then chốt.
- Phát triển và cộng đồng hoạt động: Cộng đồng xung quanh Patroni cực kỳ hoạt động và cho phép hợp tác và đóng góp thêm của chúng tôi khi chức năng phát triển. Ngoài ra, có nhiều tài nguyên, từ bài thuyết trình hội nghị và tài liệu đến ví dụ operator từ Zalando, để giúp chúng tôi học công nghệ.
- Kiến trúc đơn giản: Nhiều công cụ khác có sẵn yêu cầu tài nguyên chuyên dụng bên ngoài instance Postgres để xử lý load balancing và primary promotion. Patroni bao quanh Postgres và sử dụng thành phần Kubernetes gốc để xử lý các chức năng khác, vì vậy chúng tôi không cấp phát tài nguyên bổ sung cho HA.
Mặc dù kết quả của bạn có thể khác, chúng tôi đã thấy Patroni là một sự lựa chọn tuyệt vời, dễ cấu hình và bảo trì trong môi trường của chúng tôi. Bạn cơ bản chỉ nói cho Patroni biết node nào thuộc HA group nào, và nó làm phần còn lại. Nó cấu hình replication, phát hiện primary thất bại, promote replica, tạo replica mới, và thậm chí làm việc với Kubernetes trên phần cuối của quy trình.
Request routing
Cuối cùng, Patroni và một cấu trúc Kubernetes gốc, gọi là service, đại diện cho mảnh ghép cuối cùng. Một service trong Kubernetes hoạt động như một proxy định tuyến lưu lượng dựa trên label trên một nhóm container (một pod). Patroni gán label master cho primary đang hoạt động, và Kubernetes lo việc định tuyến lưu lượng database chỉ đến các pod có label master. Hãy nhớ đây là mô tả cấp cao, nhưng trong thực tế đó là cách nó hoạt động. Quy trình này cũng có thể được mở rộng để cung cấp cổng thứ hai định tuyến yêu cầu đọc database đến replica (để giảm tải trên primary).
Đó là cái nhìn nhanh về công nghệ đang có, nhưng hãy cho chúng tôi biết nếu bạn muốn nghe thêm. Chúng tôi thích nói về kỹ thuật với khách hàng.
Thử ngay bây giờ!
Màn hình Create an Instance trong Mission Control có một phần ở Bước 2 gọi là Customize Your Instance. Tại đó bạn có thể nhấp vào hộp để chuyển mũi tên sang màu xanh, thêm HA replica cho instance PostgreSQL của bạn. Bạn cũng có thể chọn số lượng replica (một hoặc hai) bằng cách nhấp vào ba chấm (…) ở góc trên bên phải.
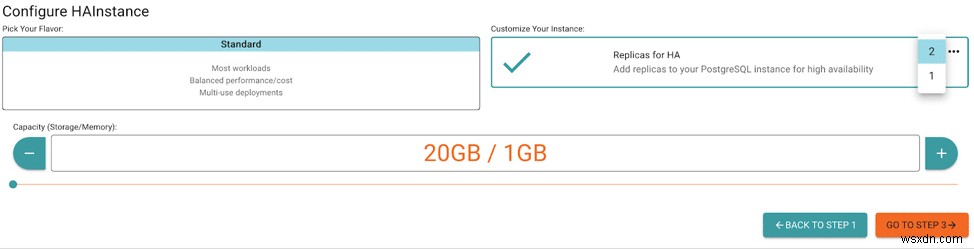
Theo mặc định, chúng tôi khuyên dùng hai replica, để ngay cả trong sự cố bạn vẫn có redundancy, nhưng bạn có thể chọn một.
Sử dụng tab Phản Hồi để đưa ra bình luận hoặc đặt câu hỏi. Bạn cũng có thể nhấp vào Sales Chat để trò chuyện ngay và bắt đầu cuộc hội thoại.