
Trong các bài về Big Data, chúng ta đã thảo luận về Các Lớp Chức Năng của Big Data và bài trước liệt kê Top 11 Công Cụ Lưu Trữ Đám Mây. Bước tiếp theo sau lưu trữ là Quy Trình Làm Sạch Dữ Liệu (Data Cleansing).
Khi nói về Big Data, rõ ràng dữ liệu tăng với tốc độ báo động — dù dữ liệu kinh doanh hay cá nhân. Theo thực tế, mỗi ngày tạo ra 2.5 Quintillion Byte dữ liệu trên thế giới. Dữ liệu này cũng chứa bản ghi lặp lại và sai sót cần loại bỏ trước khi khai thác insight. Dữ liệu không chính xác dẫn đến giả định/sai phân tích, cuối cùng làm dự án thất bại.
Data Cleansing (Làm sạch dữ liệu) là quy trình sửa chữa và loại bỏ (nếu cần) bản ghi không chính xác từ database. Mục đích: phát hiện "Dirty Data" để sửa đổi hoặc xóa, đảm bảo tập dữ liệu chính xác và nhất quán với các tập khác trong hệ thống.
Có nhiều công cụ Data Cleaning. Công cụ tốt giúp làm sạch database: dữ liệu trùng lặp, mục nhập xấu, thông tin sai. Các công cụ chia theo môi trường sử dụng:
- Công cụ Làm Sạch Dữ Liệu Ngoại Tuyến (Offline)
- Công cụ Làm Sạch Dữ Liệu Trên Đám Mây (Cloud-based)
- Công cụ Làm Sạch Dữ Liệu cho Salesforce.
Bài này giới thiệu các công cụ Offline Data Cleaning tốt.
1. Drake
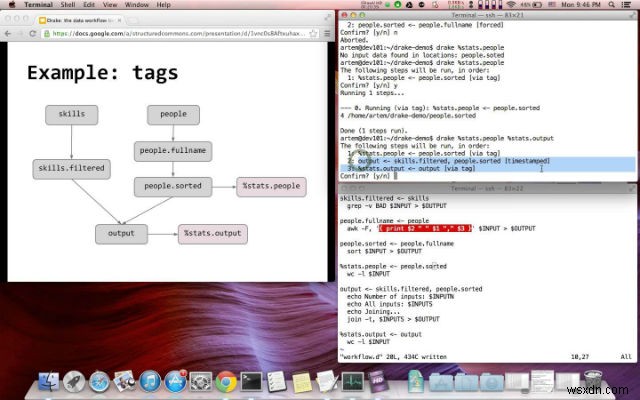
Drake là công cụ quy trình dữ liệu dựa trên văn bản, dễ dùng, mở rộng, tổ chức thực thi lệnh quanh dữ liệu và phụ thuộc của nó. Các bước xử lý dữ liệu được định nghĩa cùng input/output. Tự động giải quyết phụ thuộc và cung cấp nhiều tùy chọn kiểm soát quy trình. Hỗ trợ nhiều input/output và có hỗ trợ HDFS built-in.
2. OpenRefine
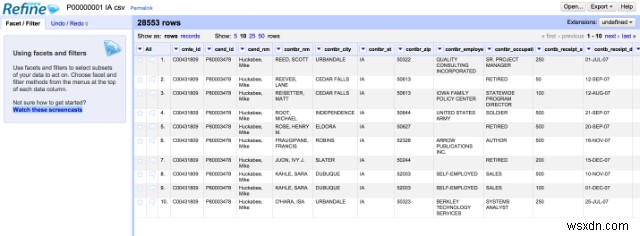
OpenRefine (trước gọi Google Refine) là ứng dụng desktop mạnh mẽ, mã nguồn mở, độc lập để làm việc với dữ liệu lộn xộn. Cung cấp tính năng "data wrangling": làm sạch và chuyển đổi dữ liệu từ định dạng này sang định dạng khác. Giống spreadsheet nhưng hành xử như database.
Hoạt động trên dữ liệu tương tự bảng quan hệ: thao tác trên hàng dữ liệu với ô dưới cột. Một project OpenRefine = một bảng. Người dùng thay đổi hiển thị hàng bằng các tiêu chí lọc. Mọi hành động trên dataset được lưu trong project và có thể replay trên dataset khác.
3. Trifacta Wrangler
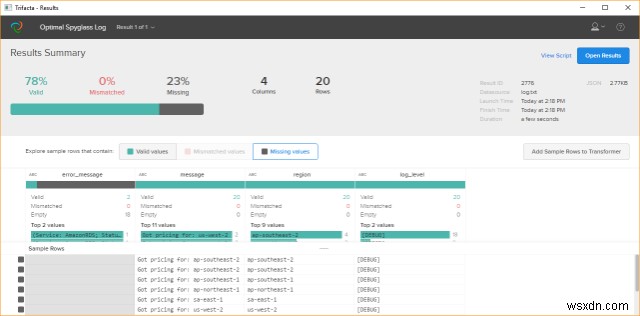
Công cụ này hỗ trợ quy trình Data Wrangling. Data wrangling là quá trình chuyển đổi/ánh xạ dữ liệu từ dạng thô sang định dạng khác thuận tiện hơn cho tiêu dùng, với hỗ trợ bán tự động.
Wrangler cải thiện mạnh mẽ cách tổ chức trích xuất giá trị từ dữ liệu đa dạng. Với Trifacta Wrangler, cách tiếp cận mới được áp dụng: cách analyst làm dữ liệu hữu ích bằng kỹ thuật visualization, machine learning, human-computer interaction, xử lý dữ liệu mới nhất. Mục tiêu đơn giản: ít thời gian định dạng, nhiều thời gian phân tích. Cho phép chuyển đổi tương tác dữ liệu lộn xộn thực tế thành bảng dữ liệu cho công cụ phân tích.
4. DataCleaner
DataCleaner là ứng dụng phân tích chất lượng dữ liệu và nền tảng giải pháp Data Quality. Cốt lõi là engine profiling mạnh, mở rộng, thêm làm sạch dữ liệu, chuyển đổi, làm giàu, khử trùng lặp, khớp và hợp nhất. Tính năng:
- Tìm pattern, giá trị thiếu, tập ký tự và đặc điểm khác của giá trị dữ liệu.
- Làm sạch thông tin liên lạc với xác thực tên và địa chỉ.
- Phát hiện trùng lặp dùng fuzzy logic và trọng số/ngưỡng cấu hình. Tạo phiên bản đơn nhất.
- Xây dựng quy tắc làm sạch riêng và tổ hợp thành nhiều kịch bản sử dụng và database mục tiêu.
5. Winpure Clean and Match
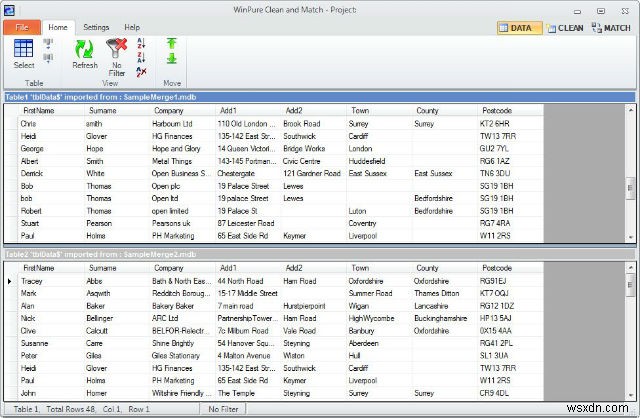
Kiểm soát chất lượng dữ liệu là yếu tố then chốt thành công dự án/chiến dịch. Là bộ làm sạch và khớp dữ liệu, thiết kế đặc biệt tăng độ chính xác dữ liệu kinh doanh/tiêu dùng. Phần mềm giải thưởng, lý tưởng cho làm sạch, sửa chữa, khử trùng lặp danh sách gửi thư, database, spreadsheet, CRM. Dùng cho database: Access, Dbase, SQL Server, Excel, Txt.
6. TIBCO Clarity
TIBCO Clarity là công cụ chuẩn bị dữ liệu cung cấp dịch vụ phần mềm theo yêu cầu từ web dưới dạng SaaS. Dùng để khám phá, profiling, làm sạch, chuẩn hóa dữ liệu thô từ nhiều nguồn khác nhau và cung cấp dữ liệu chất lượng cao cho phân tích chính xác và ra quyết định thông minh. Tính năng quản lý dữ liệu thô:
- Tích hợp liền mạch
- Khám phá và Profiling dữ liệu
- Khử trùng lặp (De-duplication)
- Chuẩn hóa địa chỉ
- Chuyển đổi dữ liệu
7. Data Ladder
Data Ladder là công ty phần mềm chất lượng dữ liệu, mục tiêu giúp người dùng kinh doanh tận dụng tối đa dữ liệu qua matching, profiling, de-duplication, enrichment. Bộ Data Match Enterprise là ứng dụng làm sạch dữ liệu desktop trực quan cao, thiết kế chuyên biệt giải quyết vấn đề chất lượng dữ liệu khách hàng/liên hệ. Data Match Enterprise bao gồm nhiều thuật toán độc quyền và tiêu chuẩn phát hiện biến thể âm vị, fuzzy, gõ sai, viết tắt.
Phần mềm Khử trùng lặp dữ liệu cung cấp giải pháp hoàn chỉnh cho chất lượng dữ liệu, làm sạch, matching, de-duplication trong một bộ dễ dùng.
8. Star DQ Pro
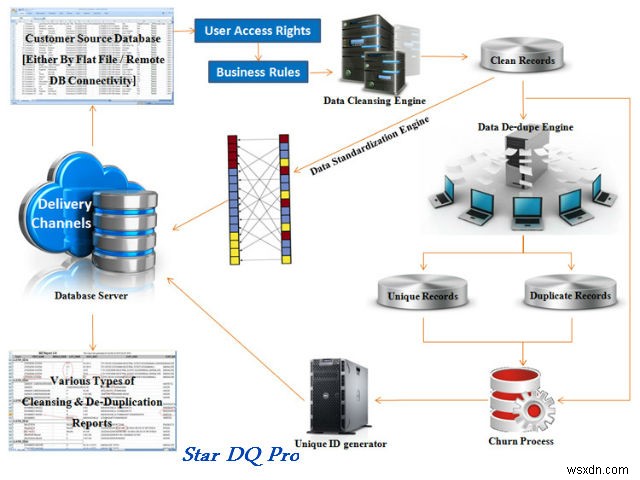
Đảm bảo dữ liệu chính xác, thật và cập nhật. Đáp ứng yêu cầu then chốt chất lượng dữ liệu: chính xác, hoàn chỉnh, nhất quán, kịp thời, duy nhất, hợp lệ. Tính năng:
- Làm sạch (Cleansing) — xác định loại khiếm khuyết, tạo log dữ liệu không sạch với chú thích.
- Khử trùng lặp (De-duping) — nhóm và cụm, xác định biểu diễn sai, khử trùng lặp tăng dần liên tục.
- Giám sát (Monitoring) — log giao dịch, cảnh báo trạng thái tiến trình qua mail/SMS, xác thực người dùng.
Làm sạch dữ liệu đặc biệt quan trọng khi lưu trữ lượng lớn dữ liệu. Mục tiêu hành động sửa chữa trên dirty data là làm cho lỗi trở nên không đáng kể. Trừ khi làm sạch dữ liệu thường xuyên, sai lầm tích lũy và làm giảm hiệu quả công việc. Bài sau về Big Data sẽ liệt kê công cụ làm sạch dữ liệu trên đám mây và công cụ cho database Salesforce.