
Bạn có bao giờ nhận ra search box gợi ý từ khi bạn gõ? Tính ra, hầu hết gợi ý này hiện theo thứ tự alphabet đơn giản và không siêu hữu ích.
Nhưng nếu search box có thể thông minh hơn theo thời gian?
Học từ những gì người thực sự click và hiện kết quả phổ biến nhất trước?
Đây là điều chúng ta sẽ xây dựng:
Chúng ta sẽ thấy Redis Sorted Sets làm thế nào để power một hệ thống autocomplete thông minh, học từ hành vi user và trở nên chính xác hơn (hiện kết quả phổ biến trước) theo thời gian.
Ý Tưởng Của Hệ Thống Autocomplete Thông Minh
Một search box cơ bản sẽ dùng phương pháp gọi là prefix matching để quyết định kết quả nào hiện trước.
Khi bạn gõ, nó hiện match theo thứ tự A-Z. Nó không thực sự quan tâm kết quả nào người ta click nhiều nhất.
Chúng ta sẽ làm cho nó thông minh hơn. Search box của chúng ta sẽ học từ những gì người chọn. Khi người click vào kết quả search, chúng ta sẽ hiện kết quả đó trước lần sau.
Điều này nghĩa là search của chúng ta tốt hơn và hữu ích hơn theo thời gian bằng cách tự động hiện gợi ý phổ biến nhất lên đầu.
Tại Sao Điều Quan Trọng Cho Ứng Dụng Search
Xét ứng dụng search phim: khi user gõ "int". Họ có thể thấy:
- "Interceptor"
- "Interstate 60"
- "Interstellar"
Trong hệ thống "truyền thống", những thứ này hiện theo alphabet. Tuy nhiên, nếu user liên tục click "Interstellar", chúng ta muốn promote nó lên đầu gợi ý autocomplete.
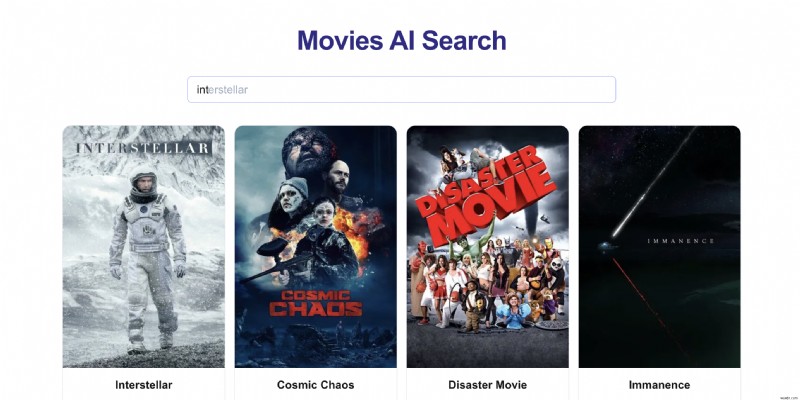
Hệ thống smart ranking này hoạt động tốt cho:
- Dịch vụ streaming như Netflix hoặc YouTube hiện thứ người xem nhiều nhất
- Cửa hàng online hiện sản phẩm phổ biến trước khi search
- Trung tâm giúp đỡ hiện câu hỏi phổ biến nhất
- Bất kỳ website có search để hiện thứ đa số người click trước
Hiểu Redis Sorted Sets
Hãy hiểu tại sao Redis Sorted Sets tuyệt vời cho xây dựng autocomplete system.
Redis Sorted Set giống như smart list nơi:
- Mỗi item unique (như set)
- Mỗi item có score (để ordering)
- Item có thể sort nhanh theo score
Cho autocomplete system, chúng ta dùng hai sorted set:
- Một cho matching text prefix (ví dụ "int" match "interstellar")
- Một để track popularity của mỗi gợi ý
Hai set này làm việc cùng nhau để gợi ý kết quả relevant nhất khi user gõ.
Foundation: Alphabetical Ordering
Redis Sorted Sets maintain alphabetical ordering khi tất cả member có cùng score. Điều này hoàn hảo cho building search suggestions vì nó cho phép:
- Lưu tất cả prefix của term có thể search trong một data structure
- Dùng
ZRANKtìm vị trí bắt đầu của prefix bất kỳ trong O(log N) time - Dùng
ZSCANretrieve hiệu quả tất cả match bắt đầu từ vị trí đó - Dùng
ZMSCORElấy popularity score của mỗi match - Dùng
ZINCRBYtăng popularity score của mỗi match
Hãy xem ví dụ đơn giản. Khi thêm phim "INTERSTELLAR" vào search system, chúng ta break nó như sau:
- Score: 0, Member: "I"
- Score: 0, Member: "IN"
- Score: 0, Member: "INT"
- Score: 0, Member: "INTE"
- Score: 0, Member: "INTER"
- Score: 0, Member: "INTERSTELLAR$Interstellar" (complete entry với display format)
Thấy không, chúng ta dùng $ để tách search version từ display version? Cách này, user search không lo uppercase/lowercase, nhưng chúng ta vẫn hiện title phim đúng như nó nên trông.
Cách Chúng Ta Lưu Dữ Liệu
Chúng ta dùng hai Redis sorted sets để làm autocomplete work:
1. Danh Sách Title Phim
Hãy theo dõi sorted set gọi là movies. Nghĩ như dictionary giúp tìm phim nhanh. Khi ai gõ "int", chúng ta instantly tìm tất cả phim bắt đầu bằng chữ đó.
First occurrence của "int" sẽ được tìm bởi ZRANK và từ vị trí đó full movie name với wild card INT*$* sẽ được fetch.
2. Danh Sách Phim Phổ Biến
Hãy cũng theo dõi sorted set gọi là movie-popularity. Đây là list "trending movies" của chúng ta.
Mỗi khi ai click phim trong kết quả search, phim đó phổ biến hơn bằng cách increment score dùng ZINCRBY. Phim click nhiều nhất hiện trước trong search tương lai.
Giống như Netflix hiện trending movies — càng nhiều người xem, càng cao trong recommendation.
Trong case của chúng ta, sau khi tìm exact match cho INT*$*, chúng ta check score ở movie-popularity để lấy thứ phổ biến nhất.
Algorithmic Flow
graph TD A[User types 'int'] --> B[ZRANK: Find lexicographic position of 'INT'] B --> C[ZSCAN: Retrieve matches starting from position (movies set)] C --> D[Filter: Extract complete terms containing '$'] D --> E[ZMSCORE: Get popularity scores for all matches (movie-popularity set)] E --> F[Rank: Return highest-scored suggestion] G[User selects suggestion] --> H[ZINCRBY: Increment popularity score] H --> I[Future searches: Higher scored items rank first] I --> AKhi user search và click suggestion, system học và cải thiện. Càng nhiều người dùng, nó tốt hơn ở việc hiện gợi ý relevant nhất trước.
Hãy Xây Dựng Hệ Thống Autocomplete
Hãy xem cách build autocomplete system từng bước. Chúng ta giữ nó siêu đơn giản!
Bước 1: Thêm Title Phim Vào Redis
Trước tiên, cần thêm title phim vào Redis để search sau. Bạn có thể bắt đầu với list phim đơn giản từ đâu đó — có thể database hoặc chỉ text file. Đây cách thêm:
import { Redis } from "@upstash/redis"; const redis = new Redis({ url: process.env.UPSTASH_REDIS_URL!, token: process.env.UPSTASH_REDIS_TOKEN!, }); // Example: your list of titles const titles = [ "Interceptor", "Interstate 60", "Interstellar", // ... more titles ]; async function populateAutocomplete() { // Insert prefixes and full titles into the 'movies' sorted set for (const title of titles) { let term = title.toUpperCase(); let terms = []; for (let i = 1; i < term.length; i++) { terms.push({ score: 0, member: term.substring(0, i) }); } terms.push({ score: 0, member: term }); terms.push({ score: 0, member: term + "$" + title }); await redis.zadd("movies", ...terms); } // Insert all titles into the 'movie-popularity' sorted set for popularity tracking await redis.zadd( "movie-popularity", ...titles.map((title) => ({ score: 0, member: title.toUpperCase(), })), ); } populateAutocomplete();Hãy break down code trên làm gì:
-
Với mỗi title phim, chúng ta lưu:
- Tất cả partial match có thể (như "INT", "INTE", "INTER" cho "Interstellar")
- Complete title chính nó
- Formatted version cho display
-
Chúng ta cũng tạo separate list track popularity của mỗi phim, bắt đầu từ zero view
Điều này cho chúng ta mọi thứ cần để hiện smart suggestion khi user gõ và học từ gì họ click.
Bước 2: Tìm Best Matches
Tiếp theo, xem cách search qua title phim để tìm match. Function matchQuery làm tất cả heavy lifting:
export const matchQuery = async (query: string): Promise<string | null> => { const upperQuery = query.toUpperCase(); // Step 1: Find starting position using lexicographic ordering let rank = await redis.zrank("movies", upperQuery); if (rank === null) return null; // Step 2: Efficiently scan for matches from that position const scanResult = await redis.zscan("movies", rank, { match: `${upperQuery}*$*`, count: 1000, }); // Step 3: Extract complete entries and get their popularity scores const completeTitles = scanResult[1].filter( (el, idx) => idx % 2 === 0 && el.includes("$"), ); const baseNames = completeTitles.map((title) => title.split("$")[0]); const scores = await redis.zmscore("movie-popularity", baseNames); // Step 4: Return the highest-scored (most popular) match const maxScore = Math.max(...scores); const bestMatchIndex = scores.indexOf(maxScore); return completeTitles[bestMatchIndex].split("$")[1]; };Học Từ Lựa Chọn Của User
Khi ai chọn title phim, chúng ta cộng 1 điểm vào score. Phim nhiều điểm hơn hiện cao hơn trong suggestion list. Đơn giản vậy!
Hệ thống thông minh hơn theo thời gian bằng cách track những gì người thực sự chọn.
const onSubmit = async (title: string) => { // Handle submit logic here await redis.zincrby("movie-popularity", 1, title.toUpperCase()); };Nhanh Đến Mức Nào?
Hãy xem solution này nhanh thế nào bằng cách break down time mỗi operation tốn:
- ZRANK: O(log N) - Logarithmic lookup time
- ZSCAN: O(log N + M) - M là số element returned
- ZMSCORE: O(N) - N là số matched results, không phải total dataset size
- ZINCRBY: O(log N) - Atomic increment với logarithmic complexity
Khi thêm nhiều title phim, performance vẫn consistent.
Kết Luận: Những Gì Chúng Ta Xây Dựng Cùng Nhau
Bạn vừa học cách build smart search box tốt hơn theo thời gian không cần AI!
Autocomplete của chúng ta học từ những gì người chọn và dùng info đó để hiện suggestion tốt hơn.
Nó nhanh, đơn giản, và trở nên hữu ích hơn càng nhiều người dùng.
Muốn nói về Redis optimization strategy hoặc share implementation của bạn? Join chúng tôi trên Discord!