
Chúng tôi vui mừng thông báo phát hành milestone đầu tiên trong phát triển RediSearch 2.0. RediSearch là công cụ tìm kiếm thời gian thực cho phép truy vấn dữ liệu Redis để trả lời đa dạng câu hỏi phức tạp.
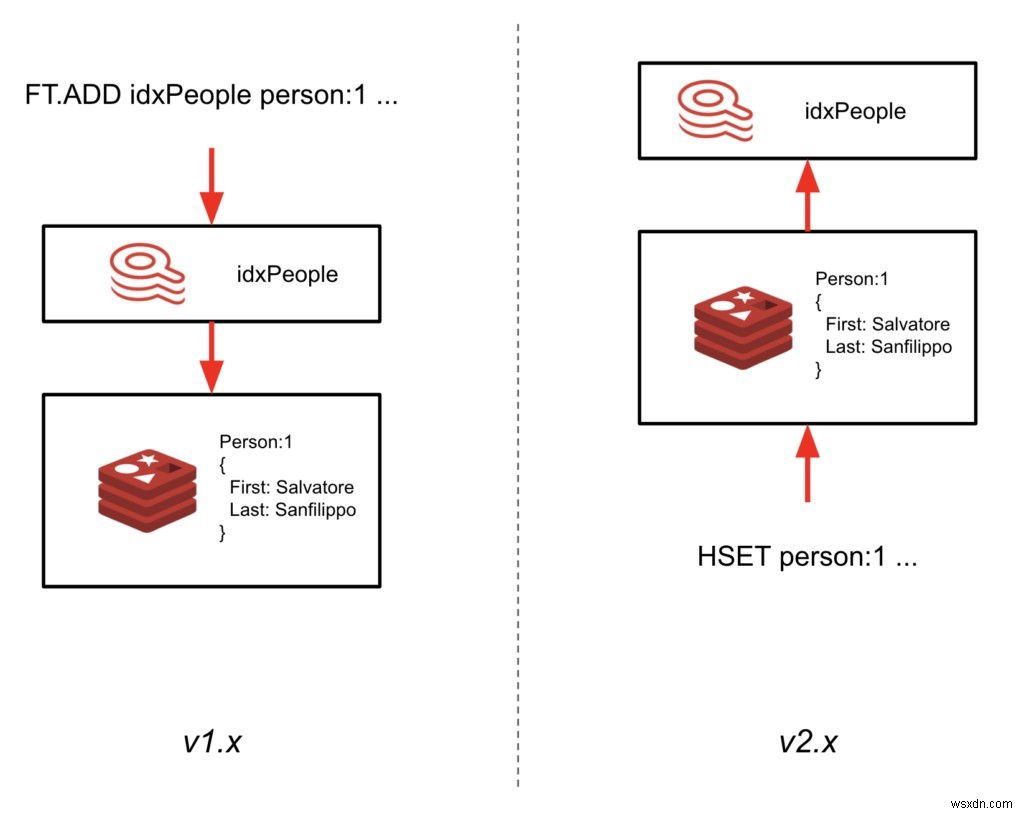
Milestone này, gọi là 2.0-M01, đánh dấu việc tái cấu trúc cách index được giữ đồng bộ với dữ liệu. Thay vì phải ghi dữ liệu qua index (dùng lệnh FT.ADD), RediSearch sẽ theo dõi dữ liệu ghi vào hash và tự động indexing.
Lợi ích lớn: bạn có thể thêm RediSearch vào instance Redis hiện có và tạo secondary index mà không cần cập nhật code ứng dụng. Điều này cho phép ngay lập tức sử dụng RediSearch trên dữ liệu hiện có, chỉ bằng cách load module RediSearch và định nghĩa schema. General availability của RediSearch 2.0 dự kiến vào mùa Thu năm nay.
(Lưu ý: Tính năng mới này đưa ra một số thay đổi API (liệt kê dưới). Chúng tôi cố gắng duy trì backward compatibility tối đa, nhưng trường hợp này không thể. Chúng tôi dự định điều chỉnh và sửa lỗi tiếp theo khi thu thập feedback khách hàng.)
Thay đổi API
Như đã ghi, milestone RediSearch 2.0 này bao gồm vài thay đổi API:
- Index không còn nằm trong key space. Nếu bạn dùng key index (idx:<index name>) để liệt kê index trong database, ví dụ, sẽ không còn hoạt động. Tuy nhiên, chúng tôi giới thiệu lệnh FT._LIST trả về tất cả index trong database.
- Index phải tạo với prefix/filter. Chúng chỉ định document nào sẽ được RediSearch tự động index. Bạn có thể chỉ định prefix đơn giản và/hoặc biểu thức filter phức tạp.
- Không thể upgrade. Nếu bạn có RDB tạo bằng phiên bản RediSearch cũ, RediSearch 2.0 sẽ không đọc được. Hiện tại bạn phải re-index toàn bộ dataset. Chúng tôi đang làm quy trình upgrade cho GA release.
- Chỉ hoạt động với Redis 6 trở lên.
- Các lệnh FT được map sang lệnh Redis tương đương. Cho phép ứng dụng hiện có vẫn hoạt động với RediSearch 2.0. Mapping như sau:
- FT.ADD => HSET
- FT.DEL => DEL (DD mặc định)
- FT.GET => HGETALL
- FT.MGET => HGETALL
- Inverted index không còn lưu vào RDB. Không có nghĩa persistency không được hỗ trợ. RediSearch lưu định nghĩa index vào RDB và index dữ liệu background sau khi Redis khởi động. Bạn có thể kiểm tra trạng thái indexing bằng lệnh FT.INFO.
API mới
Cập nhật lớn nhất API là cách tạo index. Trong RediSearch 2.0 lệnh FT.CREATE dùng để tạo index. Các bổ sung API được highlight vàng:
FT.CREATE {index} ON {structure} [PREFIX {count} {prefix} [{prefix} ..] [FILTER {filter}] [LANGUAGE_FIELD {lang_field}] [LANGUAGE {lang}] [SCORE_FIELD {score_field}] [SCORE {score}] [PAYLOAD_FIELD {payload_field}] [TEMPORARY {seconds}] [MAXTEXTFIELDS] [NOOFFSETS] [NOHL] [NOFIELDS] [NOFREQS] [STOPWORDS {num} {stopword} ...] SCHEMA {field} [TEXT [NOSTEM] [WEIGHT {weight}] [PHONETIC {matcher}] | NUMERIC | GEO | TAG [SEPARATOR {sep}] ] [SORTABLE][NOINDEX] ...
Hãy đi sâu vào chi tiết:
- ON {structure} hiện chỉ hỗ trợ HASH
- PREFIX {count} {prefix} cho index biết key nào nên index. Có thể thêm nhiều prefix. Vì argument optional, mặc định là * (tất cả key)
- FILTER {filter} là biểu thức filter với ngôn ngữ aggregation expression đầy đủ của RediSearch. Có thể dùng @__key truy cập key vừa thêm/thay đổi
- LANGUAGE và SCORE cho phép override ngôn ngữ và score mặc định cho tất cả document được index
- LANGUAGE_FIELD, SCORE_FIELD, và PAYLOAD_FIELD cho phép language và scoring riêng cho từng document, và dùng payload như field trong document.
Các giới hạn và thay đổi khác
Milestone RediSearch 2.0-M01 cũng mang lại vài cập nhật khác:
- NOSAVE không còn hỗ trợ.
- Cập nhật hash ngụ ý toàn bộ document sẽ được index (keyspace notifications không chỉ field nào thay đổi). Vì vậy partial updates sẽ chậm hơn. Lưu ý chúng tôi vẫn đang điều tra tùy chọn cải thiện hiệu suất trong trường hợp này.
- Tên field giờ phân biệt chữ hoa/thường, nên khai báo field “FOO” và index như “foo” sẽ không hoạt động.
- Lệnh FT.ADD sẽ map sang hset như sau:
FT.ADD idx doc1 1.0 LANGUAGE eng PAYLOAD payload FIELDS f1 v1 f2 v2
Map sang
HSET doc1 __score 1.0 __language eng __payload payload f1 v1 f2 v2
Điều này có nghĩa field score, language, payload trên index phải tên __score, __language, __payload tương ứng để mapping hoạt động như mong đợi.
- FT.ADDHASH không còn hỗ trợ. Dùng HSET.
- FT.OPTIMIZE không còn hỗ trợ, hàm Garbage Collection của RediSearch chịu trách nhiệm tối ưu index.
Kết luận
Chúng tôi rất hào hứng về những thay đổi này vì bạn giờ có thể load RediSearch vào database Redis hiện có và index dữ liệu hiện có trong hash, mà không cần cập nhật logic ứng dụng khi thao tác document. Bạn có thể thử milestone release này bằng cách lấy source code từ GitHub hoặc dùng Docker image 1:99:1 RedisSarch. Phiên bản này chưa sẵn sàng production, nhưng chúng tôi muốn chia sẻ sớm để thu thập feedback. Hãy chia sẻ ý kiến hoặc issue trên GitHub repository hoặc Redis Community forum.