
Redis được phát triển với sự chú trọng lớn vào hiệu suất. Chúng tôi cố gắng hết sức mỗi bản phát hành để đảm bảo bạn trải nghiệm sản phẩm ổn định và nhanh chóng.
Tuy nhiên, nếu bạn thấy còn chỗ cải thiện hiệu suất Redis hoặc đang điều tra hồi quy hiệu suất (performance regression), bạn sẽ cần một phương pháp ngắn gọn, có phương pháp để giám sát và phân tích hiệu suất Redis. Đây là câu chuyện về một trong những tối ưu hóa đó.
Cuối cùng, chúng tôi đã cải thiện hiệu suất ingest của Streams khoảng 20%, cải tiến bạn đã có thể tận dụng trên Redis v7.0.
Một SPEC Chuẩn
Trước khi đi vào tối ưu hóa, chúng tôi muốn đưa ra ý tưởng cấp cao về cách chúng tôi đạt được nó.
Như đã nói, chúng tôi muốn xác định hồi quy hiệu suất Redis và/hoặc cải thiện hiệu suất on-CPU tiềm năng. Để làm vậy, chúng tôi cảm thấy cần thúc đẩy một tập tiêu chuẩn xuyên công ty và xuyên cộng đồng về mọi vấn đề liên quan đến hiệu suất và yêu cầu quan sát (observability) cũng như kỳ vọng.
Tóm lại, chúng tôi liên tục chạy benchmark SPEC bằng cách chia theo branch/tag và giải thích dữ liệu hiệu suất kết quả bao gồm output công cụ profiling/probing và output client ở chế độ "zero-touch" hoàn toàn tự động.
Các công cụ dùng đều open source và dựa trên các framework/popular tools như memtier_benchmark, redis-benchmark, Linux perf_events, bcc/BPF tracing tools, và repo FlameGraph của Brendan Greg.
Nếu bạn quan tâm chi tiết hơn về cách dùng profiler với Redis, khuyến khích xem Hướng dẫn kỹ thuật hiệu suất cho profiling và tracing on-CPU cực chi tiết của chúng tôi.
Tránh Tính Toán Trùng Lặp Để Cải Thiện Hiệu Suất
Ngay khi bước đầu tiên hoàn tất, chúng tôi bắt đầu giải thích output công cụ profiling/probing. Benchmark thú vị nhất là benchmark ingest Streams, đơn giản chỉ ingest dữ liệu vào stream với lệnh như:
`XADD key * field value`
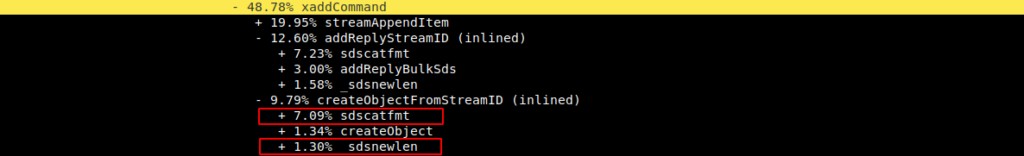
Chúng tôi quan sát thấy khi thêm vào stream không có ID, nó tạo công việc trùng lặp trên SDS creation/freeing/sdslen tốn khoảng 10% chu kỳ CPU, như chi tiết trong hai báo cáo perf report tiếp theo.
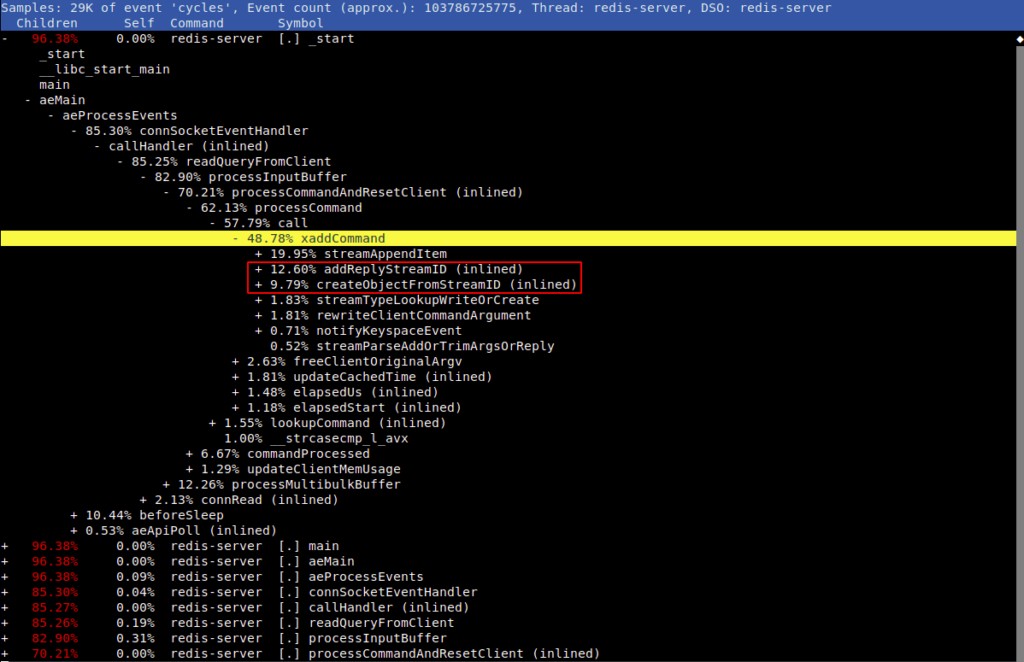
Với cùng đầu vào, sdscatfmt và _sdsnewlen được gọi hai lần:
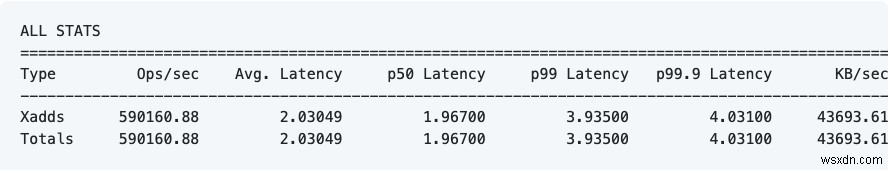
Điều này cho phép tối ưu ingest Streams khoảng 9-10% như kết quả benchmark xác nhận:
Baseline trên branch unstable (6b403f5):
Commit đầu tiên của PR này (tránh việc trùng lặp):
Tránh Phân Bổ Trùng Lặp Để Cải Thiện Hiệu Suất
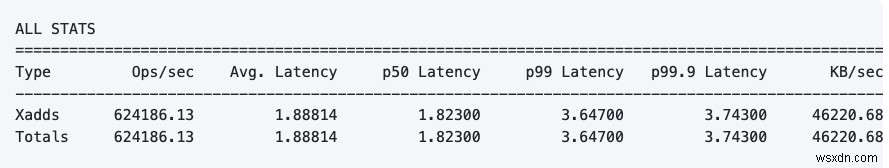
Tập trung ban đầu vào cải tiến use-case này dẫn đến phân tích thêm từ Oran (thành viên core-team) nhận ra thêm một sự lãng phí chu kỳ CPU. Lần này do quản lý bộ nhớ không tối ưu trong cùng khối mã. Chúng tôi cấp phát SDS rỗng, rồi cấp phát lại. Giảm số lần gọi sẽ cho thêm cải tiến tốc độ, như dưới đây.
Commit thứ hai (tránh reallocs):
Cải Thiện Đã Đo Lường
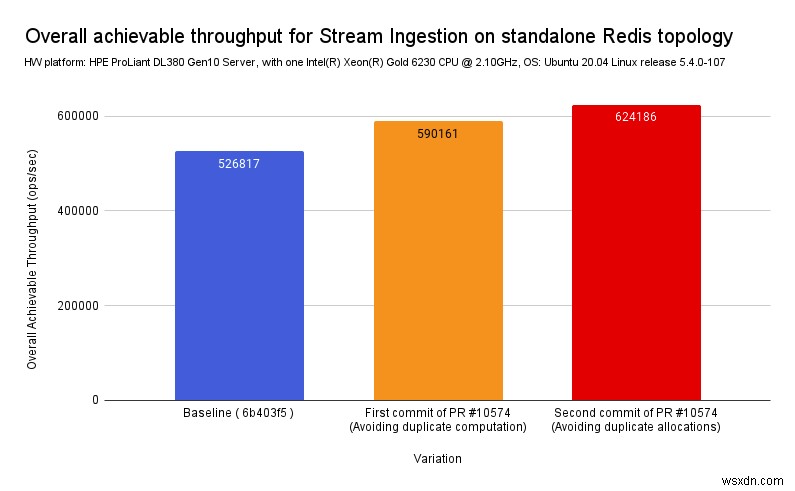
Như dự kiến, bằng cách tái sử dụng kết quả trung gian tính toán và do đó giảm tính toán và phân bổ dư thừa trong các hàm được gọi nội bộ, chúng tôi đo được giảm tổng thời gian CPU ~= 20% của Redis Streams.
Chúng tôi tin đây là ví dụ của cách cải tiến đơn giản, có phương pháp có thể dẫn đến nhảy vọt hiệu suất đáng kể, ngay cả cho mã đã tối ưu sâu như Redis.
Mục tiêu của chúng tôi là mở rộng khả năng quan sát hiệu suất của Redis, và thành viên từ cả ngành công nghiệp và học thuật, bao gồm tổ chức và cá nhân, được khuyến khích đóng góp. Nếu không đo lường, chúng ta không thể cải thiện.