Python cung cấp nhiều thư viện cho phân tích và trực quan hóa dữ liệu, chủ yếu numpy, pandas, matplotlib, seaborn, v.v. Phần này thảo luận về thư viện pandas cho phân tích và trực quan hóa dữ liệu - thư viện mã nguồn mở xây dựng trên numpy.
Nó cho phép phân tích nhanh, làm sạch và chuẩn bị dữ liệu. Pandas cũng cung cấp nhiều tính năng trực quan hóa tích hợp sẵn như dưới đây.
Cài đặt
Để cài pandas, chạy lệnh sau trong terminal:
pip install pandas
Hoặc nếu có Anaconda, dùng:
conda install pandas
Pandas - DataFrames
DataFrame là công cụ chính khi làm việc với pandas.
Mã
import numpy as np
import pandas as pd
from numpy.random import randn
np.random.seed(50)
df = pd.DataFrame(randn(6,4), ['a','b','c','d','e','f'], ['w','x','y','z'])
df
Kết quả
| w | x | y | z | |
|---|---|---|---|---|
| a | -1.560352 | -0.030978 | -0.620928 | -1.464580 |
| b | 1.411946 | -0.476732 | -0.780469 | 1.070268 |
| c | -1.282293 | -1.327479 | 0.126338 | 0.862194 |
| d | 0.696737 | -0.334565 | -0.997526 | 1.598908 |
| e | 3.314075 | 0.987770 | 0.123866 | 0.742785 |
| f | -0.393956 | 0.148116 | -0.412234 | -0.160715 |
Pandas - Dữ liệu thiếu (Missing Data)
Xem một số cách tiện lợi xử lý dữ liệu thiếu trong pandas, tự động điền 0 hoặc NaN.
import numpy as np
import pandas as pd
from numpy.random import randn

d = {'A': [1,2,np.nan], 'B': [9, np.nan, np.nan], 'C': [1,4,9]}
df = pd.DataFrame(d)
df
Kết quả
| A | B | C | |
|---|---|---|---|
| 0 | 1.0 | 9.0 | 1 |
| 1 | 2.0 | NaN | 4 |
| 2 | NaN | NaN | 9 |
Vậy có 3 giá trị thiếu.
df.dropna()
| A | B | C | |
|---|---|---|---|
| 0 | 1.0 | 9.0 | 1 |
df.dropna(axis=1)
| C | |
|---|---|
| 0 | 1 |
| 1 | 4 |
| 2 | 9 |
df.dropna(thresh=2)
| A | B | C | |
|---|---|---|---|
| 0 | 1.0 | 9.0 | 1 |
| 1 | 2.0 | NaN | 4 |
df.fillna(value=df.mean())
| A | B | C | |
|---|---|---|---|
| 0 | 1.0 | 9.0 | 1 |
| 1 | 2.0 | 9.0 | 4 |
| 2 | 1.5 | 9.0 | 9 |
Pandas - Nhập dữ liệu (Import data)
Đọc file CSV từ máy cục bộ (trường hợp của tôi) hoặc trực tiếp từ web.
# Nhập thư viện pandas
import pandas as pd

# Đọc file CSV gán cho biến DataFrame df
df = pd.read_csv("SYB61_T03_Population Growth Rates in Urban areas and Capital cities.csv", encoding="ISO-8859-1")

# Đọc 5 phần tử đầu từ DataFrame
df.head()
Kết quả
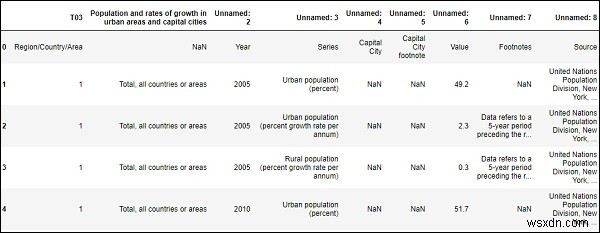
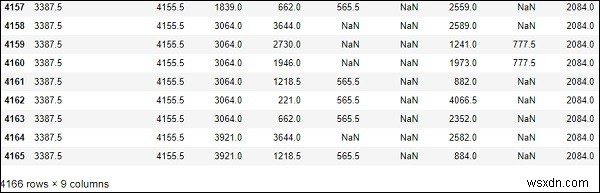
Đọc số hàng và cột trong DataFrame hoặc file CSV.
# Đếm số hàng và cột
df.shape
Kết quả
(4166, 9)
Pandas - Toán học DataFrame
Các phép toán trên DataFrame dùng các công cụ thống kê của pandas.
# Tính toán các thống kê tóm tắt, loại trừ giá trị NaN
df.describe()
Kết quả
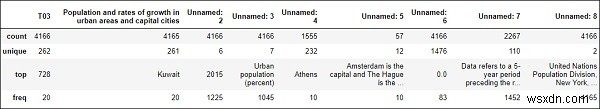
# Tính thứ hạng dữ liệu số
df.rank()
Kết quả
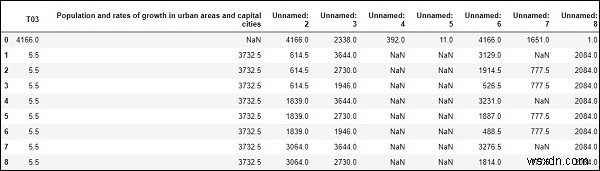
.....
.....
Pandas - Vẽ biểu đồ
import matplotlib.pyplot as plt

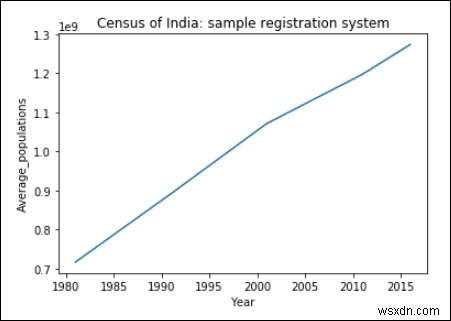
years = [1981, 1991, 2001, 2011, 2016]
Average_populations = [716493000, 891910000, 1071374000, 1197658000, 1273986000]
plt.plot(years, Average_populations)
plt.title("Census of India: sample registration system")
plt.xlabel("Year")
plt.ylabel("Average_populations")
plt.show()
Kết quả
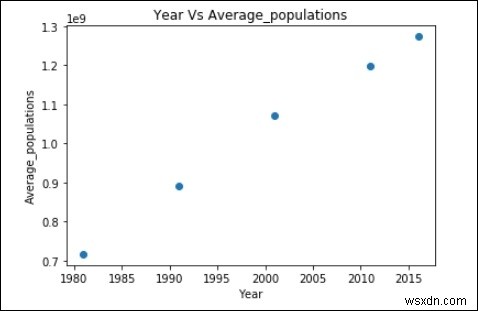
Biểu đồ phân tán của dữ liệu trên:
plt.scatter(years, Average_populations)
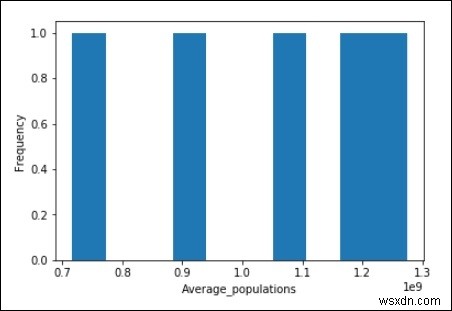
Histogram:
import matplotlib.pyplot as plt
Average_populations = [716493000, 891910000, 1071374000, 1197658000, 1273986000]
plt.hist(Average_populations, bins=10)
plt.xlabel("Average_populations")
plt.ylabel("Frequency")
plt.show()
Kết quả