
Hồi quy Logistic là kỹ thuật thống kê dự đoán kết quả nhị phân (binary outcome). Nó không mới mẻ vì hiện đang áp dụng trong nhiều lĩnh vực từ tài chính, y tế đến tội phạm học và khoa học xã hội khác.
Trong phần này, ta sẽ phát triển hồi quy logistic dùng Python, tuy nhiên có thể triển khai tương tự bằng ngôn ngữ khác như R.
Cài đặt
Các thư viện dùng trong ví dụ:
Numpy: Định nghĩa mảng và ma trận số
Pandas: Xử lý và thao tác dữ liệu
Statsmodels: Ước lượng tham số & kiểm định thống kê
Pylab: Vẽ đồ thị
Cài các thư viện bằng pip chạy lệnh sau trong CLI:
>pip install numpy pandas statsmodels
Ví dụ trường hợp dùng cho Hồi quy Logistic
Để test hồi quy logistic trong Python, ta dùng dữ liệu logit regression do UCLA cung cấp (Institute for digital research and education). Truy cập data dạng csv tại: https://stats.idre.ucla.edu/stat/data/binary.csv
Tôi lưu file csv local và đọc từ đó, bạn có thể làm y như vậy. Với file csv này, ta sẽ xác định các yếu tố ảnh hưởng đến việc nhập học sau đại học (graduate school).
Import thư viện cần thiết & tải dataset
Đọc dữ liệu bằng pandas (pandas.read_csv):
import pandas as pd import statsmodels.api as sm import pylab as pl import numpy as np df = pd.read_csv('binary.csv') # Có thể đọc trực tiếp từ link \ # df = pd.read_csv('https://stats.idre.ucla.edu/stat/data/binary.csv') print(df.head()) Kết quả
admit gre gpa rank 0 0 380 3.61 3 1 1 660 3.67 3 2 1 800 4.00 1 3 1 640 3.19 4 4 0 520 2.93 4
Nhận thấy cột 'rank' có thể gây xung đột vì 'rank' cũng là tên phương thức trong pandas DataFrame. Để tránh xung đột, đổi tên cột rank thành 'prestige'.
df.columns = ["admit", "gre", "gpa", "prestige"] print(df.columns)
Kết quả
Index(['admit', 'gre', 'gpa', 'prestige'], dtype='object')
Bây giờ mọi thứ ổn, có thể nhìn sâu hơn vào dataset.
Tóm tắt dữ liệu
Dùng hàm describe của pandas để có cái nhìn tổng quan.
print(df.describe())
Kết quả
admit gre gpa prestige count 400.000000 400.000000 400.000000 400.00000 mean 0.317500 587.700000 3.389900 2.48500 std 0.466087 115.516536 0.380567 0.94446 min 0.000000 220.000000 2.260000 1.00000 25% 0.000000 520.000000 3.130000 2.00000 50% 0.000000 580.000000 3.395000 2.00000 75% 1.000000 660.000000 3.670000 3.00000 max 1.000000 800.000000 4.000000 4.00000
Có thể lấy độ lệch chuẩn từng cột & bảng tần suất cắt prestige và có được admitted hay không.
# Xem độ lệch chuẩn từng cột print(df.std())
Kết quả
admit 0.466087 gre 115.516536 gpa 0.380567 prestige 0.944460 dtype: float64
Ví dụ
# Bảng tần suất cắt prestige và admitted print(pd.crosstab(df['admit'], df['prestige'], rownames = ['admit']))
Kết quả
prestige 1 2 3 4 admit 0 28 97 93 55 1 33 54 28 12
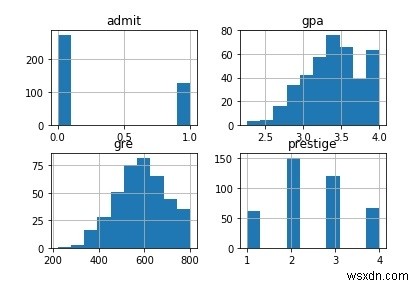
Vẽ tất cả cột của dataset.
# plot all of the columns df.hist() pl.show()
Kết quả
Biến giả (Dummy Variables)
Thư viện pandas cung cấp sự linh hoạt lớn trong cách biểu diễn biến phân loại (categorical variables).
# dummify rank dummy_ranks = pd.get_dummies(df['prestige'], prefix='prestige') print(dummy_ranks.head())
Kết quả
prestige_1 prestige_2 prestige_3 prestige_4 0 0 0 1 0 1 0 0 1 0 2 1 0 0 0 3 0 0 0 1 4 0 0 0 1
Ví dụ
# Tạo dataframe sạch cho hồi quy cols_to_keep = ['admit', 'gre', 'gpa'] data = df[cols_to_keep].join(dummy_ranks.ix[:, 'prestige_2':])
Kết quả
admit gre gpa prestige_2 prestige_3 prestige_4 0 0 380 3.61 0 1 0 1 1 660 3.67 0 1 0 2 1 800 4.00 0 0 0 3 1 640 3.19 0 0 1 4 0 520 2.93 0 0 1
Thực hiện hồi quy
Giờ làm logistic regression, khá đơn giản. Chỉ cần chỉ định cột chứa biến muốn dự đoán, tiếp theo là các cột mô hình dùng để dự đoán.
Ta dự đoán cột admit dựa trên gre, gpa và các biến giả prestige: prestige_2, prestige_3, prestige_4.
train_cols = data.columns[1:] # Index([gre, gpa, prestige_2, prestige_3, prestige_4], dtype=object) logit = sm.Logit(data['admit'], data[train_cols]) # fit the model result = logit.fit()
Kết quả
Optimization terminated successfully. Current function value: 0.573147 Iterations 6
Diễn giải kết quả
Tạo output tóm tắt dùng statsmodels.
print(result.summary2())
Kết quả
Results: Logit =============================================================== Model: Logit No. Iterations: 6.0000 Dependent Variable: admit Pseudo R-squared: 0.083 Date: 2019-03-03 14:16 AIC: 470.5175 No. Observations: 400 BIC: 494.4663 Df Model: 5 Log-Likelihood: -229.26 Df Residuals: 394 LL-Null: -249.99 Converged: 1.0000 Scale: 1.0000 ---------------------------------------------------------------- Coef. Std.Err. z P>|z| [0.025 0.975] ---------------------------------------------------------------- gre 0.0023 0.0011 2.0699 0.0385 0.0001 0.0044 gpa 0.8040 0.3318 2.4231 0.0154 0.1537 1.4544 prestige_2 -0.6754 0.3165 -2.1342 0.0328 -1.2958 -0.0551 prestige_3 -1.3402 0.3453 -3.8812 0.0001 -2.0170 -0.6634 prestige_4 -1.5515 0.4178 -3.7131 0.0002 -2.3704 -0.7325 intercept -3.9900 1.1400 -3.5001 0.0005 -6.2242 -1.7557 ==============================================================
Đối tượng result cũng cho phép tách biệt và kiểm tra các phần của output mô hình.
# Xem khoảng tin cậy của từng hệ số print(result.conf_int())
Kết quả
0 1 gre 0.000120 0.004409 gpa 0.153684 1.454391 prestige_2 -1.295751 -0.055135 prestige_3 -2.016992 -0.663416 prestige_4 -2.370399 -0.732529 intercept -6.224242 -1.755716
Từ output trên, thấy mối quan hệ nghịch đảo giữa xác suất được admitted và prestige của trường đại học ứng viên.
Vậy xác suất ứng viên được chấp nhận vào chương trình sau đại học cao hơn cho sinh viên tốt nghiệp trường đại học hạng nhất (prestige_1=True) so với trường hạng thấp (prestige_3 hoặc prestige_4).