
Hồi quy tuyến tính là một trong những công cụ đơn giản, tiêu chuẩn trong machine learning để chỉ ra mối quan hệ dương hoặc âm giữa hai biến.
Hồi quy tuyến tính là một trong những công cụ tốt cho phân tích dự báo nhanh. Trong phần này, ta sẽ dùng package pandas của Python để tải dữ liệu, sau đó ước lượng, diễn giải và trực quan hóa mô hình hồi quy tuyến tính.
Trước khi đi sâu, hãy thảo luận hồi quy (regression) là gì?
Hồi quy là gì?
Hồi quy là kỹ thuật mô hình hóa dự báo giúp tạo mối quan hệ giữa biến phụ thuộc (dependent) và biến độc lập (independent).
Các loại hồi quy
- Hồi quy tuyến tính (Linear Regression)
- Hồi quy logistic (Logistic Regression)
- Hồi quy đa thức (Polynomial Regression)
- Hồi quy tiến triển (Stepwise Regression)
Hồi quy tuyến tính dùng ở đâu?
- Đánh giá xu hướng và ước lượng doanh số
- Phân tích tác động của thay đổi giá
- Đánh giá rủi ro
Các bước xây dựng mô hình hồi quy tuyến tính
Thiết lập và tải dataset cùng Jupyter (dùng cho hướng dẫn này, có thể dùng IDE khác như Anaconda).
Import package cần thiết và dataset.
Với dataset đã tải, khám phá dữ liệu.
Thực hiện hồi quy tuyến tính với dataset.
Khám phá mối quan hệ giữa biến và Thời gian trong ngày (Time of day).
Tóm tắt.
Thiết lập (Setup)
Tải dataset từ link dưới:
https://en.openei.org/datasets/dataset/649aa6d3-2832-4978-bc6e-fa563568398e/resource/b710e97d-29c9-4ca5-8137-63b7cf447317/download/building1retail.csv
Dataset này dùng để mô hình hóa công suất tòa nhà dùng Nhiệt độ không khí ngoài trời (OAT) làm biến giải thích.
Lưu file csv cùng thư mục với Jupyter hoặc IDE.
Import thư viện cần thiết và dataset
Import thư viện cần thiết và đọc dataset bằng pandas.
# Importing Necessary Libraries import pandas as pd #Required for numerical functions import numpy as np from scipy import stats from datetime import datetime from sklearn import preprocessing from sklearn.model_selection import KFold from sklearn.linear_model import LinearRegression #For plotting the graph import matplotlib.pyplot as plt %matplotlib inline # Reading Data df = pd.read_csv('building1retail.csv', index_col=[0], date_parser=lambda x: datetime.strptime(x, "%m/%d/%Y %H:%M")) df.head() Kết quả
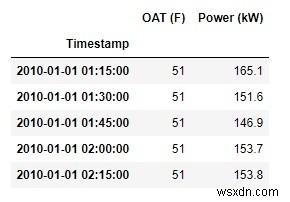
Khám phá Dataset
Trực quan hóa dataset bằng pandas.
df.plot(figsize=(22,6))
Kết quả
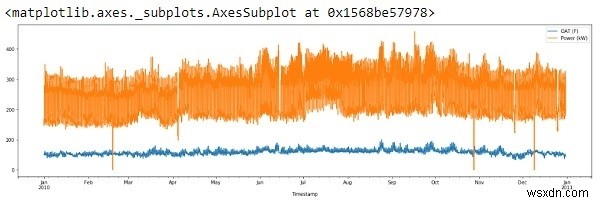
Trục x hiển thị dữ liệu từ Jan2010 – Jan2011.
Từ kết quả trên, nhận thấy hai điều bất thường:
Không có dữ liệu thiếu (missing data). Kiểm tra bằng:
df.isnull().values.any()
Kết quả
False
Kết quả False cho thấy không có giá trị null trong dataframe.
Có vẻ có bất thường (outliers) trong dữ liệu (các đọc giảm mạnh xuống).
Outliers thường do lỗi thực nghiệm hoặc giá trị thật. Dù trường hợp nào, ta sẽ loại bỏ vì chúng ảnh hưởng nghiêm trọng đến độ dốc của đường hồi quy.
Trước khi loại outliers, kiểm tra phân bố dữ liệu:
df.hist()
Kết quả
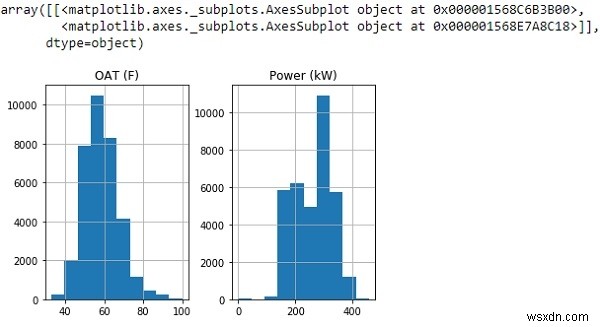
Từ histogram, dữ liệu tuân theo phân phối chuẩn (normal distribution) gần đúng.
Loại bỏ tất cả giá trị lớn hơn 3 độ lệch chuẩn từ trung bình và vẽ dataframe mới.
std_dev = 3 df = df[(np.abs(stats.zscore(df)) < float(std_dev)).all(axis=1)] df.plot(figsize=(22, 6))
Kết quả
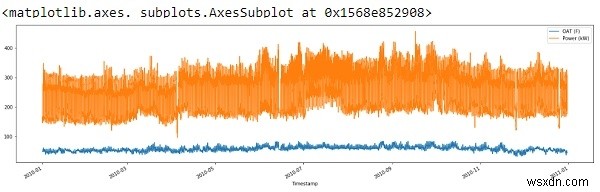
Đã loại bỏ spikes phần nào và làm sạch dữ liệu.
Xác thực mối quan hệ tuyến tính
Để tìm xem có quan hệ tuyến tính giữa OAT và Power, vẽ scatter plot đơn giản:
plt.scatter(df['OAT (F)'], df['Power (kW)'])
Kết quả
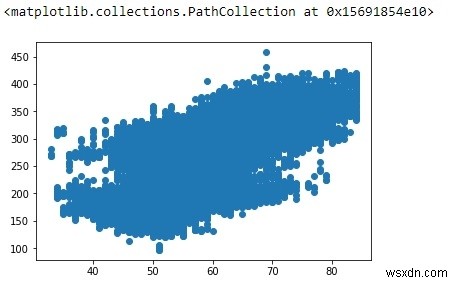
Hồi quy tuyến tính
Để chạy mô hình và đánh giá hiệu năng, dùng module Scikit-learn, k-fold cross validation (k=3) để đánh giá mô hình.
X = pd.DataFrame(df['OAT (F)']) y = pd.DataFrame(df['Power (kW)']) model = LinearRegression() scores = [] kfold = KFold(n_splits=3, shuffle=True, random_state=42) for i, (train, test) in enumerate(kfold.split(X, y)): model.fit(X.iloc[train,:], y.iloc[train,:]) score = model.score(X.iloc[test,:], y.iloc[test,:]) scores.append(score) print(scores)
Kết quả
[0.38768927735902703, 0.3852220878090444, 0.38451654781487116]
Chương trình trên: model = LinearRegression() tạo mô hình hồi quy tuyến tính, vòng for chia dataset thành 3 fold. Bên trong vòng lặp, fit dữ liệu và đánh giá hiệu năng bằng cách thêm score vào list.
Tuy nhiên kết quả chưa tốt, có thể cải thiện.
Thời gian trong ngày (Time of Day)
Biến công suất (Power) phụ thuộc mạnh vào thời gian trong ngày. Hãy dùng thông tin này tích hợp vào mô hình hồi quy bằng one-hot encoding.
model = LinearRegression() scores = [] kfold = KFold(n_splits=3, shuffle=True, random_state=42) for i, (train, test) in enumerate(kfold.split(X, y)): model.fit(X.iloc[train,:], y.iloc[train,:]) scores.append(model.score(X.iloc[test,:], y.iloc[test,:])) print(scores)
Kết quả
[0.8074246958895391, 0.8139449185141592, 0.8111379602960773]
Đây là sự khác biệt lớn trong mô hình.
Tóm tắt
Trong phần này, ta học cơ bản khám phá dataset và chuẩn bị để fit vào mô hình hồi quy. Đánh giá hiệu năng, phát hiện điểm yếu và khắc phục.