
Trong bài viết này, chúng ta sẽ tìm hiểu về kỹ thuật web scraping sử dụng module lxml có sẵn trong Python.
Web Scraping là gì?
Web scraping được dùng để lấy dữ liệu từ một trang web nhờ sự trợ giúp của một crawler/scanner. Web scraping rất tiện lợi để trích xuất dữ liệu từ trang web không cung cấp chức năng API. Trong Python, web scraping có thể thực hiện nhờ các module như Beautiful Soup, Scrapy và lxml.
Ở đây chúng ta sẽ thảo luận về web scraping sử dụng module lxml.
Để làm điều đó, trước tiên chúng ta cần cài đặt lxml.
Gõ trong terminal hoặc command prompt:
>>> pip install lxml
Ở đây xpath được dùng để truy cập dữ liệu.
Trong bài viết này, chúng ta sẽ trích xuất dữ liệu từ trang web Steam chứa thông tin về các game khác nhau.
https://store.steampowered.com/genre/Free%20to%20Play/
Trên trang, chúng ta sẽ cố gắng trích xuất thông tin từ phần "Popular New Releases". Ở đây chúng ta sẽ trích xuất tên, giá, thẻ liên quan & nền tảng đích.
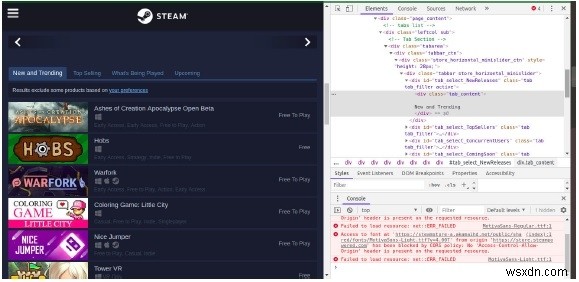
Trên trang, hãy xem mã HTML của tab new releases bằng cách sử dụng tính năng inspect element trong Chrome. Ở đây chúng ta sẽ biết thẻ nào đang lưu trữ thông tin cần thiết.
Ở trang web này; mọi phần tử danh sách được đóng gói trong thẻ div id=tab_content, thẻ này lại được đóng gói tiếp trong
một thẻ div id=tab_select_newreleases
Bây giờ hãy xem triển khai.