
Mục lục
- Trang đơn vs. Phân trang
- Mechanize
- Agent
- Page
- Phương thức Nokogiri
- Links
- Click
- Forms
Trang đơn vs. Phân trang
Cho đến nay chúng ta đã dành thời gian tìm hiểu cách thu thập dữ liệu từ một trang đơn lẻ bằng Nokogiri. Đó là nền tảng tốt để tiến xa hơn và học cách trích xuất nội dung từ nhiều trang.
Vấn đề chúng ta giải quyết là lấy nội dung từ hơn 140 tập podcast – lượng dữ liệu lớn hơn nhiều so với khả năng chứa của một trang web đơn lẻ. Chúng ta phải làm việc với phân trang và tìm ra cách theo dõi nội dung sâu hơn.
Đây chính là lúc Nokogiri dừng lại và gem Mechanize phát huy tác dụng.
Mechanize
Mechanize là công cụ mạnh mẽ khác cung cấp nhiều tính năng hữu ích. Nó cho phép tự động hóa tương tác với các trang web cần trích xuất dữ liệu. Về mặt này, nó nhắc nhớ một chút đến chức năng bạn có thể biết từ testing với Capybara.
Đừng hiểu lầm, chơi với Nokogiri trên một trang đơn lẻ đã tuyệt vời, nhưng cho các tác vụ trích xuất dữ liệu phức tạp hơn, chúng ta cần thêm "mã lực". Chúng ta có thể thu thập dữ liệu qua bao nhiêu trang tùy ý và tương tác với các phần tử của chúng – mô phỏng và tự động hóa hành vi con người. Rất mạnh mẽ!
Gem này cho phép bạn theo dõi liên kết, điền các trường form và gửi dữ liệu – kể cả xử lý cookie cũng nằm trong khả năng. Điều đó nghĩa là bạn cũng có thể mô phỏng đăng nhập của người dùng vào phiên riêng tư và lấy nội dung từ trang web chỉ bạn có quyền truy cập.
Bạn điền thông tin đăng nhập và chỉ dẫn Mechanize cách theo dõi. Vì có thể click liên kết và submit form, hầu như không có gì bạn không thể làm với công cụ này. Nó có mối quan hệ mật thiết với Nokogiri và phụ thuộc vào nó. Aaron Patterson lại là một trong những tác giả của gem tuyệt vời này.
Khởi tạo Mechanize Agent
Trước khi bắt đầu mechanize, chúng ta cần khởi tạo một Mechanize agent.
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
Đối tượng agent này sẽ được dùng để lấy trang, tương tự như chúng ta đã làm với Nokogiri.
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
Ở đây Mechanize agent lấy trang podcast và các cookie của nó.
Trích xuất nội dung trang
Bây giờ chúng ta có một trang sẵn sàng cho việc trích xuất. Trước khi làm điều đó, tôi khuyên nên nhìn "bên trong" bằng phương thức inspect.
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
puts page.inspect
Đầu ra khá chi tiết. Hãy tự xem cấu trúc của đối tượng Mechanize::Page. Tại đây bạn có thể thấy tất cả các thuộc tính của trang đó.
Đối với tôi, đây là đối tượng rất tiện lợi để "cắt lát" dữ liệu bạn muốn trích xuất.
Đầu ra
#<Mechanize::Page {url #https://betweenscreens.fm/>} {meta_refresh} {title "Between | Screens "} {iframes #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/290328784&color=ff0000&auto...> #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/290126141&color=ff0000&auto...> #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/289018386&color=ff0000&auto...> #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/287425105&color=ff0000&auto...> #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/287105342&color=ff0000&auto...> #<Mechanize::Page::Frame nil "https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/221003494&color=ff0000&auto...> #<Mechanize::Page::Frame nil "">https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/218101809&color=ff0000&auto...} {frames} {links #<Mechanize::Page::Link "Logo cube" "/"> #https://github.com/vis-kid/betweenscreens"> #<Mechanize::Page::Link "about" "pages/about/"> #<Mechanize::Page::Link "design" "design/"> #<Mechanize::Page::Link "code" "code/"> #<Mechanize::Page::Link "Randy J. Hunt" "episodes/144/"> #<Mechanize::Page::Link "Jason Long" "episodes/143/"> #<Mechanize::Page::Link "David Heinemeier Hansson" "episodes/142/"> #<Mechanize::Page::Link "Zach Holman" "episodes/141/"> #<Mechanize::Page::Link "Joel Glovier" "episodes/140/"> #<Mechanize::Page::Link "João Ferreira" "episodes/139/"> #<Mechanize::Page::Link "Corwin Harrell" "episodes/138/"> #<Mechanize::Page::Link "Older Stuff »" "page/2/"> #<Mechanize::Page::Link "Exercise" "/tags/exercise/"> #<Mechanize::Page::Link "Company benefits" "/tags/company-benefits/"> #<Mechanize::Page::Link "Tmux" "/tags/tmux/"> #<Mechanize::Page::Link "FileTask" "/tags/filetask/"> #<Mechanize::Page::Link "Decision making" "/tags/decision-making/"> #<Mechanize::Page::Link "Favorite feature" "/tags/favorite-feature/"> #<Mechanize::Page::Link "Working out" "/tags/working-out/"> #<Mechanize::Page::Link "Scott Savarie" "/tags/scott-savarie/"> #<Mechanize::Page::Link "Titles" "/tags/titles/"> #<Mechanize::Page::Link "Erik Spiekermann" "/tags/erik-spiekermann/"> #<Mechanize::Page::Link "Newbie mistakes" "/tags/newbie-mistakes/"> #<Mechanize::Page::Link "Playbook" "/tags/playbook/"> #<Mechanize::Page::Link "Delegation" "/tags/delegation/"> #<Mechanize::Page::Link "Heat maps" "/tags/heat-maps/"> #<Mechanize::Page::Link "Europe" "/tags/europe/"> #<Mechanize::Page::Link "Sizing type" "/tags/sizing-type/"> #<Mechanize::Page::Link "Focus" "/tags/focus/"> #<Mechanize::Page::Link "Virtual assistants" "/tags/virtual-assistants/"> #<Mechanize::Page::Link "Writing" "/tags/writing/"> #<Mechanize::Page::Link "Hacking" "/tags/hacking/"> #<Mechanize::Page::Link "Joel Glovier" "/tags/joel-glovier/"> #<Mechanize::Page::Link "Corwin Harrell" "/tags/corwin-harrell/"> #<Mechanize::Page::Link "Mario C. Delgado" "/tags/mario-c-delgado/"> #<Mechanize::Page::Link "Tom Dale" "/tags/tom-dale/"> #<Mechanize::Page::Link "Obie Fernandez" "/tags/obie-fernandez/"> #<Mechanize::Page::Link "Chad Pytel" "/tags/chad-pytel/"> #<Mechanize::Page::Link "Zach Holman" "/tags/zach-holman/"> #<Mechanize::Page::Link "Max Luster" "/tags/max-luster/"> #<Mechanize::Page::Link "Kyle Fiedler" "/tags/kyle-fiedler/"> #<Mechanize::Page::Link "Roberto Machado" "/tags/roberto-machado/">} {forms}>
Nếu muốn xem chính trang HTML, bạn có thể dùng phương thức body hoặc content.
some_scraper.rb
... print page.body ...
Đầu ra
<!doctype html> <html> <head> <meta charset="utf-8" /> <meta http-equiv='X-UA-Compatible' content='IE=edge;chrome=1' /> <meta content="IE=edge,chrome=1" http-equiv="X-UA-Compatible"> <meta name="viewport" content="initial-scale=1"> <title>Between | Screens </title> <link rel="alternate" type="application/atom+xml" title="Atom Feed" href="/feed.xml" /> <link href="stylesheets/all-11b45acc.css" rel="stylesheet" /> <script src="javascripts/all-4c20da82.js"></script> </head> <body> <header> <div id="logo"> <a href="/"><img src="images/Between_Screens_Logo_Cube_Up-539d6997.svg" alt="Logo cube" /></a> </div> <nav class="navigation"> <ul class="nav-list"> fork">https://github.com/vis-kid/betweenscreens">fork! <li><a href="pages/about/">about</a></li> <li><a href="design/">design</a></li> <li><a href="code/">code</a></li> </ul> </nav> </header> <div id="main" role="main"> <div class='posts'> <ul> <li> <article class="index-article"> <span class='post-date'>Oct 27 | 2016</span><h2 class='post-title'><a href="episodes/144/">Randy J. Hunt</a></h2> <h3 class='topic-list'>Organizing teams | Diversity | Desires | Pizza rule | Effective over clever | Novel solutions | Straightforwardness | Research | Coffeeshop test | Small changes | Reducing errors | Granular diffs</h3> <div class='soundcloud-player-small'> <iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/290328784&color=ff0000&...> </div> </article> </li> <li> <article class="index-article"> <span class='post-date'>Oct 25 | 2016</span><h2 class='post-title'><a href="episodes/143/">Jason Long</a></h2> <h3 class='topic-list'>Open source | Empathy | Lower barriers | Learning tool | Design contributions | Git website | Branding | GitHub | Neovim | Tmux | Design love | Knowing audiences | Showing work | Dribbble | Progressions | Ideas</h3> <div class='soundcloud-player-small'> <iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/290126141&color=ff0000&...> </div> </article> </li> <li> <article class="index-article"> <span class='post-date'>Oct 18 | 2016</span><h2 class='post-title'><a href="episodes/142/">David Heinemeier Hansson</a></h2> <h3 class='topic-list'>Rails community | Tone | Technical disagreements | Community policing | Ungratefulness | No assholes allowed | Basecamp | Open source persona | Aspirations | Guarding motivations | Dealing with audiences | Pressure | Honesty | Diverse opinions | Small talk</h3> <div class='soundcloud-player-small'> <iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/289018386&color=ff0000&...> </div> </article> </li> <li> <article class="index-article"> <span class='post-date'>Oct 12 | 2016</span><h2 class='post-title'><a href="episodes/141/">Zach Holman</a></h2> <h3 class='topic-list'>Getting Fired | Taboo | Transparency | Different Perspectives | Timing | Growth Stages | Employment & Dating | Managers | At-will Employment | Tech Industry | Europe | Low hanging Fruits | Performance Improvement Plans | Meeting Goals | Surprise Firings | Firing Fast | Mistakes | Company Culture | Communication</h3> <div class='soundcloud-player-small'> <iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/287425105&color=ff0000&...> </div> </article> </li> <li> <article class="index-article"> <span class='post-date'>Oct 10 | 2016</span><h2 class='post-title'><a href="episodes/140/">Joel Glovier</a></h2> <h3 class='topic-list'>Digital Product Design | Product Design @ GitHub | Loving Design | Order & Chaos | Drawing | Web Design | HospitalRun | Diversity | Startup Culture | Improving Lives | CURE International | Ember | Offline First | Hospital Information System | Designers & Open Source</h3> <div class='soundcloud-player-small'> <iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/287105342&color=ff0000&...> </div> </article> </li> <li> <article class="index-article"> <span class='post-date'>Aug 26 | 2015</span><h2 class='post-title'><a href="episodes/139/">João Ferreira</a></h2> <h3 class='topic-list'>Masters @ Work | Subvisual | Deadlines | Design personality | Design problems | Team | Pushing envelopes | Delightful experiences | Perfecting details | Company values</h3> <div class='soundcloud-player-small'> <iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/221003494&color=ff0000&...> </div> </article> </li> <li> <article class="index-article"> <span class='post-date'>Aug 06 | 2015</span><h2 class='post-title'><a href="episodes/138/">Corwin Harrell</a></h2> <h3 class='topic-list'>Q&A | 01 | University | Graphic design | Design setup | Sublime | Atom | thoughtbot | Working location | Collaboration & pairing | Vim advocates | Daily routine | Standups | Clients | Coffee walks | Investment Fridays |</h3> <div class='soundcloud-player-small'> <iframe width="100%" height="166" scrolling="no" frameborder="no" src="https://w.soundcloud.com/player/?url=https%3A//api.soundcloud.com/tracks/218101809&color=ff0000&...> </div> </article> </li> </ul> </div> <section> <div class='pagination-link'><a href="page/2/">Older Stuff »</a></div> </section> </div> <footer> <div class='footer-tags'> <h3>Random Tags</h3> <ul class='random-tag-list'> <li><a href="/tags/exercise/">Exercise</a></li> <li><a href="/tags/company-benefits/">Company benefits</a></li> <li><a href="/tags/tmux/">Tmux</a></li> <li><a href="/tags/filetask/">FileTask</a></li> <li><a href="/tags/decision-making/">Decision making</a></li> <li><a href="/tags/favorite-feature/">Favorite feature</a></li> <li><a href="/tags/working-out/">Working out</a></li> <li><a href="/tags/scott-savarie/">Scott Savarie</a></li> <li><a href="/tags/titles/">Titles</a></li> <li><a href="/tags/erik-spiekermann/">Erik Spiekermann</a></li> <li><a href="/tags/newbie-mistakes/">Newbie mistakes</a></li> <li><a href="/tags/playbook/">Playbook</a></li> <li><a href="/tags/delegation/">Delegation</a></li> <li><a href="/tags/heat-maps/">Heat maps</a></li> <li><a href="/tags/europe/">Europe</a></li> <li><a href="/tags/sizing-type/">Sizing type</a></li> <li><a href="/tags/focus/">Focus</a></li> <li><a href="/tags/virtual-assistants/">Virtual assistants</a></li> <li><a href="/tags/writing/">Writing</a></li> <li><a href="/tags/hacking/">Hacking</a></li> </ul> </div> <div class='recent-posts'> <h3>Random Interviewees</h3> <ul> <li><a href="/tags/joel-glovier/">Joel Glovier</a></li> <li><a href="/tags/corwin-harrell/">Corwin Harrell</a></li> <li><a href="/tags/mario-c-delgado/">Mario C. Delgado</a></li> <li><a href="/tags/tom-dale/">Tom Dale</a></li> <li><a href="/tags/obie-fernandez/">Obie Fernandez</a></li> <li><a href="/tags/chad-pytel/">Chad Pytel</a></li> <li><a href="/tags/zach-holman/">Zach Holman</a></li> <li><a href="/tags/max-luster/">Max Luster</a></li> <li><a href="/tags/kyle-fiedler/">Kyle Fiedler</a></li> <li><a href="/tags/roberto-machado/">Roberto Machado</a></li> </ul> </div> </footer> </body> </html>
Vì trang podcast này chỉ có số lượng yếu tố nhỏ, đây là Mechanize::Page trả về từ github.com – nó có nhiều loại nội dung hơn để tham khảo. Tôi nghĩ điều này quan trọng để nắm cảm giác.
Đầu ra github.com
#<Mechanize::Page {url #https://github.com/>} {meta_refresh} {title "How people build software · GitHub"} {iframes} {frames} {links #<Mechanize::Page::Link "Skip to content" "#start-of-content"> #https://github.com/"> #<Mechanize::Page::Link "\n Personal\n" "/personal"> #<Mechanize::Page::Link "\n Open source\n" "/open-source"> #<Mechanize::Page::Link "\n Business\n" "/business"> #<Mechanize::Page::Link "\n Explore\n" "/explore"> #<Mechanize::Page::Link "Sign up" "/join?source=header-home"> #<Mechanize::Page::Link "Sign in" "/login"> #<Mechanize::Page::Link "Pricing" "/pricing"> #<Mechanize::Page::Link "Blog" "/blog"> #https://help.github.com"> #https://github.com/search"> #https://help.github.com/terms"> #https://help.github.com/privacy"> #<Mechanize::Page::Link "Sign up for GitHub" "/join?source=button-home"> #<Mechanize::Page::Link "\n \n \n \n \n A whole new Universe\n \n Learn about the exciting features and announcements revealed at this year's GitHub Universe conference.\n \n \n " "/universe-2016"> #<Mechanize::Page::Link "Individuals " "/personal"> #<Mechanize::Page::Link "Communities " "/open-source"> #<Mechanize::Page::Link "Businesses " "/business"> #<Mechanize::Page::Link "NASA" "//github.com/nasa"> #<Mechanize::Page::Link "Sign up for GitHub" "/join?source=button-home"> #https://github.com/contact"> #https://developer.github.com"> #https://training.github.com"> #https://shop.github.com"> #https://github.com/blog"> #https://github.com/about"> #https://github.com"> #https://github.com/site/terms"> #https://github.com/site/privacy"> #https://github.com/security"> #https://status.github.com/"> #https://help.github.com"> #<Mechanize::Page::Link "Reload" ""> #<Mechanize::Page::Link "Reload" "">} {forms #<Mechanize::Form {name nil} {method "GET"} {action "/search"} {fields [hidden:0x3feb90f8297c type: hidden name: utf8 value: ✓] [text:0x3feb90f827d8 type: text name: q value: ]} {radiobuttons} {checkboxes} {file_uploads} {buttons}> #<Mechanize::Form {name nil} {method "POST"} {action "/join"} {fields [hidden:0x3feb90f7be38 type: hidden name: utf8 value: ✓] [hidden:0x3feb90f7bbb8 type: hidden name: authenticity_token value: vjRATKj7smXreq6Lt02r+MzW+ewWoi+fRzQXPedFAlOZgwzxQ0dZnChirhDfd7vyWZZZBO+ZFydLNedjIEDsrQ==] [text:0x3feb90f7b9d8 type: text name: user[login] value: ] [text:0x3feb90f7b7f8 type: text name: user[email] value: ] [field:0x3feb90f7b654 type: password name: user[password] value: ] [hidden:0x3feb90f7b474 type: hidden name: source value: form-home]} {radiobuttons} {checkboxes} {file_uploads} {buttons [button:0x3feb90f7a038 type: submit name: value: ]}>}>
Quay lại podcast, bạn cũng có thể xem các thứ như encoding, mã phản hồi HTTP, URI, hoặc header phản hồi.
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
puts 'Encodings'
puts page.encodings
puts 'Repsonse Headers'
puts page.response
puts 'HTTP response code'
puts page.code
puts 'URI'
puts page.uri
Đầu ra
Encodings EUC-JP utf-8 utf-8 Repsonse Headers {"server"=>"GitHub.com", "date"=>"Sat, 29 Oct 2016 17:56:00 GMT", "content-type"=>"text/html; charset=utf-8", "transfer-encoding"=>"chunked", "last-modified"=>"Fri, 28 Oct 2016 01:48:56 GMT", "access-control-allow-origin"=>"*", "expires"=>"Sat, 29 Oct 2016 18:06:00 GMT", "cache-control"=>"max-age=600", "content-encoding"=>"gzip", "x-github-request-id"=>"501C936D:C723:1631523C:5814E2B0"} HTTP response code 200 URI https://betweenscreens.fm/
Còn nhiều thứ hơn nữa nếu bạn muốn đào sâu hơn. Tôi dừng ở đây.
Phương thức Nokogiri
atsearch
Mechanize sử dụng Nokogiri để thu thập dữ liệu từ các trang. Bạn có thể áp dụng những gì đã học về Nokogiri ở bài trước và dùng trên các trang Mechanize. Nghĩa là bạn dùng Mechanize để điều hướng trang và dùng phương thức Nokogiri cho nhu cầu scraping.
Ví dụ, nếu muốn tìm một đối tượng đơn lẻ, dùng at, trong khi search trả về tất cả đối tượng khớp với selector trên trang cụ thể. Tóm lại, các phương thức này hoạt động cả trên đối tượng tài liệu Nokogiri và đối tượng trang Mechanize.
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
first_title = page.at('h2.post-title')
all_titles = page.search('h2.post-title')
all_titles.each do |title|
  puts title
end
puts " * "*33
puts first_title
Đầu ra
<h2 class="post-title"><a href="episodes/144/">Randy J. Hunt</a></h2> <h2 class="post-title"><a href="episodes/143/">Jason Long</a></h2> <h2 class="post-title"><a href="episodes/142/">David Heinemeier Hansson</a></h2> <h2 class="post-title"><a href="episodes/141/">Zach Holman</a></h2> <h2 class="post-title"><a href="episodes/140/">Joel Glovier</a></h2> <h2 class="post-title"><a href="episodes/139/">João Ferreira</a></h2> <h2 class="post-title"><a href="episodes/138/">Corwin Harrell</a></h2> * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * * <h2 class="post-title"><a href="episodes/144/">Randy J. Hunt</a></h2>
Links
linkslink_withlinks_with
Chúng ta cũng có thể điều hướng toàn bộ trang web theo ý thích. Có lẽ phần quan trọng nhất của Mechanize là khả năng cho phép bạn "chơi" với các liên kết. Nếu không có tính năng này, bạn có thể chỉ dùng Nokogiri đơn thuần. Hãy xem Mechanize trả về gì khi yêu cầu các liên kết của một trang.
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
puts "#{page.links}"
Đầu ra
[#<Mechanize::Page::Link "Logo cube" "/"> , #https://github.com/vis-kid/betweenscreens"> , #<Mechanize::Page::Link "about" "pages/about/"> , #<Mechanize::Page::Link "design" "design/"> , #<Mechanize::Page::Link "code" "code/"> , #<Mechanize::Page::Link "Randy J. Hunt" "episodes/144/"> , #<Mechanize::Page::Link "Jason Long" "episodes/143/"> , #<Mechanize::Page::Link "David Heinemeier Hansson" "episodes/142/"> #<Mechanize::Page::Link "Zach Holman" "episodes/141/"> , #<Mechanize::Page::Link "Joel Glovier" "episodes/140/"> , #<Mechanize::Page::Link "João Ferreira" "episodes/139/"> , #<Mechanize::Page::Link "Corwin Harrell" "episodes/138/"> , #<Mechanize::Page::Link "Older Stuff »" "page/2/"> , #<Mechanize::Page::Link "Exercise" "/tags/exercise/"> , #<Mechanize::Page::Link "Company benefits" "/tags/company-benefits/"> , #<Mechanize::Page::Link "Tmux" "/tags/tmux/"> , #<Mechanize::Page::Link "FileTask" "/tags/filetask/"> , #<Mechanize::Page::Link "Decision making" "/tags/decision-making/"> , #<Mechanize::Page::Link "Favorite feature" "/tags/favorite-feature/"> , #<Mechanize::Page::Link "Working out" "/tags/working-out/"> , #<Mechanize::Page::Link "Scott Savarie" "/tags/scott-savarie/"> , #<Mechanize::Page::Link "Titles" "/tags/titles/"> , #<Mechanize::Page::Link "Erik Spiekermann" "/tags/erik-spiekermann/"> , #<Mechanize::Page::Link "Newbie mistakes" "/tags/newbie-mistakes/"> , #<Mechanize::Page::Link "Playbook" "/tags/playbook/"> #<Mechanize::Page::Link "Delegation" "/tags/delegation/"> , #<Mechanize::Page::Link "Heat maps" "/tags/heat-maps/"> , #<Mechanize::Page::Link "Europe" "/tags/europe/"> , #<Mechanize::Page::Link "Sizing type" "/tags/sizing-type/"> , #<Mechanize::Page::Link "Focus" "/tags/focus/"> , #<Mechanize::Page::Link "Virtual assistants" "/tags/virtual-assistants/"> , #<Mechanize::Page::Link "Writing" "/tags/writing/"> , #<Mechanize::Page::Link "Hacking" "/tags/hacking/"> , #<Mechanize::Page::Link "Joel Glovier" "/tags/joel-glovier/"> , #<Mechanize::Page::Link "Corwin Harrell" "/tags/corwin-harrell/"> , #<Mechanize::Page::Link "Mario C. Delgado" "/tags/mario-c-delgado/"> , #<Mechanize::Page::Link "Tom Dale" "/tags/tom-dale/"> , #<Mechanize::Page::Link "Obie Fernandez" "/tags/obie-fernandez/"> , #<Mechanize::Page::Link "Chad Pytel" "/tags/chad-pytel/"> , #<Mechanize::Page::Link "Zach Holman" "/tags/zach-holman/"> , #<Mechanize::Page::Link "Max Luster" "/tags/max-luster/"> , #<Mechanize::Page::Link "Kyle Fiedler" "/tags/kyle-fiedler/"> , #<Mechanize::Page::Link "Roberto Machado" "/tags/roberto-machado/"> ]
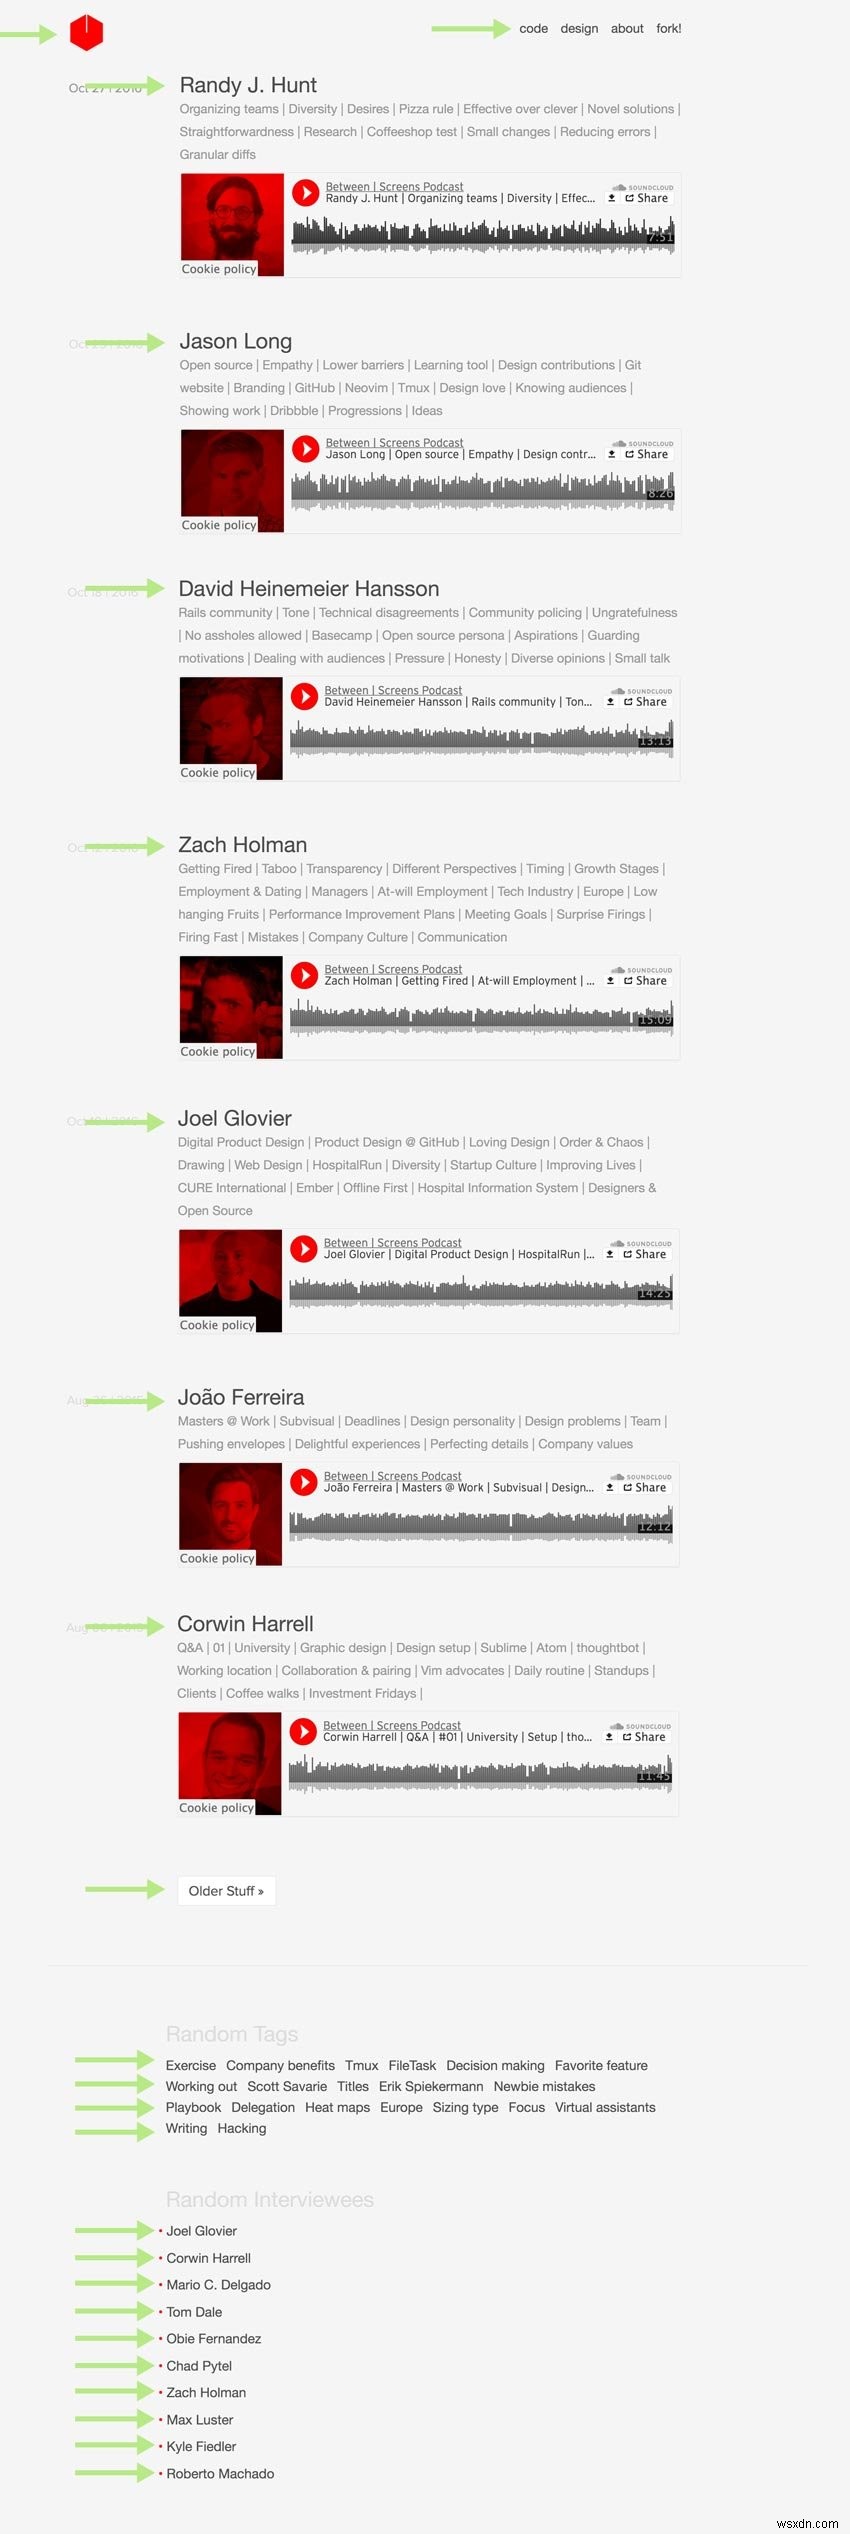
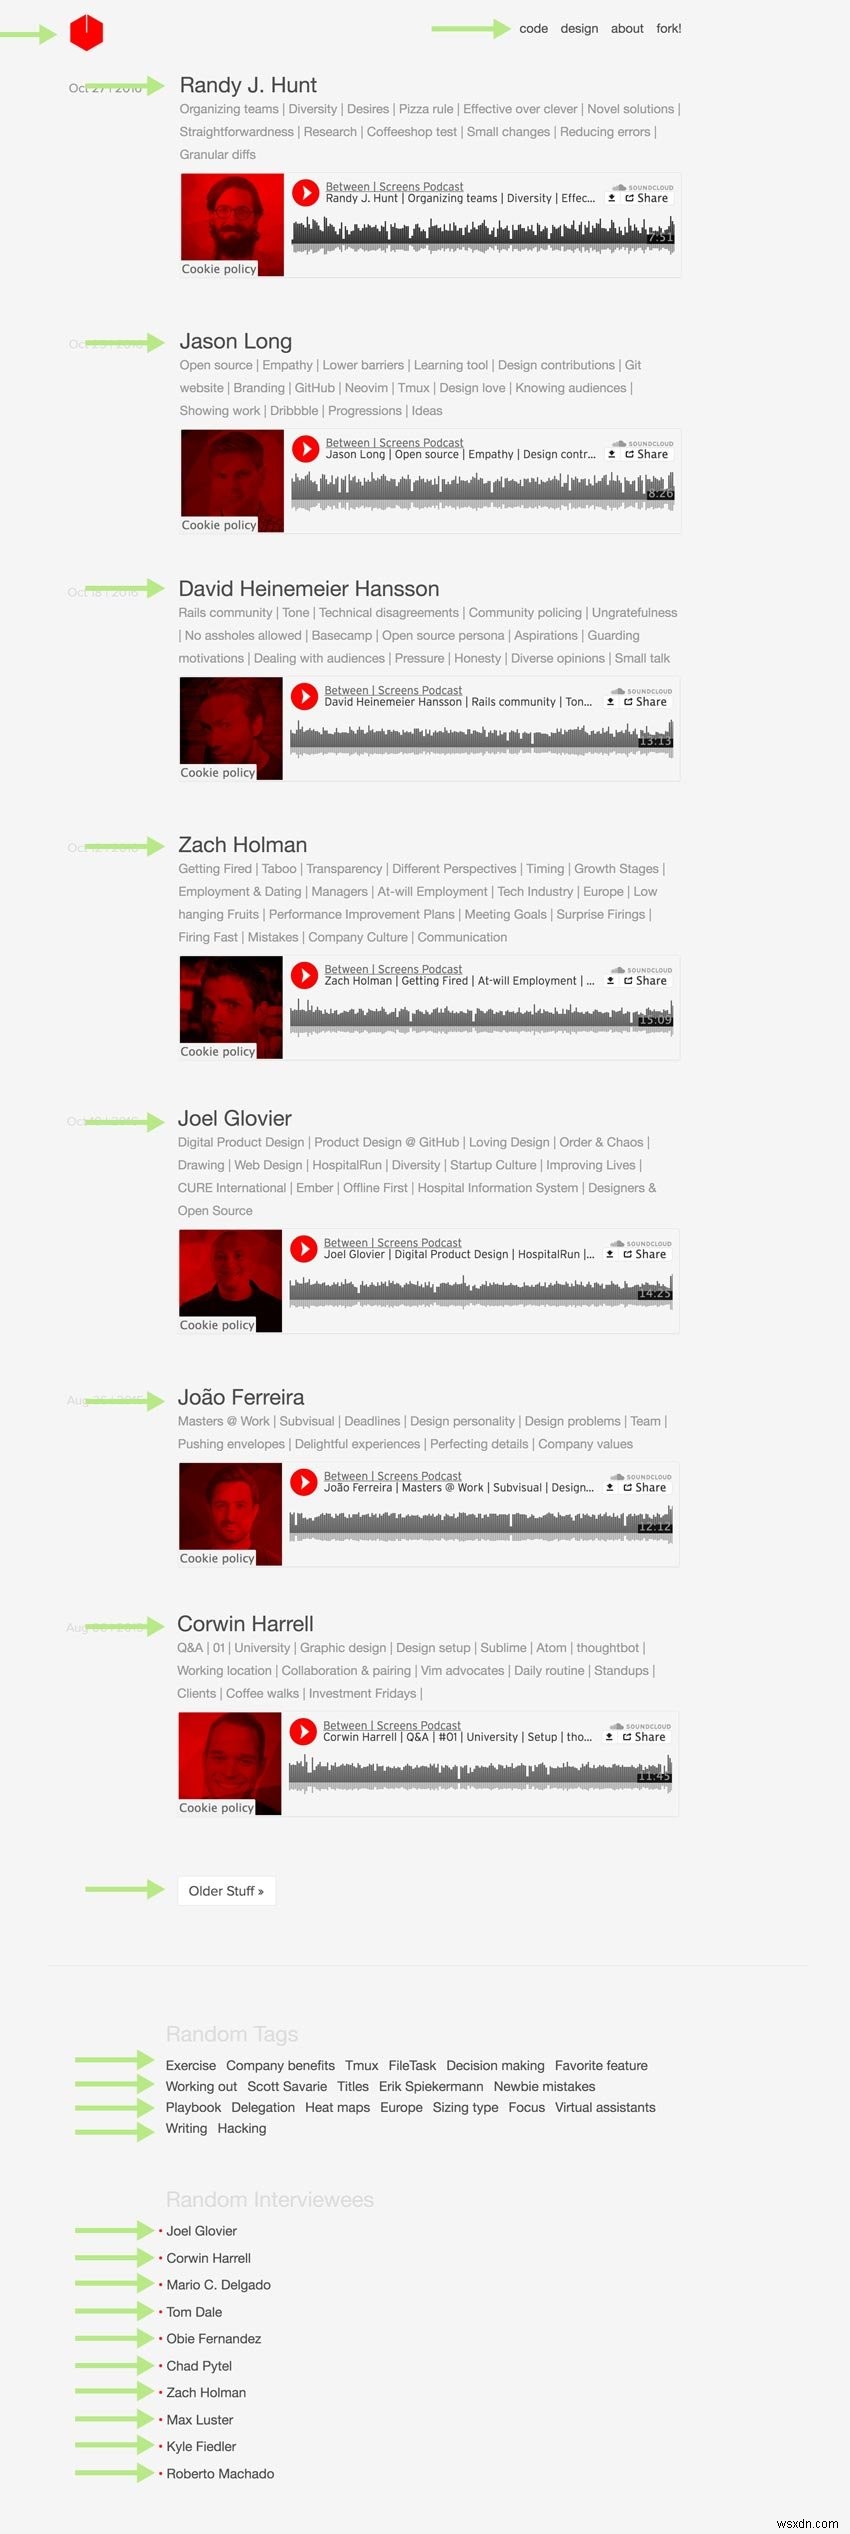
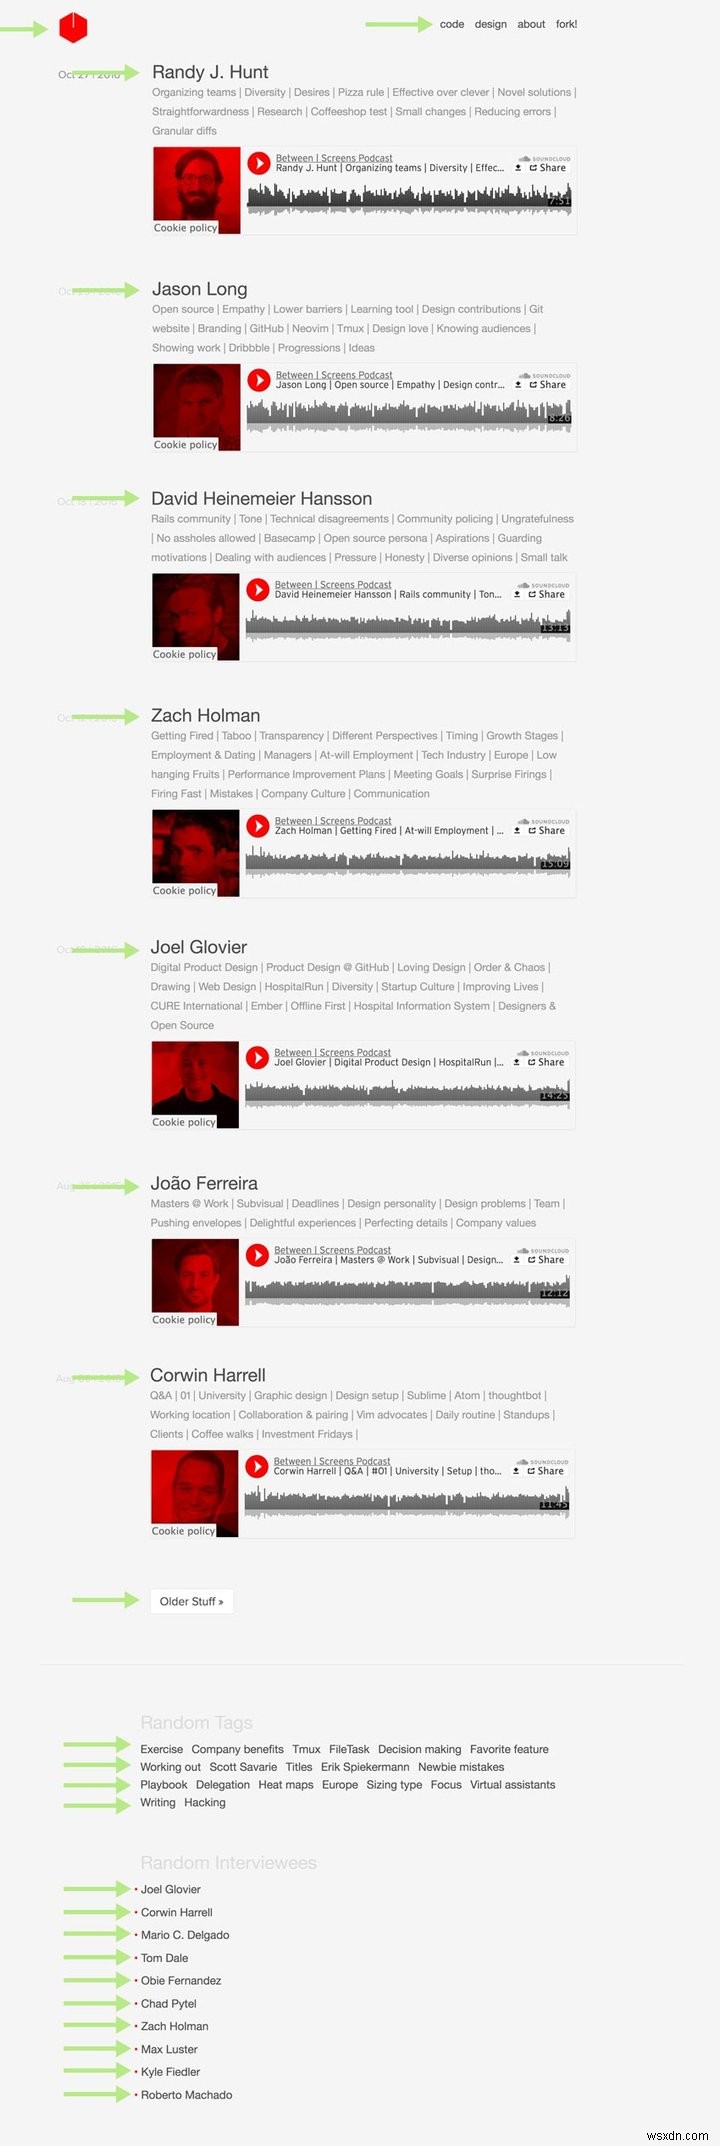
Trời ơi, hãy phân tích xem. Vì chúng ta chưa yêu cầu Mechanize nhìn nơi khác, nên nhận được một mảng liên kết chỉ từ trang đầu tiên đó. Mechanize duyệt trang theo thứ tự giảm dần và trả về danh sách liên kết từ trên xuống dưới. Tôi đã tạo một hình ảnh nhỏ với các mũi tên xanh trỏ đến các liên kết khác nhau trong đầu ra.
Bên cạnh đó, đây đã là kết quả cuối cùng của việc thiết kế lại podcast của tôi. Tôi nghĩ phiên bản này tốt hơn cho mục đích demo. Bạn cũng thấy trước cảm giác kết quả cuối cùng và tại sao tôi cần scraping trang Sinatra cũ.
Ảnh chụp màn hình
Như luôn, chúng ta cũng có thể trích xuất chỉ văn bản từ đó.
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
page.links.each do |link|
  puts link.text
end
Đầu ra
Logo cube fork! about design code Randy J. Hunt Jason Long David Heinemeier Hansson Zach Holman Joel Glovier João Ferreira Corwin Harrell Older Stuff » Exercise Company benefits Tmux FileTask Decision making Favorite feature Working out Scott Savarie Titles Erik Spiekermann Newbie mistakes Playbook Delegation Heat maps Europe Sizing type Focus Virtual assistants Writing Hacking Joel Glovier Corwin Harrell Mario C. Delgado Tom Dale Obie Fernandez Chad Pytel Zach Holman Max Luster Kyle Fiedler Roberto Machado
Lấy tất cả các liên kết một lúc có thể rất hữu ích hoặc đơn giản là rườm rà. May mắn thay, chúng ta có vài công cụ để tinh chỉnh những gì cần thiết.
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
focus_link = agent.page.links.find { |link| link.text == 'Focus' }
puts focus_link
Đầu ra
Focus
Xong! Bây giờ chúng ta đang tiến triển! Chúng ta có thể zoom vào các liên kết cụ thể như vậy. Chúng ta có thể nhắm mục tiêu các liên kết khớp với tiêu chí nhất định – như văn bản của nó, ví dụ – với API đẹp đẽ hơn như links_with hoặc link_with. Ngoài ra, nếu có nhiều liên kết Focus, chúng ta có thể zoom vào một vị trí cụ thể trên trang bằng ngoặc vuông [].
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
focus_link = agent.page.links_with(:text => 'Focus')[2]
puts focus_link
Nếu bạn không quan tâm đến văn bản liên kết mà muốn chính liên kết đó, bạn chỉ cần chỉ định href cụ thể để tìm liên kết đó. Mechanize không cản trở bạn. Thay vì text, bạn cung cấp cho phương thức href.
some_scraper.rb
page = agent.page.link_with(href: '/episodes/95/')
page = agent.page.links_with(href: '/episodes/95/')
Nếu bạn chỉ muốn tìm liên kết đầu tiên với văn bản mong muốn, cũng có thể dùng cú pháp này. Rất tiện lợi và dễ đọc hơn một chút.
some_scraper.rb
focus_links = agent.page.link_with(:text => 'Focus')
Làm sao để theo dõi liên kết đó và xem gì nằm sau Focus? Hãy click nó!
Click
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
focus_links = agent.page.links.find { |link| link.text == 'Focus' }.click.links
puts focus_links
Điều này sẽ cho chúng ta một danh sách liên kết dài khác như trước. Thấy dễ dàng thế nào khi kết hợp .click.links. Mechanize click liên kết cho bạn và theo dõi trang đến đích mới. Vì chúng ta cũng yêu cầu danh sách liên kết, nên sẽ nhận được tất cả liên kết Mechanize tìm thấy trên trang mới đó.
Giả sử tôi có hai liên kết văn bản của cùng một phỏng vấn viên – một liên kết đến tags và một đến tập gần đây – và tôi muốn lấy liên kết từ cả hai trang.
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
podcast_url = "https://betweenscreens.fm/"
page = agent.get(podcast_url)
links = agent.page.links_with(text: "Some interviewee")
links.each do |link|
  puts link.click.links
end
Điều này sẽ cho bạn danh sách liên kết cho cả hai trang. Bạn lặp qua từng liên kết của phỏng vấn viên, và Mechanize theo dõi liên kết được click và thu thập các liên kết nó tìm thấy trên trang mới cho bạn. Dưới đây là vài ví dụ để bạn so sánh các tổ hợp để bắt đầu.
some_scraper.rb
agent.page.links.find { |l| l.text == 'Focus' }
agent.page.links.find { |l| l.text == 'Focus' }.click
agent.page.link_with(text: 'Focus')
agent.page.links_with(text: 'Focus')[0]
agent.page.links_with(text: 'Focus')[1].click
agent.page.links_with(text: 'Focus')[2].click.links
agent.page.link_with(href: '/some-href')
agent.page.link_with(href: '/some-href').click
agent.page.links_with(href: '/some-href')
agent.page.links_with(href: '/some-href').click
Forms
submitfield_withcheckbox_withradiobuttons_withfile_uploads
Hãy xem xét forms!
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
google_url = "https://google.com/"
page = agent.get(google_url)
forms = page.forms
puts forms.inspect
Đầu ra
[#<Mechanize::Form # Attention!! {name "f"} # Attention!! {method "GET"} {action "/search"} {fields [hidden:0x3fea91d2eb08 type: hidden name: ie value: ISO-8859-1] [hidden:0x3fea91d2e964 type: hidden name: hl value: es] [hidden:0x3fea91d2e7e8 type: hidden name: source value: hp] [hidden:0x3fea91d2e5f4 type: hidden name: biw value: ] [hidden:0x3fea91d2e428 type: hidden name: bih value: ] # Attention!! [text:0x3fea91d2e248 type: name: q value: ] # Attention!! [hidden:0x3fea91d2bcb4 type: hidden name: gbv value: 1]} {radiobuttons} {checkboxes} {file_uploads} {buttons [submit:0x3fea91d2e0f4 type: submit name: btnG value: Buscar con Google] [submit:0x3fea91d2be80 type: submit name: btnI value: Voy a tener suerte]}> ]
Vì chúng ta dùng phương thức forms, nên nhận được một mảng – ngay cả khi chỉ có một form được trả về. Bây giờ biết form có tên "f", chúng ta có thể dùng phiên bản số ít form để tập trung vào form đó.
... {name "f"} ...
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
google_url = "https://google.com/"
page = agent.get(google_url)
search_form = page.form('f')
puts search_form.inspect
Sử dụng form('f'), chúng ta chọn form cụ thể muốn làm việc. Kết quả là không nhận được mảng trả về.
Đầu ra
#<Mechanize::Form # Attention!! {name "f"} # Attention!! {method "GET"} {action "/search"} {fields [hidden:0x3ffe9ce85ba4 type: hidden name: ie value: ISO-8859-1] [hidden:0x3ffe9ce859d8 type: hidden name: hl value: es] [hidden:0x3ffe9ce857bc type: hidden name: source value: hp] [hidden:0x3ffe9ce85618 type: hidden name: biw value: ] [hidden:0x3ffe9ce853e8 type: hidden name: bih value: ] # Attention!! [text:0x3ffe9ce851cc type: name: q value: ] # Attention!! [hidden:0x3ffe9ce84bdc type: hidden name: gbv value: 1]} {radiobuttons} {checkboxes} {file_uploads} {buttons [submit:0x3ffe9ce85078 type: submit name: btnG value: Buscar con Google] [submit:0x3ffe9ce84e48 type: submit name: btnI value: Voy a tener suerte]}>
Chúng ta cũng có thể xác định tên trường nhập văn bản (q).
... [text:0x3ffe9ce851cc type: name: q value: ] ...
Chúng ta có thể nhắm mục tiêu nó bằng tên đó và đặt giá trị như thuộc tính Ruby. Chúng ta chỉ cần cung cấp giá trị mới. Bạn thấy từ ví dụ đầu ra trên rằng nó rỗng theo mặc định.
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
google_url = "https://google.com/"
page = agent.get(google_url)
search_form = page.form('f')
search_form.q = 'New Google Search'
puts search_form.inspect
Đầu ra
#<Mechanize::Form {name "f"} {method "GET"} {action "/search"} {fields [hidden:0x3fcb85b6a784 type: hidden name: ie value: ISO-8859-1] [hidden:0x3fcb85b6a57c type: hidden name: hl value: es] [hidden:0x3fcb85b6a3b0 type: hidden name: source value: hp] [hidden:0x3fcb85b6a16c type: hidden name: biw value: ] [hidden:0x3fcb85b67f20 type: hidden name: bih value: ] # Attention!! [text:0x3fcb85b67d18 type: name: q value: New Google Search] # Attention!! [hidden:0x3fcb85b67728 type: hidden name: gbv value: 1]} {radiobuttons} {checkboxes} {file_uploads} {buttons [submit:0x3fcb85b67b9c type: submit name: btnG value: Buscar con Google] [submit:0x3fcb85b67994 type: submit name: btnI value: Voy a tener suerte]}>
Như bạn quan sát, giá trị của trường văn bản đã thay thành New Google Search. Bây giờ chúng ta chỉ cần submit form và thu thập kết quả từ trang Google trả về. Không thể dễ hơn! Hãy tìm kiếm thứ khác!
some_scraper.rb
require 'mechanize'
agent = Mechanize.new
google_url = "https://google.com/"
page = agent.get(google_url)
search_form = page.form('f')
search_form.q = 'GitHub TouchFart'
page = agent.submit(search_form)
pp page.search('h3.r').map(&:text)
Ở đây tôi xác định header kết quả tìm kiếm bằng CSS selector h3.r, map text của nó, và pretty-print kết quả. Không quá khó, phải không? Đó là ví dụ dễ, nhưng hãy nghĩ về vô số khả năng bạn có!
Đầu ra
["GitHub - hungtruong/TouchFart: A fart app for the new Macbook ...", "TouchFart/TouchFart at master · hungtruong/TouchFart · GitHub", "Commits · hungtruong/TouchFart · GitHub", "Projects · hungtruong/TouchFart · GitHub", "Pull Requests · hungtruong/TouchFart · GitHub", "Issues · hungtruong/TouchFart · GitHub", "TouchFart/license.txt at master · hungtruong/TouchFart · GitHub", "Add autoplay attribute to <audio> tag and touchfart (er ... - GitHub", "Find file - File Finder · GitHub", "Fart app for the new Macbook Pro's Touch... #3860 on topic touchfart ..."]
Mechanize có các trường nhập liệu khác nhau để bạn "chơi". Bạn thậm chí có thể upload file!
field_withcheckbox_withradiobuttons_withfile_uploads
Bạn cũng có thể xác định radio button và checkbox theo tên và check chúng với – bạn đoán đúng – check.
some_scraper.rb
form.radiobuttons_with(:name => 'gender')[3].check
form.checkbox_with(:name => 'coder').check
Thẻ option cho phép người dùng chọn một mục từ danh sách thả xuống. Lại nữa, chúng ta nhắm mục tiêu theo tên và chọn số thứ tự option mong muốn.
some_scraper.rb
form.field_with(:name => 'countries').options[22].select
Upload file hoạt động tương tự như nhập văn bản vào form bằng cách đặt giá trị như thuộc tính Ruby. Bạn xác định trường upload và chỉ định đường dẫn file (tên file) muốn chuyển. Nó nghe phức tạp hơn thực tế. Hãy xem!
some_scraper.rb
form.file_uploads.first.file_name = "some-path/some-image.jpg"
Lời kết
Thấy đấy, không có phép màu gì! Bây giờ bạn đã được trang bị tốt để tự khám phá. Chắc chắn còn nhiều thứ để học về Nokogiri và Mechanize, nhưng thay vì dành quá nhiều thời gian cho các khía cạnh không cần thiết, hãy tự thực hành và tra cứu tài liệu khi gặp vấn đề vượt quá phạm vi bài hướng dẫn người mới.
Tôi hy vọng bạn thấy gem này đơn giản đẹp đẽ và mạnh mẽ đến nhường nào. Như chúng ta biết từ văn hóa đại chúng, quyền lực này cũng mang lại trách nhiệm. Hãy sử dụng trong khuôn khổ pháp lý và khi không có API. Bạn có thể không thường xuyên dùng các công cụ này, nhưng chúng cực kỳ hữu ích khi bạn có nhu cầu scraping thực sự.
Như đã hứa, ở bài tiếp theo chúng ta sẽ xem ví dụ thực tế nơi tôi scraping dữ liệu từ trang podcast của mình. Tôi sẽ trích xuất từ trang Sinatra cũ và chuyển sang trang Middleman mới dùng file .markdown cho mỗi tập. Chúng ta sẽ lấy ngày, số tập, tên phỏng vấn viên, tiêu đề, phụ đề, v.v. Hẹn gặp lại!