
Mã nguồn đầy đủ trên GitHub
Một triển khai hoàn chỉnh của ngôn ngữ lập trình Stoffle có sẵn trên GitHub. Triển khai tham khảo này có nhiều chú thích để giúp đọc code dễ dàng hơn. Hãy thoải mái mở issue nếu bạn tìm thấy lỗi hoặc có thắc mắc.
Trong bài viết này, chúng ta sẽ triển khai parser cho Stoffle, một ngôn ngữ lập trình 장난 được xây dựng hoàn toàn bằng Ruby. Bạn có thể đọc thêm về dự án này ở phần đầu tiên của loạt bài.
Việc xây dựng parser từ con số không đã mang lại cho tôi những hiểu lầm và kiến thức bất ngờ. Trải nghiệm này có thể khác nhau tùy từng cá nhân, nhưng tôi tin rằng sau bài viết này, bạn sẽ có hoặc làm sâu thêm kiến thức về ít nhất một trong những điều sau:
- Bạn sẽ bắt đầu nhìn mã nguồn khác đi và dễ dàng nhận ra cấu trúc dạng cây không thể chối cãi của nó;
- Bạn sẽ hiểu sâu hơn về cú pháp đường mật (syntactic sugar) và bắt đầu thấy nó ở khắp mọi nơi, سواء trong Stoffle, Ruby, hay các ngôn ngữ lập trình khác.
Tôi cảm thấy parser là ví dụ hoàn hảo của nguyên lý Pareto. Lượng công việc cần thiết để tạo ra các tính năng bổ sung tuyệt vời, như thông báo lỗi tuyệt vời, rõ ràng lớn hơn và không cân xứng với nỗ lực cần thiết để chạy được các chức năng cơ bản. Chúng ta sẽ tập trung vào những điều cốt lõi và để các cải tiến như một thách thức cho bạn, độc giả thân mến. Chúng ta có thể hoặc không xử lý một số phần bổ sung thú vị hơn trong các bài viết sau của loạt bài này.
Cú pháp đường mật (Syntactic Sugar)
Cú pháp đường mật là thuật ngữ chỉ các cấu trúc khiến ngôn ngữ dễ sử dụng hơn, nhưng việc loại bỏ chúng không làm mất đi chức năng của ngôn ngữ lập trình. Một ví dụ hay là cấu trúc
elsifcủa Ruby. Trong Stoffle, chúng ta không có cấu trúc như vậy, nên để biểu diễn điều tương tự, chúng ta buộc phải fl dài hơn:if some_condition # ... else # oops, không có elsif if another_condition # ... end end
Parser là gì?
Chúng ta bắt đầu từ mã nguồn, một chuỗi ký tự thô. Sau đó, như đã trình bày trong bài trước của loạt bài, lexer gom nhóm các ký tự này thành các cấu trúc dữ liệu hợp lý gọi là token. Tuy nhiên, chúng ta vẫn còn dữ liệu hoàn toàn phẳng, thứ vẫn chưa biểu diễn đúng bản chất lồng nhau của mã nguồn. Như vậy, parser có nhiệm vụ tạo ra một cây từ chuỗi ký tự này. Khi hoàn thành nhiệm vụ, chúng ta sẽ có dữ liệu cuối cùng có thể biểu diễn cách mỗi phần của chương trình lồng ghép và liên quan đến nhau.
Cây do parser tạo ra thường được gọi là cây cú pháp trừu tượng (AST - Abstract Syntax Tree). Như tên gọi, chúng ta xử lý một cấu trúc dữ liệu cây, với gốc đại diện cho chính chương trình và các node con của node chương trình là nhiều biểu thức cấu thành nên chương trình. Từ trừu tượng trong AST ám chỉ khả năng trừu tượng hóa những phần ở các bước trước được thể hiện rõ ràng. Ví dụ tốt là các dấu kết thúc biểu thức (xuống dòng trong trường hợp Stoffle); chúng được xem xét khi xây dựng AST, nhưng chúng ta không cần một loại node cụ thể để đại diện cho dấu kết thúc. Tuy nhiên, nhớ rằng chúng ta đã có một token rõ ràng để đại diện cho dấu kết thúc.
Việc có một hình ảnh minh họa AST ví dụ có hữu ích không? Ý bạn là lệnh! Dưới đây là một chương trình Stoffle đơn giản, chúng ta sẽ parse từng bước sau trong bài viết, và cây cú pháp trừu tượng tương ứng của nó:
fn double: num num * 2 end 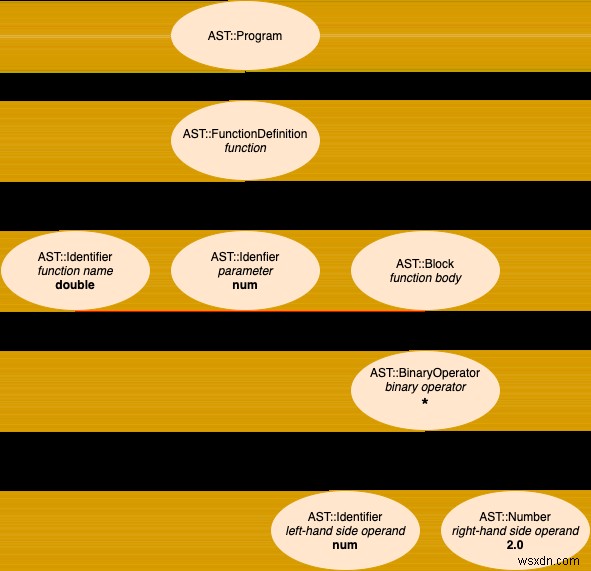
Từ mã nguồn đến AST, ví dụ đầu tiên
Trong phần này, chúng ta sẽ khám phá từng bước cách parser của chúng ta xử lý một chương trình Stoffle rất đơn giản, chỉ gồm một dòng biểu diễn gán biến (ví dụ: gán giá trị cho biến). Đây là mã nguồn, biểu diễn đơn giản của các token do lexer sinh ra (đây là đầu vào cho parser) và cuối cùng là biểu diễn trực quan của AST chúng ta sẽ tạo ra để đại diện cho chương trình:
Mã nguồn
my_var = 1 Token (Đầu ra của Lexer, Đầu vào cho Parser)
[:identifier, :'=', :number] Biểu diễn trực quan của Đầu ra Parser (Một Cây Cú pháp Trừu tượng)
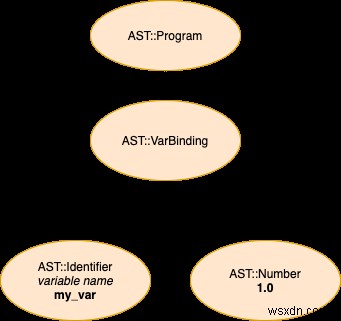
Như bạn có thể tưởng tượng, lõi của parser của chúng ta rất giống với lõi của lexer. Trong trường hợp lexer, chúng ta có một đống ký tự để xử lý. Bây giờ, chúng ta vẫn phải lặp qua một tập hợp, nhưng đối với parser, chúng ta sẽ đi qua danh sách token do lexer sinh ra. Chúng ta có một con trỏ đơn lẻ (@next_p) để theo dõi vị trí trong tập hợp token. Con trỏ này đánh dấu token tiếp theo cần xử lý. Mặc dù chỉ có một con trỏ, chúng ta có nhiều con trỏ "ảo" khác có thể sử dụng khi cần; chúng sẽ xuất hiện khi chúng ta tiến hành triển khai. Một con trỏ "ảo" như vậy là current (cơ bản là token tại @next_p - 1).
#parse là phương thức gọi để biến đổi token thành AST, sẽ có sẵn tại biến instance @ast. Triển khai của #parse rất đơn giản. Chúng ta tiếp tục tiến qua tập hợp bằng cách gọi #consume và di chuyển @next_p cho đến khi không còn token nào để xử lý (tức là while next_p < tokens.length). #parse_expr_recursively có thể trả về một node AST hoặc không trả về gì cả; nhớ rằng chúng ta không cần biểu diễn dấu kết thúc trong AST, ví dụ. Nếu một node được xây dựng trong vòng lặp hiện tại, chúng ta thêm nó vào @ast trước khi tiếp tục. Quan trọng phải nhớ #parse_expr_recursively cũng di chuyển @next_p vì khi tìm thấy token đánh dấu bắt đầu của một cấu trúc cụ thể, chúng ta phải tiến nhiều lần cho đến khi cuối cùng xây dựng được một node đại diện đầy đủ cho thứ đang parse. Hãy tưởng tượng bao nhiêu token phải consume để xây dựng node đại diện cho if.
module Stoffle class Parser attr_accessor :tokens, :ast, :errors # ... def initialize(tokens) @tokens = tokens @ast = AST::Program.new @next_p = 0 @errors = [] end def parse while pending_tokens? consume node = parse_expr_recursively ast << node if node != nil end end # ... end end Trong đoạn code trên, lần đầu tiên chúng ta được giới thiệu với một trong nhiều loại node AST thuộc triển khai parser. Dưới đây là mã nguồn đầy đủ cho loại node AST::Program. Như bạn có thể đoán, đây là gốc của cây, đại diện cho toàn bộ chương trình. Hãy nhìn kỹ các phần thú vị nhất:
- Một chương trình Stoffle bao gồm
@expressions; đây là#childrencủa nodeAST::Program; - Như bạn sẽ thấy lại, mọi loại node đều triển khai phương thức
#==. Hệ quả là dễ dàng so sánh hai node đơn giản, cũng như so sánh toàn bộ chương trình! Khi so sánh hai chương trình (hoặc hai node phức tạp), sự bằng nhau của chúng sẽ được xác định bằng sự bằng nhau của mọi children, của mọi children của children, v.v. Chiến lược đơn giản nhưng mạnh mẽ này của#==cực kỳ hữu ích cho việc test triển khai.
class Stoffle::AST::Program attr_accessor :expressions def initialize @expressions = [] end def <<(expr) expressions << expr end def ==(other) expressions == other&.expressions end def children expressions end end Biểu thức vs Câu lệnh (Expressions vs. Statements)
Trong một số ngôn ngữ, nhiều cấu trúc không sinh ra giá trị; câu điều kiện là ví dụ kinh điển. Chúng được gọi là câu lệnh (statements). Các cấu trúc khác lại ước lượng ra một giá trị (ví dụ: gọi hàm). Chúng được gọi là biểu thức (expressions). Trong các ngôn ngữ khác, mọi thứ đều là biểu thức và sinh ra giá trị. Ruby là ví dụ của cách tiếp cận này. Thử gõ đoạn sau vào IRB để xem định nghĩa phương thức ước lượng ra giá trị gì:
irb(main):001:0> def two; 2; endNếu bạn không muốn mở IRB, tôi sẽ tiết lộ: trong Ruby, một biểu thức định nghĩa phương thức ước lượng ra một symbol (tên phương thức). Như bạn biết, Stoffle lấy cảm hứng nhiều từ Ruby, nên trong ngôn ngữ 장난 của chúng ta, mọi thứ cũng là biểu thức.
Hãy nhớ định nghĩa này đủ tốt cho mục đích thực tế, nhưng không thực sự có sự đồng thuận, và bạn có thể thấy thuật ngữ statement và expression được định nghĩa khác ở nơi khác.
Đi sâu hơn: Bắt đầu triển khai #parse_expr_recursively
Như vừa thấy ở đoạn code trên, #parse_expr_recursively là phương thức được gọi để có thể xây dựng node AST mới. #parse_expr_recursively sử dụng rất nhiều phương thức nhỏ hơn trong quá trình parse, nhưng chúng ta có thể nói yên tâm rằng đây là động cơ thực sự của parser. Mặc dù không dài lắm, phương thức này khó tiêu hóa hơn. Do đó, chúng ta sẽ chia nó thành hai phần. Trong phần này, hãy bắt đầu với đoạn đầu, đã đủ mạnh để parse một số phần đơn giản hơn của Stoffle. Nhắc lại, chúng ta đang đi qua các bước cần thiết để parse một chương trình đơn giản chỉ gồm một biểu thức gán biến:
Mã nguồn
my_var = 1 Token (Đầu ra của Lexer, Đầu vào cho Parser)
[:identifier, :'=', :number] Sau khi nhìn các token phải xử lý và tưởng tượng đầu ra lexer cho các biểu thức đơn giản tương tự, có vẻ như ý tưởng tốt là cố gắng liên kết các loại token với các phương thức parse cụ thể:
def parse_expr_recursively parsing_function = determine_parsing_function if parsing_function.nil? unrecognized_token_error return end send(parsing_function) end Trong triển khai ban đầu của #parse_expr_recursively, đó chính xác là điều chúng ta làm. Vì sẽ có rất nhiều loại token khác nhau phải xử lý, tốt hơn là tách quá trình quyết định này vào phương thức riêng - #determine_parsing_function, chúng ta sẽ xem ngay.
Khi hoàn tất, không nên còn token nào không nhận ra, nhưng như một biện pháp phòng vệ, chúng ta sẽ kiểm tra xem có hàm parse nào liên kết với token hiện tại hay không. Nếu không, chúng ta sẽ thêm lỗi vào biến instance @errors, chứa tất cả vấn đề xảy ra trong quá trình parse. Chúng ta không đi sâu vào chi tiết ở đây, nhưng bạn có thể xem triển khai đầy đủ của parser trên GitHub nếu tò mò.
#determine_parsing_function trả về một symbol đại diện cho tên phương thức parse sẽ được gọi. Chúng ta sẽ dùng send của Ruby để gọi phương thức thích hợp động.
Xác định phương thức parse và parse gán biến
Tiếp theo, hãy xem #determine_parsing_function để hiểu cơ chế ban đầu gọi các phương thức cụ thể để parse các cấu trúc khác nhau của Stoffle. #determine_parsing_function sẽ dùng cho mọi thứ (ví dụ: từ khóa và toán tử đơn ngôi) trừ toán tử hai ngôi. Chúng ta sẽ khám phá kỹ thuật dùng cho toán tử hai ngôi sau. Hiện tại, hãy xem #determine_parsing_function:
def determine_parsing_function if [:return, :identifier, :number, :string, :true, :false, :nil, :fn, :if, :while].include?(current.type) "parse_#{current.type}".to_sym elsif current.type == :'(' :parse_grouped_expr elsif [:"\n", :eof].include?(current.type) :parse_terminator elsif UNARY_OPERATORS.include?(current.type) :parse_unary_operator end end Như đã giải thích, #current là con trỏ ảo tới token đang xử lý tại thời điểm. Triển khai #determine_parsing_function rất trực tiếp; chúng ta nhìn token hiện tại (cụ thể là loại của nó) và trả về symbol đại diện cho phương thức thích hợp để gọi.
Nhớ rằng chúng ta đang đi qua các bước parse gán biến (my_var = 1), nên các loại token chúng ta xử lý là [:identifier, :'=', :number]. Loại token hiện tại là :identifier, nên #determine_parsing_function sẽ trả về :parse_identifier, như bạn đoán. Hãy nhìn bước tiếp theo, phương thức #parse_identifier:
def parse_identifier lookahead.type == :'=' ? parse_var_binding : AST::Identifier.new(current.lexeme) end Ở đây, chúng ta có một biểu hiện rất đơn giản về những gì hầu như tất cả các phương thức parse khác làm. Trong #parse_identifier - và các phương thức parse khác - chúng ta kiểm tra token để xác định xem cấu trúc chúng ta mong đợi có thực sự hiện diện hay không. Chúng ta biết có một identifier, nhưng phải nhìn token tiếp theo để xác định xem có phải gán biến không, trường hợp sẽ xảy ra nếu loại token tiếp theo là :'=', hoặc nếu chỉ có identifier đơn lẻ hoặc tham gia vào biểu thức phức tạp hơn. Hãy tưởng tượng ví dụ một biểu thức số học thao tác các giá trị lưu trong biến.
Vì chúng ta có :'=' tiếp theo, #parse_var_binding sẽ được gọi:
def parse_var_binding identifier = AST::Identifier.new(current.lexeme) consume(2) AST::VarBinding.new(identifier, parse_expr_recursively) end Ở đây, chúng ta bắt đầu bằng cách tạo node AST mới đại diện cho identifier đang xử lý. Constructor của AST::Identifier mong đợi lexeme của token identifier (tức là chuỗi ký tự, chuỗi "my_var" trong trường hợp này), nên chúng ta cung cấp nó. Sau đó chúng ta tiến hai vị trí trong luồng token đang xử lý, làm cho token loại :number trở thành token tiếp theo cần phân tích. Nhớ rằng chúng ta đang xử lý [:identifier, :'=', :number].
Cuối cùng, chúng ta xây dựng và trả về node AST đại diện cho gán biến. Constructor của AST::VarBinding mong đợi hai tham số: node AST identifier (bên trái của biểu thức gán) và bất kỳ biểu thức hợp lệ nào (bên phải). Có một điểm quan trọng: để tạo bên phải của biểu thức gán biến, chúng ta gọi #parse_expr_recursively lại. Điều này có thể hơi lạ lúc đầu, nhưng hãy nhớ biến có thể gán với biểu thức rất phức tạp, không chỉ một con số đơn giản như ví dụ. Nếu phải định nghĩa chiến lược parse của chúng ta trong một từ, đó sẽ là đệ quy (recursive). Bây giờ tôi đoán bạn bắt đầu hiểu tại sao #parse_expr_recursively có tên như vậy.
Trước khi kết thúc phần này, chúng ta nên nhanh chóng khám phá cả AST::Identifier và AST::VarBinding. Trước tiên, AST::Identifier:
class Stoffle::AST::Identifier < Stoffle::AST::Expression attr_accessor :name def initialize(name) @name = name end def ==(other) name == other&.name end def children [] end end Không có gì phức tạp. Đáng nói là node lưu tên biến và không có children.
Bây giờ, AST::VarBinding:
class Stoffle::AST::VarBinding < Stoffle::AST::Expression attr_accessor :left, :right def initialize(left, right) @left = left @right = right end def ==(other) children == other&.children end def children [left, right] end end Bên trái là node AST::Identifier. Bên phải là gần như mọi loại node có thể - từ một con số đơn giản như ví dụ, đến thứ phức tạp hơn - đại diện cho biểu thức mà identifier được gán. #children của gán biến là các node AST nó giữ trong @left và @right.
Từ mã nguồn đến AST, ví dụ thứ hai
Phiên bản hiện tại của #parse_expr_recursively đã có thể parse một số biểu thức đơn giản, như chúng ta thấy ở phần trước. Trong phần này, chúng ta sẽ hoàn thiện triển khai để nó cũng parse được các thực thể phức tạp hơn, như toán tử hai ngôi và logic. Ở đây, chúng ta sẽ khám phá từng bước cách parser xử lý một chương trình định nghĩa hàm. Đây là mã nguồn, biểu diễn đơn giản của token do lexer sinh ra và, như phần đầu, biểu diễn trực quan của AST chúng ta sẽ tạo:
Mã nguồn
fn double: num num * 2 end Token (Đầu ra của Lexer, Đầu vào cho Parser)
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] Biểu diễn trực quan của Đầu ra Parser (Một Cây Cú pháp Trừu tượng)
Trước khi tiến tiếp, hãy lùi lại một chút và nói về quy tắc độ ưu tiên toán tử. Chúng dựa trên quy ước toán học; trong toán học, chúng chỉ là quy ước, không có gì cơ bản dẫn đến độ ưu tiên chúng ta quen thuộc. Các quy tắc này cũng cho phép xác định thứ tự đúng để ước lượng biểu thức và, trong trường hợp của chúng ta, để parse nó trước. Để định nghĩa độ ưu tiên của mỗi toán tử, chúng ta chỉ cần một map (tức Hash) của loại token và số nguyên. Số càng lớn nghĩa là toán tử nên được xử lý trước:
# Chúng ta định nghĩa các quy tắc độ ưu tiên ở đầu Stoffle::Parser. module Stoffle class Parser # ... UNARY_OPERATORS = [:'!', :'-'].freeze BINARY_OPERATORS = [:'+', :'-', :'*', :'/', :'==', :'!=', :'>', :'<', :'>=', :'<='].freeze LOGICAL_OPERATORS = [:or, :and].freeze LOWEST_PRECEDENCE = 0 PREFIX_PRECEDENCE = 7 OPERATOR_PRECEDENCE = { or: 1, and: 2, '==': 3, '!=': 3, '>': 4, '<': 4, '>=': 4, '<=': 4, '+': 5, '-': 5, '*': 6, '/': 6, '(': 8 }.freeze # ... end end Kỹ thuật dùng trong #parse_expr_recursively dựa trên thuật toán parser nổi tiếng do nhà khoa học máy tính Vaughan Pratt trình bày trong bài báo năm 1973, "Top Down Operator Precedence". Như bạn sẽ thấy, thuật toán rất đơn giản, nhưng hơi khó nắm bắt hoàn toàn. Có thể nói nó hơi kỳ diệu. Chúng ta sẽ làm trong bài viết này để cố gắng hiểu trực quan cách hoạt động của kỹ thuật này là đi từng bước qua những gì xảy ra khi parse đoạn Stoffle đã nói. Vậy, không còn chần chừ, đây là phiên bản hoàn chỉnh của #parse_expr_recursively:
def parse_expr_recursively(precedence = LOWEST_PRECEDENCE) parsing_function = determine_parsing_function if parsing_function.nil? unrecognized_token_error return end expr = send(parsing_function) return if expr.nil? # Khi expr là nil, nghĩa là đã gặp \n hoặc eof. # Lưu ý rằng ở đây, chúng ta đang kiểm tra token TIẾP THEO. while nxt_not_terminator? && precedence < nxt_precedence infix_parsing_function = determine_infix_function(nxt) return expr if infix_parsing_function.nil? consume expr = send(infix_parsing_function, expr) end expr end #parse_expr_recursively giờ chấp nhận tham số precedence. Nó đại diện cho "mức" độ ưu tiên được xem xét trong một lần gọi phương thức. Ngoài ra, phần đầu của phương thức khá giống nhau. Sau đó - nếu chúng ta đã xây dựng được biểu thức ở phần đầu - đến phần mới của phương thức. Khi token tiếp theo không phải là dấu kết thúc (tức là xuống dòng hoặc hết file) VÀ độ ưu tiên (tham số precedence) thấp hơn độ ưu tiên của token tiếp theo, chúng ta có thể tiếp tục consume luồng token.
Trước khi nhìn vào trong while, hãy suy nghĩ một chút về ý nghĩa của điều kiện thứ hai (precedence < nxt_precedence). Nếu độ ưu tiên của token tiếp theo cao hơn, biểu thức vừa xây dựng (biến cục bộ expr) có thể là con của node chưa được xây dựng (nhớ rằng chúng ta đang xây dựng AST, một cây cú pháp trừu tượng). Trước khi đi qua parse đoạn Stoffle, hãy suy ngẫm về parse biểu thức số học đơn giản: 2 + 2. Khi parse biểu thức này, phần đầu của phương thức sẽ xây dựng node AST::Number đại diện cho 2 đầu tiên và lưu vào expr. Sau đó, chúng ta bước vào while vì độ ưu tiên của token tiếp theo (:'+') cao hơn độ ưu tiên mặc định. Chúng ta sẽ gọi phương thức parse xử lý phép cộng, truyền cho nó node AST::Number và nhận lại node đại diện cho toán tử hai ngôi (AST::BinaryOperator). Cuối cùng, chúng ta ghi đè giá trị lưu trong expr, node đại diện cho 2 đầu tiên trong 2 + 2, bằng node mới đại diện cho phép cộng. Chú ý rằng cuối cùng thuật toán này cho phép sắp xếp lại các node; chúng ta bắt đầu xây dựng node AST::Number và kết thúc với nó là node sâu hơn trong cây, như một con của node AST::BinaryOperator.
Parse định nghĩa hàm từng bước
Sau khi đã đi qua giải thích tổng quan về #parse_expr_recursively, hãy quay lại định nghĩa hàm đơn giản:
fn double: num num * 2 end Ngay cả việc xem xét mô tả đơn giản hóa của quá trình thực thi parser khi parse đoạn này có thể khiến bạn mệt mỏi (và thực tế có thể đúng!), nhưng tôi nghĩ nó rất giá trị để hiểu tốt hơn cả #parse_expr_recursively và việc parse các phần cụ thể (định nghĩa hàm và toán tử nhân). Trước hết, đây là các loại token chúng ta sẽ xử lý (dưới đây là đầu ra cho @tokens.map(&:type), bên trong parser sau khi lexer token hóa xong đoạn code):
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] Bảng dưới đây cho thấy thứ tự các phương thức quan trọng được gọi khi parse các token trên. Hãy nhớ đây là đơn giản hóa, nếu bạn muốn thực sự hiểu tất cả các bước chính xác của parser, tôi khuyên dùng debugger Ruby như Byebug và tiến từng dòng khi chương trình chạy.
Parser của chúng ta dưới kính hiển vi
Có một test dùng chính đoạn code chúng ta đang khám phá, có sẵn trong mã nguồn Stoffle. Bạn tìm thấy nó trong spec/lib/stoffle/parser_spec.rb; đó là test dùng đoạn code tên
complex_program_ok_2.sfe.Để khám phá thực thi parser từng bước, bạn có thể chỉnh sửa mã nguồn và thêm gọi
byebugở đầuParser#parse, chạy chỉ test trên với RSpec, sau đó dùng lệnhstepcủa Byebug để tiến chương trình từng dòng.Xem thêm thông tin về cách Byebug hoạt động và tất cả lệnh có sẵn bằng cách truy cập file README của dự án trên GitHub.
| Phương thức được gọi | Token hiện tại | Token tiếp theo | Biến đáng chú ý / kết quả gọi | Ghi chú |
|---|---|---|---|---|
| parse | nil | :fn | ||
| parse_expr_recursively | :fn | :identifier | precedence = 0, parsing_function = :parse_fn | |
| parse_function_definition | :fn | :identifier | parse_fn là alias của parse_function_definition | |
| parse_function_params | :identifier | :":" | ||
| parse_block | :"\n" | :identifier | ||
| parse_expr_recursively | :identifier | :* | precedence = 0, parsing_function = :parse_identifier, nxt_precedence() trả về 6, infix_parsing_function = :parse_binary_operator | |
| parse_identifier | :identifier | :* | ||
| parse_binary_operator | :* | :number | op_precedence = 6 | |
| parse_expr_recursively | :number | :"\n" | precedence = 6, parsing_function = :parse_number, nxt_precedence() trả về 0 | |
| parse_number | :number | :"\n" |
Bây giờ chúng ta đã có khái niệm chung về các phương thức được gọi, cũng như trình tự, hãy nghiên cứu một số phương thức parse chưa thấy chi tiết hơn.
Phương thức #parse_function_definition
Phương thức #parse_function_definition được gọi khi token hiện tại là :fn và token tiếp theo là :identifier:
def parse_function_definition return unless consume_if_nxt_is(build_token(:identifier)) fn = AST::FunctionDefinition.new(AST::Identifier.new(current.lexeme)) if nxt.type != :"\n" && nxt.type != :':' unexpected_token_error return end fn.params = parse_function_params if nxt.type == :':' return unless consume_if_nxt_is(build_token(:"\n", "\n")) fn.body = parse_block fn end #consume_if_nxt_is - như bạn đoán - tiến con trỏ nếu token tiếp theo thuộc loại cho trước. Ngược lại, nó thêm lỗi vào @errors. #consume_if_nxt_is rất hữu ích - và được dùng ở nhiều phương thức parse - khi muốn kiểm tra cấu trúc token để xác định cú pháp hợp lệ. Sau khi làm vậy, token hiện tại là loại :identifier (chúng ta xử lý 'double', tên hàm), và chúng ta xây dựng AST::Identifier và truyền nó cho constructor tạo node đại diện cho định nghĩa hàm (AST::FunctionDefinition). Chúng ta không xem chi tiết ở đây, nhưng cơ bản node AST::FunctionDefinition mong đợi tên hàm, có thể mảng tham số và thân hàm.
Bước tiếp theo trong #parse_function_definition là kiểm tra token tiếp theo sau identifier là dấu kết thúc biểu thức (tức hàm không tham số) hay dấu hai chấm (tức hàm có một hoặc nhiều tham số). Nếu có tham số, như trường hợp hàm double chúng ta đang định nghĩa, chúng ta gọi #parse_function_params để parse chúng. Chúng ta sẽ xem phương thức này ngay, nhưng trước hãy tiếp tục và kết thúc khám phá #parse_function_definition.
Bước cuối là kiểm tra cú pháp nữa để xác nhận có dấu kết thúc sau tên hàm + tham số, sau đó tiến hành parse thân hàm bằng cách gọi #parse_block. Cuối cùng, trả về fn, giữ instance AST::FunctionDefinition hoàn chỉnh, với tên hàm, tham số và thân hàm.
Chi tiết parse tham số hàm
Ở phần trước, chúng ta thấy #parse_function_params được gọi bên trong #parse_function_definition. Nếu quay lại bảng tóm tắt luồng thực thi và trạng thái parser, chúng ta thấy khi #parse_function_params bắt đầu chạy, token hiện tại là loại :identifier, và token tiếp theo là :":" (tức là vừa parse xong tên hàm). Với tất cả điều này, hãy xem thêm code:
def parse_function_params consume return unless consume_if_nxt_is(build_token(:identifier)) identifiers = [] identifiers << AST::Identifier.new(current.lexeme) while nxt.type == :',' consume return unless consume_if_nxt_is(build_token(:identifier)) identifiers << AST::Identifier.new(current.lexeme) end identifiers end Trước khi giải thích từng phần, hãy tóm tắt token phải xử lý và vị trí chúng ta đang ở:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] # here ▲ Phần đầu của #parse_function_params đơn giản. Nếu cú pháp hợp lệ (ít nhất một identifier sau :), chúng ta di chuyển con trỏ hai vị trí:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] # ▲ Giờ chúng ta đang ở tham số đầu tiên cần parse (token loại :identifier). Như mong đợi, tạo AST::Identifier và đẩy vào mảng các tham số tiềm năng. Phần tiếp theo của #parse_function_params, tiếp tục parse tham số miễn là còn dấu phân cách tham số (token loại :','). Kết thúc phương thức bằng cách trả về biến cục bộ identifiers, mảng có nhiều node AST::Identifier, mỗi node đại diện cho một tham số. Tuy nhiên, trong trường hợp này mảng chỉ có một phần tử.
Thân hàm thì sao?
Bây giờ hãy đi sâu vào phần cuối của parse định nghĩa hàm: xử lý thân hàm. Khi #parse_block được gọi, chúng ta đang ở dấu kết thúc đánh dấu hết danh sách tham số hàm:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] # ▲ Đây là triển khai #parse_block:
def parse_block consume block = AST::Block.new while current.type != :end && current.type != :eof && nxt.type != :else expr = parse_expr_recursively block << expr unless expr.nil? consume end unexpected_token_error(build_token(:eof)) if current.type == :eof block end AST::Block là node AST đại diện cho một khối code. Nói cách khác, AST::Block chỉ giữ danh sách biểu thức, rất giống như node gốc của chương trình, node AST::Program (như thấy ở đầu bài). Để parse khối (tức thân hàm), chúng ta tiếp tục tiến qua token chưa xử lý cho đến khi gặp token đánh dấu hết khối.
Để parse các biểu thức cấu thành khối, chúng ta dùng #parse_expr_recursively đã biết. Chúng ta sẽ bước vào lời gọi phương thức này ngay; đây là điểm bắt đầu parse phép nhân xảy ra trong hàm double. Theo dõi gần gũi sẽ giúp hiểu việc dùng giá trị độ ưu tiên trong #parse_expr_recursively và cách toán tử trung tố (toán tử * trong trường hợp này) được xử lý. Trước khi làm vậy, hãy kết thúc khám phá #parse_block.
Trước khi trả về node AST đại diện cho khối, chúng ta kiểm tra token hiện tại có loại :eof không. Nếu đúng, có lỗi cú pháp vì Stoffle yêu cầu khối phải kết thúc bằng từ khóa end. Để hoàn tất giải thích #parse_block, tôi nên nhắc điều bạn có thể đã nhận ra; một điều kiện của vòng lặp kiểm tra token tiếp theo có loại :else không. Điều này xảy ra vì #parse_block được chia sẻ bởi các phương thức parse khác, bao gồm các phương thức parse điều kiện và vòng lặp. Rất gọn gàng, phải không?!
Parse toán tử trung tố (Infix Operators)
Tên nghe hơi sang trọng, nhưng toán tử trung tố cơ bản là những thứ chúng ta rất quen trong số học, cộng thêm một số toán tử khác mà lập trình viên quen hơn:
module Stoffle class Parser # ... BINARY_OPERATORS = [:'+', :'-', :'*', :'/', :'==', :'!=', :'>', :'<', :'>=', :'<='].freeze LOGICAL_OPERATORS = [:or, :and].freeze # ... end end Chúng được mong đợi dùng trung tố khi dùng ký pháp trung tố, như trường hợp Stoffle, nghĩa là chúng nên xuất hiện ở giữa hai toán hạng (ví dụ: * xuất hiện ở giữa num * 2 trong hàm double). Điều đáng nói là mặc dù ký pháp trung tố phổ biến, vẫn có cách khác định vị toán tử tương đối với toán hạng. Nếu tò mò, hãy tìm hiểu "Ký pháp Ba Lan" (Polish notation) và "Ký pháp Ba Lan ngược" (reverse Polish notation).
Để hoàn tất parse hàm double, chúng ta phải xử lý toán tử *:
fn double: num num * 2 end Ở phần trước, chúng ta nhắc đến việc parse biểu thức cấu thành thân hàm double bắt đầu khi #parse_expr_recursively được gọi trong #parse_block. Khi đó, vị trí trong @tokens:
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] # ▲ Và, để làm mới trí nhớ, đây là code #parse_expr_recursively lại:
def parse_expr_recursively(precedence = LOWEST_PRECEDENCE) parsing_function = determine_parsing_function if parsing_function.nil? unrecognized_token_error return end expr = send(parsing_function) return if expr.nil? # Khi expr là nil, nghĩa là đã gặp \n hoặc eof. # Lưu ý ở đây, chúng ta đang kiểm tra token TIẾP THEO. while nxt_not_terminator? && precedence < nxt_precedence infix_parsing_function = determine_infix_function(nxt) return expr if infix_parsing_function.nil? consume expr = send(infix_parsing_function, expr) end expr end Ở phần đầu của phương thức, chúng ta sẽ dùng cùng #parse_identifier đã dùng để parse biến num. Sau đó, lần đầu tiên điều kiện while evaluates thành true; token tiếp theo không phải dấu kết thúc, và độ ưu tiên của token tiếp theo lớn hơn độ ưu tiên của lần thực thi parse_expr_recursively hiện tại (precedence là mặc định 0, trong khi nxt_precedence trả về 6 vì token tiếp theo là loại :'*'). Điều này chỉ ra node đã xây dựng (node AST::Identifier đại diện cho num) có thể sẽ sâu hơn trong AST (tức là sẽ là con của node chưa xây dựng). Chúng ta vào vòng lặp và gọi #determine_infix_function, truyền cho nó token tiếp theo (toán tử *):
def determine_infix_function(token = current) if (BINARY_OPERATORS + LOGICAL_OPERATORS).include?(token.type) :parse_binary_operator elsif token.type == :'(' :parse_function_call end end Vì * là toán tử hai ngôi, chạy #determine_infix_function cho kết quả :parse_binary_operator. Quay lại #parse_expr_recursively, chúng ta tiến con trỏ token một vị trí và gọi #parse_binary_operator, truyền theo giá trị expr (node AST::Identifier đại diện cho num):
[:fn, :identifier, :":", :identifier, :"\n", :identifier, :*, :number, :"\n", :end, :"\n", :eof] #▲ def parse_binary_operator(left) op = AST::BinaryOperator.new(current.type, left) op_precedence = current_precedence consume op.right = parse_expr_recursively(op_precedence) op end class Stoffle::AST::BinaryOperator < Stoffle::AST::Expression attr_accessor :operator, :left, :right def initialize(operator, left = nil, right = nil) @operator = operator @left = left @right = right end def ==(other) operator == other&.operator && children == other&.children end def children [left, right] end end Tại #parse_binary_operator, chúng ta tạo AST::BinaryOperator (triển khai ở trên nếu tò mò) đại diện cho *, đặt toán hạng trái là identifier (num) nhận từ #parse_expr_recursively. Sau đó, lưu giá trị độ ưu tiên của * vào biến cục bộ op_precedence và tiến con trỏ token. Để hoàn tất node đại diện cho *, chúng ta gọi #parse_expr_recursively lại! Chúng ta cần làm vậy vì bên phải toán tử không phải lúc nào cũng là một con số hoặc identifier đơn lẻ; nó có thể là biểu thức phức tạp hơn, như num * (2 + 2).
Một điều cực kỳ quan trọng xảy ra ở #parse_binary_operator là cách chúng ta gọi lại #parse_expr_recursively. Chúng ta gọi nó truyền giá trị độ ưu tiên 6 (độ ưu tiên của *, lưu ở op_precedence). Ở đây chúng ta quan sát khía cạnh quan trọng của thuật toán parse, đã nhắc trước. Bằng cách truyền giá trị độ ưu tiên khá cao, giống như * đang "kéo" token tiếp theo làm toán hạng của nó. Hãy tưởng tượng parse biểu thức như num * 2 + 1; trong trường hợp này, giá trị độ ưu tiên của * truyền vào lời gọi #parse_expr_recursively tiếp theo sẽ đảm bảo 2 trở thành toán hạng phải của * chứ không phải toán hạng của +, có độ ưu tiên thấp hơn là 5.
Sau khi #parse_expr_recursively trả về node AST::Number, chúng ta đặt nó làm toán hạng phải của * và cuối cùng trả về node AST::BinaryOperator hoàn chỉnh. Lúc này, chúng ta về cơ bản đã parse xong chương trình Stoffle. Còn phải parse một số token dấu kết thúc, nhưng điều này đơn giản và không quá thú vị. Cuối cùng, chúng ta sẽ có instance AST::Program tại @ast với các biểu thức có thể biểu diễn trực quan như cây đã thấy ở đầu bài và phần mở đầu phần hai:
Kết luận
Trong bài viết này, chúng ta đã bao quát các khía cạnh chính của parser Stoffle. Nếu bạn hiểu các phần đã khám phá, bạn không nên gặp nhiều khó khăn hiểu các phương thức parse khác chưa bao quát, như parse điều kiện và vòng lặp. Tôi khuyến khích bạn tự khám phá mã nguồn parser và chỉnh sửa triển khai nếu bạn cảm thấy hứng thú! Triển khai đi kèm bộ test toàn diện, vì vậy đừng ngại thử nghiệm và làm "loạn" parser.
Trong các bài tiếp theo của loạt bài, chúng ta sẽ cuối cùng "thổi hồn" vào con quái nhỏ bằng cách triển khai phần còn thiếu: trình thông dịch duyệt cây (tree-walk interpreter). Tôi không thể chờ đợi được khi cùng bạn chạy chương trình Stoffle đầu tiên!