
Enumerator là trái tim làm Ruby mạnh mẽ, dynamic. Lazy enumerator tiến xa hơn: cho phép làm việc hiệu quả với collection cực lớn.
File — thực ra — chỉ là collection lớn của dòng hoặc ký tự. Vì vậy lazy enumerator cho phép làm điều thú vị, mạnh mẽ với file.
Enumerator là gì?
Mỗi lần dùng method như `each`, bạn tạo enumerator. Đó là lý do chain method như `[1,2,3].map { ... }.reduce { ... }`. Xem ví dụ: gọi `each` trả về enumerator, dùng để làm iterative operation khác.
# Code từ Ruby docs https://ruby-doc.org/core-2.2.0/Enumerator.html
enumerator = %w(one two three).each
puts enumerator.class # => Enumerator
enumerator.each_with_object("foo") do |item, obj|
  puts "#{obj}: #{item}"
end
# foo: one
# foo: two
# foo: three
Lazy enumerator cho collection lớn
Enumerator thường có vấn đề với collection lớn. Lý do: mỗi method gọi muốn iterate toàn bộ collection. Thử chạy code sau:
# Code này "treo", phải ctrl-c thoát
(1..Float::INFINITY).reject { |i| i.odd? }.map { |i| i*i }.first(5)
Method `reject` chạy mãi, vì không bao giờ finish iterate infinite collection.
Nhưng với thêm nhỏ, code chạy ngon. Chỉ cần gọi `lazy`, Ruby làm điều thông minh: chỉ iterate cần thiết cho computation. Chỉ 10 row, nhỏ hơn infinity nhiều.
(1..Float::INFINITY).lazy.reject { |i| i.odd? }.map { |i| i*i }.first(5)
# => [4, 16, 36, 64, 100]
Sáu nghìn bản Moby Dick
Test file trick, cần file lớn. Lớn đến nỗi "failure to be lazy" rõ rệt.
Tải Moby Dick từ Project Gutenberg, tạo text file 100 bản. Không đủ lớn. Lên ~6,000 bản. Tức là tôi có thể là người duy nhất có text file 6,000 bản Moby Dick. Hơi khiêm tốn. Nhưng nói nhảm.
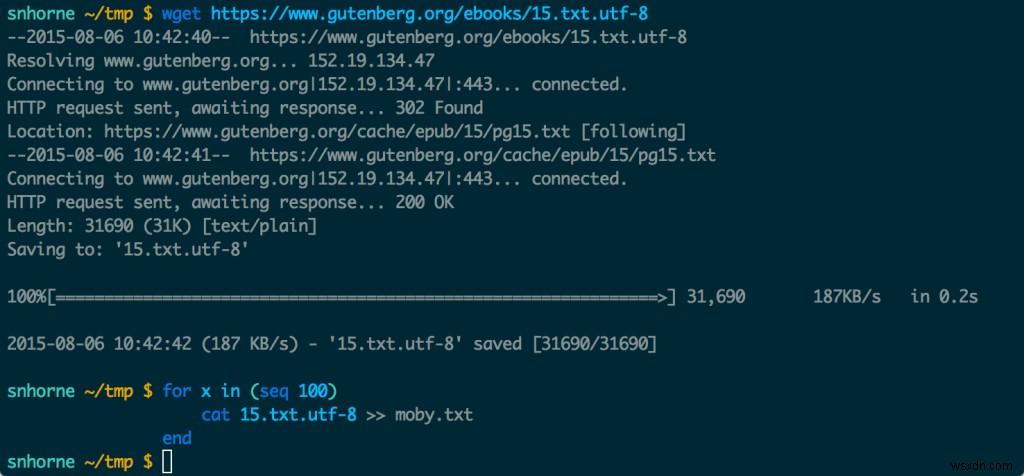 Tải Moby Dick duplicate hàng nghìn lần để có file lớn test. Syntax không phải bash. Là fish shell. Tôi có thể là người cuối cùng dùng nó.
Cách lấy enumerator cho file
Cool Ruby trick: hầu như method nào iterate collection sẽ trả Enumerator object nếu gọi không pass block. Ý nghĩa gì?
Xem ví dụ. Mở file, dùng `each_line` in từng dòng. Nhưng gọi không block, nhận enumerator. Method quan tâm: `each_line`, `each_char`, `each_codepoint`.
File.open("moby.txt") do |f|
  # In từng dòng
  f.each_line do |l|
    puts l
  end
  # Cũng in từng dòng. Nhưng làm bằng cách gọi `each` trên Enumerator trả về bởi `each_line`
  f.each_line.each do |l|
    puts l
  end
end
Hai ví dụ gần giống, nhưng cái hai nắm chìa khóa SIÊU QUYỀN.
Sử dụng enumerator của file
Khi có enumerator "chứa" tất cả dòng file, bạn slice và dice dòng đó như Ruby array. Vài ví dụ:
file.each_line.each_with_index.map { |line, i| "Line #{ i }: #{ line }" }[3, 10]
file.each_line.select { |line| line.size == 9 }.first(10)
file.each_line.reject { |line| line.match /whale/i }
Rất cool, nhưng tất cả có vấn đề lớn: load toàn bộ file vào memory trước khi iterate. Với file 6,000 bản Moby Dick, lag nhận thấy.
Lazy-load các dòng file
Quét file lớn tìm 10 instance đầu của "whale", không cần tiếp tục sau lần thứ 10. May mắn dễ dàng bảo Ruby enumerator làm vậy. Chỉ dùng keyword "lazy".
Ví dụ dưới tận dụng lazy loading làm điều sophisticated:
File.open("moby.txt") do |f|
  # Lấy 3 dòng đầu chứa "whale"
  f.each_line.lazy.select { |line| line.match(/whale/i) }.first(3)
  # Quay về đầu file
  f.rewind
  # Prepend line number cho 3 dòng đầu
  f.each_line.lazy.each_with_index.map do |line, i|
    "LINE #{ i }: #{ line }"
  end.first(3)
  f.rewind
  # Lấy 3 dòng đầu chứa "whale" kèm line number
  f.each_line.lazy.each_with_index.map { |line, i| "LINE #{ i }: #{ line }" }.select { |line| line.match(/whale/i) }.first(3)
end
Không chỉ cho file
Socket, pipe, serial port — trong Ruby dùng class IO. Nghĩa là đều có `each_line`, `each_char`, `each_codepoint`. Dùng trick này cho tất cả. Pretty neat!
Không phải phép thuật
Sub malheureusement, lazy enumerator chỉ nhanh nếu task không yêu cầu đọc toàn file. Tìm từ chỉ xuất hiện trang cuối sách, phải đọc hết sách mới tìm được. Nhưng trường hợp đó approach này không chậm hơn non-enumerator approach.