
Bài viết gốc đăng tải ngày 17 tháng 6 năm 2020 tại Onica.com/blog
Các tổ chức trên nhiều ngành công nghiệp tìm cách sử dụng phân tích dữ liệu cho vận hành và các chức năng khác then chốt để thành công. Tuy nhiên, khi khối lượng dữ liệu tăng, quản lý và trích xuất giá trị có thể trở nên ngày càng phức tạp.
Amazon Redshift
Amazon® Redshift® là dịch vụ data warehouse mạnh mẽ từ Amazon Web Services® (AWS) đơn giản hóa quản lý và phân tích dữ liệu. Hãy xem Amazon Redshift và một số thực hành tốt nhất bạn có thể triển khai để tối ưu hóa hiệu suất truy vấn dữ liệu.
Data lakes so với Data warehouse
Trước khi đào sâu vào Amazon Redshift, quan trọng là biết sự khác biệt giữa data lakes và warehouse. Data lake, như Amazon S3, là kho dữ liệu tập trung lưu trữ dữ liệu có cấu trúc và phi cấu trúc, ở bất kỳ quy mô nào và từ nhiều nguồn, mà không thay đổi dữ liệu. Mặt khác, Data warehouse lưu trữ dữ liệu ở trạng thái đã đối chiếu được tối ưu để thực hiện phân tích liên tục và chỉ tải dữ liệu cần thiết cho phân tích từ data lakes.
Amazon Redshift đưa lưu trữ cho phân tích dữ liệu lên một cấp độ mới, hợp nhất các đặc chất của data lakes và warehouses thành phương pháp "lake house". Nó cho phép truy vấn data lake quy mô exabyte lớn trong khi vẫn hiệu quả về chi phí, giảm thiểu redundancy dữ liệu, và giảm thiểu overhead bảo trì và chi phí vận hành.
Kiến trúc Amazon Redshift
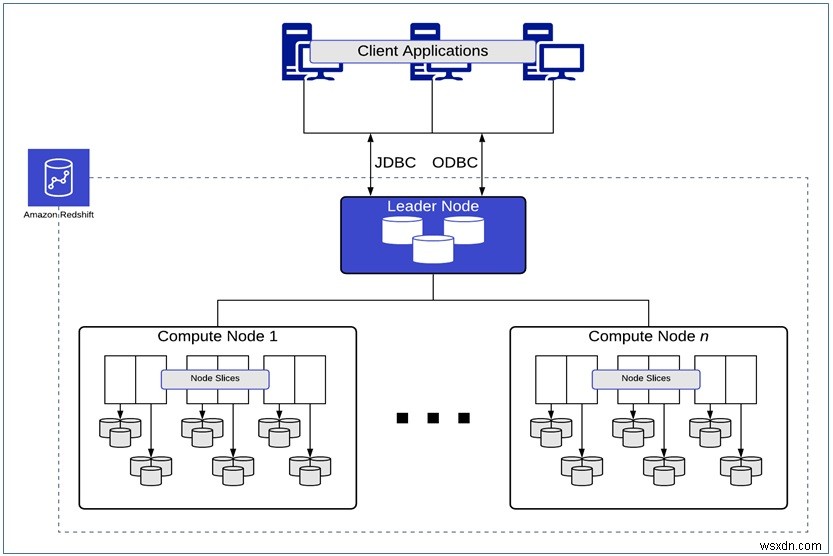
Để xử lý nhanh các truy vấn phức tạp trên tập dữ liệu lớn, kiến trúc Amazon Redshift hỗ trợ massively parallel processing (MPP) phân phối công việc trên nhiều compute node để xử lý song song.
Các node này được nhóm thành cluster, và mỗi cluster bao gồm ba loại node:
-
Leader Node: Quản lý kết nối, đóng vai trò SQL endpoint, và điều phối xử lý SQL song song.
-
Compute Nodes: Được cấu thành từ slices, thực thi truy vấn song song trên dữ liệu lưu trữ ở định dạng cột (columnar) và trong block 1 MB bất biến. Cluster Amazon Redshift có thể chứa từ 1 đến 128 compute node, được phân chia thành slices chứa dữ liệu bảng và đóng vai trò vùng xử lý cục bộ.
-
Amazon Redshift Spectrum Nodes: Thực thi truy vấn đối với data lake Amazon S3.
Tối ưu hiệu suất truy vấn
Bằng cách đưa bố cục vật lý của dữ liệu trong cluster vào sự đồng thuận với mẫu truy vấn của bạn, bạn có thể trích xuất hiệu suất truy vấn tối ưu. Nếu Amazon Redshift không hoạt động tối ưu, hãy xem xét cấu hình lại workload management.
Cấu hình lại Workload Management (WLM)
Thường được để ở cài đặt mặc định, tuning WLM có thể cải thiện hiệu suất. Bạn có thể tự động hóa tác vụ này hoặc thực hiện thủ công. Khi tự động, Amazon Redshift quản lý việc sử dụng bộ nhớ và concurrency dựa trên việc sử dụng tài nguyên cluster. Nó cho phép bạn thiết lập đến 8 hàng đợi ưu tiên. Khi thủ công, bạn có thể điều chỉnh số truy vấn đồng thời, phân bổ bộ nhớ và target.
Bạn cũng có thể tối ưu hiệu suất truy vấn thông qua các tham số cấu hình WLM sau:
-
Query monitoring rules giúp bạn quản lý truy vấn tốn kém hoặc chạy trốn.
-
Short query acceleration giúp bạn ưu tiên truy vấn chạy nhanh hơn truy vấn chạy lâu bằng cách sử dụng thuật toán machine learning để dự đoán thời gian thực thi truy vấn.
-
Concurrency scaling giúp bạn thêm nhiều cluster transient trong giây để tăng tốc truy vấn đọc đồng thời.
Thực hành tốt nhất WLM
Một số thực hành tốt nhất tuning WLM bao gồm:
- Tạo các WLM query khác nhau cho các loại workload khác nhau.
- Giới hạn tổng concurrency tối đa cho cluster chính ở 15 hoặc ít hơn để tối đa hóa throughput.
- Bật concurrency scaling.
- Tối thiểu hóa số tài nguyên trong một queue.
Tinh chỉnh phân phối dữ liệu
Các hàng của bảng tự động được phân phối bởi Amazon Redshift trên các node slice, dựa trên các distribution style sau:
AUTO: Bắt đầu với ALL và chuyển sang EVEN khi bảng phát triển.ALL: Bao gồm bảng nhỏ, thường được join và ít khi sửa đổi được đặt trên slice đầu tiên của mỗi compute node.EVEN: Bao gồm bảng fact lớn, độc lập, không thường được join hoặc aggregate trong phân phối round-robin trên các slice.KEY: Bao gồm bảng fact thường được join hoặc bảng dimension lớn. Trong style này, giá trị cột được hash, và cùng giá trị hash được đặt trên cùng slice.
Sử dụng đúng mẫu phân phối có thể tối đa hóa hiệu suất hoạt động JOIN, GROUP BY và INSERT INTO SELECT.
Tinh chỉnh sắp xếp dữ liệu
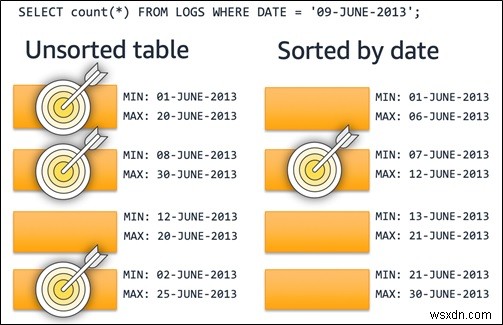
Sort keys định nghĩa thứ tự vật lý của dữ liệu trên disk. Cột bảng được dùng trong predicate WHERE clause là lựa chọn tốt cho sort keys và thường dùng cột liên quan đến ngày hoặc thời gian. Sử dụng Zone maps, lưu trữ trong bộ nhớ và tạo tự động, để xác định giá trị cực trị cho mỗi block dữ liệu. Sử dụng hiệu quả sort keys và zone maps cùng nhau có thể giúp bạn giới hạn quét đến số block tối thiểu cần thiết.
Sơ đồ sau minh họa cách sắp xếp bảng tập trung mục tiêu quét cho truy vấn dựa trên thời gian, từ đó cải thiện hiệu suất truy vấn.
Thực hành tốt nhất hiệu suất truy vấn tối ưu
Sử dụng các thay đổi Amazon Redshift được đề cập trước có thể cải thiện hiệu suất truy vấn và cải thiện hiệu quả chi phí và tài nguyên. Dưới đây là một số thực hành tốt nhất hơn bạn có thể triển khai để cải thiện hiệu suất hơn:
- Sử dụng
SORTkeys trên cột thường dùng trong filterWHEREclause. - Sử dụng
DISTKEYtrên cột thường dùng trong predicateJOIN. - Nén tất cả cột trừ cột sort-key đầu tiên.
- Phân vùng dữ liệu trong data lake dựa trên filter truy vấn như access pattern.
Để khám phá thêm thực hành tốt nhất, hãy đi sâu vào các thay đổi Amazon Redshift, và xem ví dụ phân tích truy vấn sâu, hãy đọc AWS Partner Network (APN) Blog.
Nếu bạn đang bắt đầu hành trình dữ liệu và muốn tận dụng dịch vụ AWS để nhanh chóng, tin cậy và hiệu quả về chi phí phát triển nền tảng dữ liệu của bạn, hãy liên hệ đội ngũ Data Engineering & Analytics của chúng tôi hôm nay.
Tìm hiểu thêm về dịch vụ Onica.
Sử dụng tab Phản Hồi để đưa ra bình luận hoặc đặt câu hỏi. Bạn cũng có thể nhấp vào Sales Chat để trò chuyện ngay và bắt đầu cuộc hội thoại.