
Bài viết gốc đăng tải ngày 27 tháng 11 năm 2020 tại ObjectRocket.com/blog.
Elasticsearch® rất tuyệt vời trong việc phân tán dữ liệu trên cluster của bạn với cài đặt mặc định, nhưng sau khi cluster của bạn bắt đầu phát triển, bạn nên điều chỉnh cài đặt mặc định để tăng cường hiệu quả. Hãy xem qua một số kiến thức cơ bản về sharding và cung cấp một số thực hành tốt nhất về indexing và shard.
Giới thiệu về Elasticsearch Sharding
Có nhiều tài liệu về cách shard Elasticsearch hoạt động, nhưng khái niệm cơ bản của sharding là chia dữ liệu của bạn thành một vài mảnh nhỏ hơn để tìm kiếm có thể hoạt động trên nhiều phần song song. Để hỗ trợ clustering và song song hóa các hàm index, hãy cắt từng index trong instance Elasticsearch của bạn thành các lát được đánh số. Các lát này được gọi là shard. Hãy xem một số hành vi chính của chúng:
- Mỗi shard được sao chép tùy thuộc vào cài đặt số lượng replica cho index. Vì vậy, với cài đặt số lượng replica là một, sẽ có hai bản sao của mỗi shard: một shard primary (chính) và một shard replica (bản sao). Shard chính là shard chính và được sử dụng cho các hoạt động
indexing/writevàsearch/read, trong khi shard replica chỉ được dùng chosearch/readvà khôi phục nếu primary thất bại. - Shard replica phải nằm trên host khác với shard parent primary của nó.
- Shard tự động phân tán trên số lượng host trong cluster theo mặc định, nhưng cùng một host vật lý có thể chứa nhiều primary shard. Bạn có thể sử dụng cài đặt Elasticsearch để sửa đổi hành vi này (rebalancing, phân bổ shard, v.v.), nhưng quy trình đó vượt quá phạm vi bài viết này.
- Mỗi shard phải nằm trong chỉ một host vì shard là không thể chia nhỏ hơn.
- Bạn có thể đặt số shard mà một index tạo khi tạo index, hoặc sử dụng mặc định toàn cục. Sau khi tạo index, bạn không thể thay đổi số shard mà không cần reindex.
- Bạn có thể đặt số replica mà một index có khi tạo index, hoặc sử dụng mặc định toàn cục. Bạn có thể thay đổi số này sau khi tạo index.
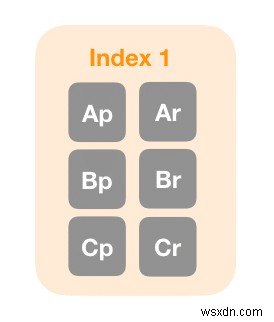
Hãy xem một ví dụ nhỏ. Tôi tạo một index với số shard là ba và cài đặt replica là một. Như bạn thấy trong sơ đồ trước, Elasticsearch tạo sáu shard cho bạn: Ba primary shard (Ap, Bp và Cp) và ba replica shard (Ar, Br và Cr).
Elasticsearch đảm bảo rằng các replica và primary nằm trên các host khác nhau, nhưng bạn có thể phân bổ nhiều primary shard cho cùng một host. Về chủ đề host, hãy đi sâu vào cách bạn phân bổ shard cho host của mình.
Phân bổ shard và Elasticsearch cluster
Elasticsearch cố gắng phân bổ shard trên tất cả các host có sẵn theo mặc định. Tại Rackspace ObjectRocket, mỗi cluster bao gồm master node, client node và data node. Các data node trong kiến trúc của chúng tôi hình thành các bucket mà bạn có thể gán shard.
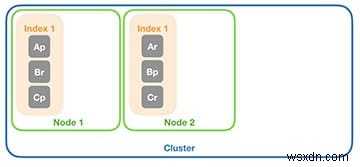
Sử dụng ví dụ trước, hãy lấy sáu shard đó và gán chúng cho cluster ObjectRocket cho Elasticsearch với hai data node (tối thiểu). Trong sơ đồ sau, bạn có thể thấy rằng đối với mỗi shard, primary nằm trên một data node, trong khi replica được đảm bảo nằm trên node kia. Hãy nhớ rằng các ví dụ ở đây chỉ cho thấy một phân bổ có thể. Dù phân bổ như thế nào, điều duy nhất chắc chắn là replica luôn được đặt trên data node khác với primary của nó.
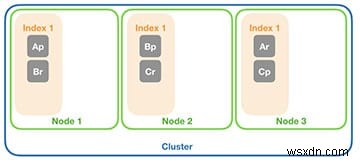
Bây giờ, hãy mở rộng ví dụ này và thêm một data node thứ ba. Lưu ý rằng hai shard được di chuyển đến data node mới, vì vậy bạn có hai shard trên mỗi node.
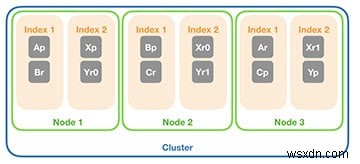
Cuối cùng, hãy thêm một index mới vào cluster này với số shard là hai và số replica đặt là hai. Điều này cho bạn hai primary mới (Xp và Yp) và bốn replica (Xr0, Xr1, Yr0, Yr1) mà bạn có thể phân tán trên cluster như thấy trong hình ảnh sau:
Đó là tất cả.
Cạm bẫy
Elasticsearch làm tất cả công việc khó cho bạn, nhưng có một số cạm bẫy cần tránh.
Cạm bẫy #1 — index lớn và shard lớn
Khắc phục sự cố index lớn với shard lớn là một trong những vấn đề dễ giảm thiểu nhất trong Elasticsearch. Người dùng bắt đầu với một single index rất dễ quản lý. Tuy nhiên, khi ứng dụng của họ phát triển, index của họ cũng phát triển. Điều này dẫn đến shard lớn vì kích thước shard liên quan trực tiếp đến lượng dữ liệu cluster.
Vấn đề đầu tiên này gây ra là hiệu suất sử dụng cluster kém. Khi shard phát triển, việc đặt chúng trên data node trở nên khó khăn hơn. Cần một khối không gian trống data node lớn để lưu trữ shard đó. Điều kiện này dẫn đến các node có nhiều không gian trống bị lãng phí. Ví dụ, nếu tôi có data node 8 GB, nhưng mỗi shard là 6 GB, tôi sẽ bị mắc kẹt 2 GB trên mỗi data node của mình. Vấn đề thứ hai là hot spotting. Nếu bạn gom dữ liệu vào vài shard, thì các truy vấn phức tạp không thể được chia nhỏ trên số lượng node lớn hơn và thực thi song song.
Đừng chán nản với index
Sử dụng nhiều index để giải quyết vấn đề không gian bị mắc kẹt. Phân tán dữ liệu của bạn trên nhiều index để tăng số shard trong cluster và phân tán dữ liệu đều đặn. Ngoài ra, giống như trò chơi Tetris, khi Elasticsearch đặt shard, nhiều index dễ dàng hơn để quản lý. Khả năng alias trong Elasticsearch vẫn có thể làm cho nhiều instance xuất hiện như một index đơn lẻ cho ứng dụng của bạn. Phần lớn Elastic Stack tạo index hàng ngày theo mặc định, đây là một thực hành tốt. Sau đó, bạn có thể sử dụng alias để giới hạn phạm vi tìm kiếm đến các phạm vi ngày cụ thể, sử dụng curator để xóa các index cũ khi chúng già đi, và sửa đổi cài đặt index khi dữ liệu của bạn phát triển mà không cần reindex dữ liệu cũ.
Tăng số shard khi kích thước index tăng
Thêm index thường xuyên hơn và tăng số shard khi index của bạn phát triển. Sau khi thấy kích thước shard bắt đầu vượt quá không gian mong muốn, bạn có thể cập nhật mẫu index của mình (hoặc bất cứ thứ gì bạn dùng để tạo index mới) để sử dụng nhiều shard hơn cho mỗi index. Tuy nhiên, điều này chỉ giúp nếu bạn tạo index mới thường xuyên, vì vậy khuyến nghị này được liệt kê thứ hai. Nếu không, bạn phải reindex để sửa đổi số shard, điều đó đại diện cho nhiều công việc hơn là quản lý nhiều index.
Quy tắc chung của chúng tôi: Nếu shard lớn hơn 40% kích thước data node, shard đó có thể quá lớn. Trong trường hợp này, chúng tôi khuyên nên reindex sang index có nhiều shard hơn hoặc nâng cấp lên plan kích thước lớn hơn (nhiều dung lượng hơn trên mỗi data node).
Cạm bẫy #2 — quá nhiều index hoặc shard
Nghịch lý là quá nhiều index hoặc shard. Sau khi đọc phần trước, bạn có thể chỉ nói, "Tốt. Tôi sẽ chỉ đặt mỗi doc vào index của nó và tạo một triệu shard". Vấn đề ở đó là index và shard có chi phí overhead. Overhead đó biểu hiện dưới dạng lưu trữ, tài nguyên bộ nhớ và hiệu suất xử lý.
Vì cluster phải duy trì trạng thái của tất cả shard và vị trí của chúng, số lượng shard khổng lồ trở thành một hoạt động ghi sổ lớn hơn, ảnh hưởng đến việc sử dụng bộ nhớ. Ngoài ra, vì bạn cần chia truy vấn nhiều cách hơn, bạn dành nhiều thời gian hơn cho việc scatter hoặc gather cho truy vấn. Cạm bẫy này phụ thuộc nhiều vào kích thước cluster, trường hợp sử dụng và các yếu tố khác, nhưng nói chung, chúng ta có thể giảm thiểu với một vài khuyến nghị.
Shard không nên lớn hơn 50 GB
Nói chung, 25 GB là kích thước lý tưởng cho shard lớn, và 50 GB đòi hỏi reindex. Cân nhắc này liên quan đến hiệu suất của shard và quá trình di chuyển shard khi cần thiết. Khi rebalancing, di chuyển shard sang node khác trong cluster. Chuyển dữ liệu 50 GB có thể mất quá nhiều thời gian và chiếm dụng hai node trong suốt quá trình.
Giữ kích thước shard nhỏ hơn 40% kích thước data node
Như đã đề cập trước đó, metric kích thước shard thứ hai mà chúng tôi quan tâm là phần trăm dung lượng data node mà một shard chiếm dụng. Trên dịch vụ Rackspace ObjectRocket, chúng tôi cung cấp các plan kích thước khác nhau liên quan đến lượng lưu trữ trên data node. Chúng tôi cố gắng điều chỉnh kích thước cluster và shard để đảm bảo shard lớn nhất không chiếm quá 40% dung lượng của data node. Trong cluster với nhiều index có kích thước khác nhau, điều này khá hiệu quả. Tuy nhiên, trong cluster với rất ít index lớn, chúng tôi thậm chí còn tích cực hơn và cố gắng giữ dung lượng data node dưới 30%.
Lý tưởng nhất, hãy đảm bảo bạn không làm bị mắc kẹt dung lượng trên data node. Nếu shard của bạn khoảng 45% kích thước data node, bạn cần data node ở mức sử dụng khoảng một nửa để đặt shard đó. Đó là rất nhiều dung lượng dự phòng không được sử dụng!
Kết luận
Lựa chọn cài đặt shard và indexing phù hợp có thể khó khăn, nhưng bằng cách lập kế hoạch, đưa ra một số quyết định tốt ngay từ đầu và tinh chỉnh theo thời gian, bạn có thể giữ cluster của mình khỏe mạnh và chạy tối ưu. Chúng tôi giúp các doanh nghiệp tinh chỉnh instance Elasticsearch của họ thường xuyên.
Tìm hiểu thêm về Dịch Vụ DBA của Rackspace.
Sử dụng tab Phản Hồi để đưa ra bình luận hoặc đặt câu hỏi. Bạn cũng có thể nhấp vào Sales Chat để trò chuyện ngay và bắt đầu cuộc hội thoại.