
Một ứng dụng phần mềm chỉ có giá trị bằng khả năng đáp ứng nhu cầu của khách hàng. Khi chúng ta xem xét nhu cầu của khách hàng, yêu cầu đầu tiên chúng ta gặp phải là tốc độ ứng dụng và độ tin cậy dữ liệu. Tuy nhiên, khi ứng dụng phát triển và mở rộng toàn cầu, cơ sở dữ liệu SQL thường trở thành nút thắt cổ chai về hiệu suất do lượng truy vấn tăng cao, độ trễ cao hơn, và cơ sở người dùng phân bố địa lý.
Để giải quyết các vấn đề này khi ứng dụng phát triển, caching là một trong những giải pháp đầu tiên để giảm tải trên cơ sở dữ liệu chính cho các truy vấn lặp lại và giảm độ trễ khi người dùng gửi truy vấn. Khi nói về cache, cùng một công cụ xuất hiện trong tâm trí mỗi người, đúng không? Đó chính là Redis. Redis là công cụ hoàn hảo để cache dữ liệu nhằm giảm tải và làm cho ứng dụng nhanh hơn. Upstash cũng cung cấp sao chép Redis phân bố toàn cầu, sẽ làm cho ứng dụng nhanh hơn thậm chí cả một cache thông thường.
Trong blog này, chúng ta sẽ khám phá các lợi ích kỹ thuật của việc tích hợp Global Redis với cơ sở dữ liệu SQL, thảo luận tác động của nó lên độ trễ và khả năng mở rộng, và cung cấp các ví dụ thực hành để sử dụng Global Redis với PostgreSQL và MySQL.
Lợi Ích Của Caching
Hãy xem trước tại sao chúng ta nên sử dụng caching.
Có hai lợi ích chính của caching mà tôi muốn nhắc đến trong blog này: giảm tải cơ sở dữ liệu và giảm độ trễ đến người dùng.
Giảm Tải Cơ Sở Dữ Liệu
Cơ sở dữ liệu SQL xuất sắc trong việc quản lý dữ liệu có cấu trúc và các truy vấn phức tạp, nhưng dưới tải nặng, chúng có thể trở thành nút thắt cổ chai. Lượng lớn các truy vấn lặp lại cho cùng một dữ liệu—như chi tiết sản phẩm, hồ sơ người dùng, hoặc cài đặt thường xuyên truy cập—tiêu tốn tài nguyên CPU và I/O đáng kể. Bằng cách cache các kết quả này, số lượng truy vấn truy cập cơ sở dữ liệu bị giảm mạnh, cho phép cơ sở dữ liệu tập trung vào các tác vụ quan trọng hơn như xử lý giao dịch và cập nhật.
Ví dụ:
- Không có caching: Một tính năng phổ biến trên trang web tạo ra hàng triệu truy vấn cơ sở dữ liệu giống hệt nhau mỗi ngày, làm chậm hiệu suất cho các hoạt động khác.
- Có caching: Các kết quả truy vấn thường xuyên truy cập được lưu trữ trong cache tốc độ cao như Redis, giảm tỷ lệ truy vấn cơ sở dữ liệu trên 90%.
Giảm Độ Trễ
Giảm tải cơ sở dữ liệu là cho sức khỏe hệ thống để đảm bảo độ tin cậy dữ liệu. Caching cũng cải thiện thời gian mà yêu cầu và truy vấn của người dùng mất.
Khi ứng dụng liên tục truy vấn cơ sở dữ liệu cho cùng một dữ liệu, việc truy xuất dữ liệu sẽ luôn mất thời gian dài. Đặc biệt nếu các truy vấn này tạo ra tải lớn trên cơ sở dữ liệu, tất cả các độ trễ này có thể tăng thêm. Điều này đặc biệt gây vấn đề cho các ứng dụng yêu cầu truy cập dữ liệu thời gian thực hoặc xử lý lượng truy vấn lớn, nơi ngay cả độ trễ nhỏ cũng có thể ảnh hưởng đáng kể đến hiệu suất.
Caching giải quyết vấn đề này bằng cách lưu trữ dữ liệu thường xuyên truy cập trong bộ nhớ, nhanh hơn nhiều để truy xuất so với truy vấn cơ sở dữ liệu. Bằng cách giảm sự phụ thuộc vào truy vấn cơ sở dữ liệu cho các yêu cầu lặp lại, caching giảm thiểu thời gian truyền mạng và tránh chi phí tính toán của việc thực thi các truy vấn phức tạp. Kết quả là, thời gian phản hồi được cải thiện đáng kể, cho phép ứng dụng cung cấp hiệu suất nhanh hơn, nhất quán hơn ngay cả dưới tải nặng hoặc trong môi trường phân tán.
Các Chiến Lược Caching Phổ Biến
Cũng quan trọng là hiểu hai chiến lược caching chính được sử dụng trong tối ưu hóa hiệu suất ứng dụng: cache-aside và write-through. Mỗi cách tiếp cận có trường hợp sử dụng và sự đánh đổi riêng, tùy thuộc vào yêu cầu của ứng dụng.
Cache-aside là kỹ thuật caching phổ biến nhất. Trong kỹ thuật này, ứng dụng kiểm tra cache để lấy dữ liệu trước. Nếu dữ liệu không có trong cache (cache miss), nó truy xuất dữ liệu từ cơ sở dữ liệu và ghi nó vào cache để sử dụng trong tương lai.
Đây là một sơ đồ đơn giản cho thấy cách cache-aside hoạt động, mà có thể bạn đã từng thấy ở đâu đó trước khi đến blog này.
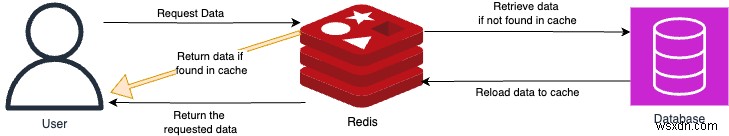
Lợi thế của caching này là kích thước cache được tối ưu hóa, và dữ liệu cache được tải lại khi người dùng cần. Mặt khác, nhược điểm là dữ liệu sẽ không có sẵn sau khi cache được dọn dẹp khi TTL hết hạn. Lúc đó, cache sẽ được tải lại khi người dùng yêu cầu dữ liệu đó. Trong trường hợp này, người dùng đó sẽ phải chờ truy vấn hoàn thành. Nhưng tất nhiên, các yêu cầu tiếp theo sẽ có thể lấy dữ liệu từ cache lại.
Trong chiến lược write-through, mọi thao tác ghi vào cơ sở dữ liệu ngay lập tức cũng được ghi vào cache. Điều này đảm bảo cache luôn được cập nhật với dữ liệu mới nhất từ cơ sở dữ liệu.
Đây là sơ đồ đơn giản của caching write-through:
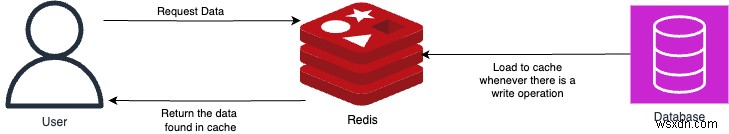
Chiến lược này đảm bảo sự nhất quán dữ liệu giữa cache và cơ sở dữ liệu và không yêu cầu nào trải qua độ trễ cao hơn vì dữ liệu sẽ đã có sẵn mà không cần chờ yêu cầu từ người dùng. Tuy nhiên, nhược điểm là cache chứa tất cả dữ liệu, ngay cả khi không cần thiết. Ngoài ra, mọi thao tác ghi sẽ tăng độ trễ vì dữ liệu cũng sẽ được ghi vào cache.
Global Redis Là Gì? Lợi Ích Của Global Redis
Hãy điều tra cách cải thiện hiệu suất cơ sở dữ liệu SQL thêm nữa.
Một nguồn khác của độ trễ là vị trí của cơ sở dữ liệu. Trong hầu hết các trường hợp, cơ sở dữ liệu chính nằm ở các khu vực cụ thể. Tuy nhiên, dữ liệu nên có thể truy cập ở vị trí gần nhất để chúng ta có thể giảm thiểu độ trễ do khoảng cách đến kho dữ liệu.
Vấn đề này có thể được ngăn chặn bằng cách sử dụng Redis phân bố toàn cầu, do Upstash cung cấp.
Global Redis là một giải pháp caching phân tán sao chép dữ liệu qua nhiều vị trí địa lý, đảm bảo truy cập độ trễ thấp cho các ứng dụng phân bố toàn cầu.
Hãy nhanh chóng xem cách tạo global Redis. Đầu tiên, đăng nhập vào bảng điều khiển Upstash.
Sau khi đăng nhập, chúng ta có thể tạo cơ sở dữ liệu Redis ở đây. Upstash cung cấp nhiều vị trí để đặt read replicas.
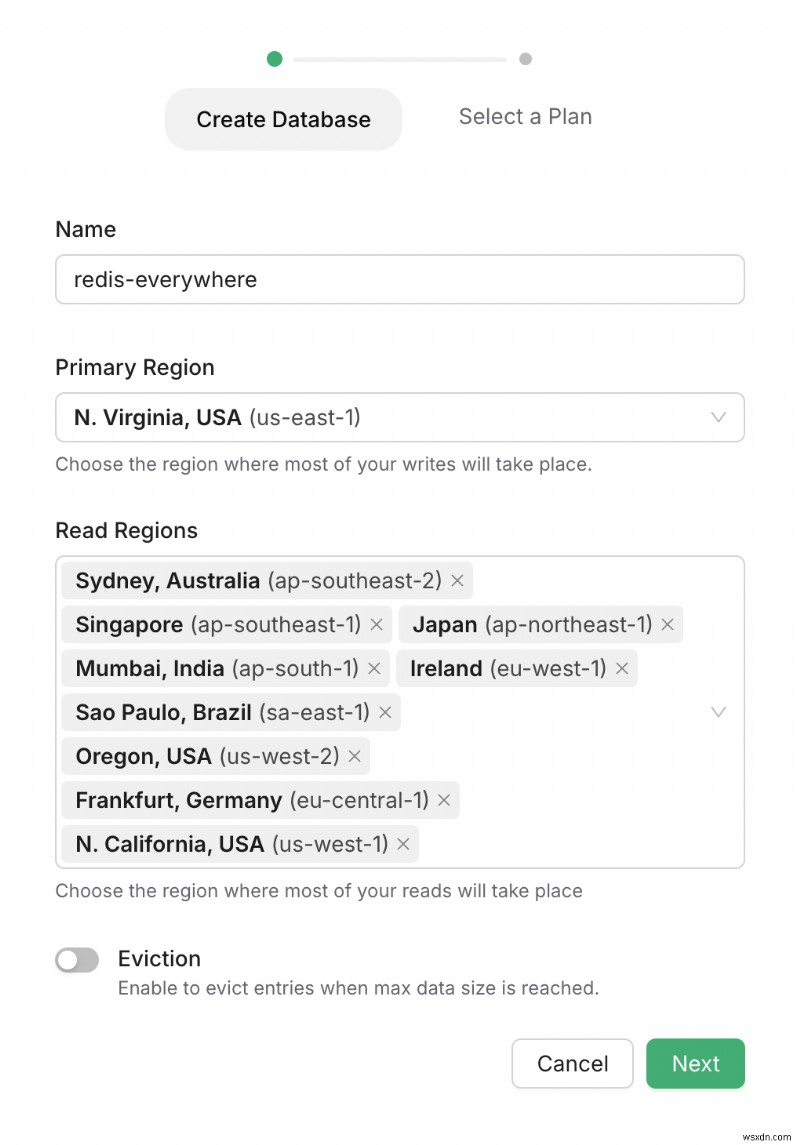
Sau khi chọn các vị trí đọc, bạn có thể chọn gói định giá và cuối cùng tạo cơ sở dữ liệu Redis. Đó là tất cả!
Trong bảng điều khiển, bạn có thể thêm/xóa các khu vực sau khi tạo cơ sở dữ liệu cũng được.
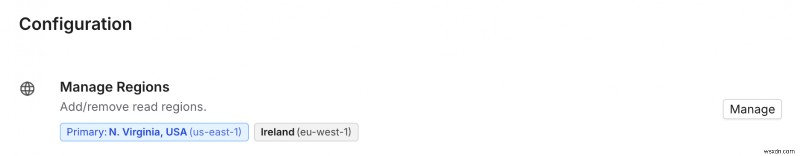
Cơ sở dữ liệu Redis toàn cầu chủ yếu được sử dụng bởi các ứng dụng phân bố toàn cầu và các ứng dụng chạy ở edge.
Độ trễ thấp cho ứng dụng phân bố toàn cầu
Trong các hệ thống phân tán toàn cầu, độ trễ thường trở thành nút thắt cổ chai do khoảng cách vật lý giữa người dùng và cơ sở dữ liệu hoặc cache trung tâm. Global Redis giải quyết điều này bằng cách sao chép dữ liệu qua nhiều node phân bố địa lý.
Khi người dùng yêu cầu dữ liệu, node cache gần nhất phục vụ yêu cầu, giảm đáng kể thời gian truyền mạng. Truy cập cục bộ này đảm bảo thời gian phản hồi nhanh hơn và trải nghiệm người dùng nhất quán, bất kể vị trí của người dùng.
Giả sử, nếu người dùng ở Tokyo, nhưng cơ sở dữ liệu ở Dublin, thì khoảng cách sẽ làm chậm phản hồi cho người dùng. Nếu có read replica của Upstash Redis ở Châu Âu, thì yêu cầu có thể được định tuyến đến read replica gần nhất, là cái ở Châu Âu trong trường hợp này.
Dữ liệu độ trễ thấp cho edge runtimes (ví dụ: Cloudflare Workers)
Edge runtimes là các môi trường được thiết kế để thực thi code ở rìa mạng, gần người dùng cuối. Edge runtimes phân phối logic ứng dụng qua nhiều vị trí edge trên toàn cầu. Kiến trúc này giảm thiểu khoảng cách vật lý giữa người dùng và việc thực thi yêu cầu của họ, giảm đáng kể độ trễ và cải thiện hiệu suất.
Mặc dù edge runtimes đưa tính toán gần người dùng hơn, chúng vẫn cần truy cập dữ liệu cho hầu hết các hoạt động, như truy xuất thông tin đặc thù người dùng, token session, hoặc cấu hình. Không có lớp caching, mỗi yêu cầu vẫn sẽ yêu cầu một round trip đến cơ sở dữ liệu trung tâm, bãi bỏ phần lớn lợi ích độ trễ. Đây là nơi Global Redis đóng vai trò quan trọng, vì chúng sao chép dữ liệu thường dùng đến edge, đảm bảo truy cập độ trễ thấp.
Ví Dụ Mã 1: PostgreSQL Với Node.js
Caching với global Redis là hoàn hảo. Bây giờ, chúng ta sẽ thấy một mẫu mã triển khai chiến lược cache-aside với Upstash Redis và cơ sở dữ liệu Postgresql.
Chúng ta nên trước tiên cài đặt SDKs mà chúng ta sẽ sử dụng để kết nối đến các kho dữ liệu.
npm install pg upstash/redis Một khi chúng ta đã cài đặt các phụ thuộc, sau đó chúng ta có thể kết nối đến các kho dữ liệu, Upstash Redis và Postgres.
const { Redis } = require('@upstash/redis'); // Upstash Redis SDK const { Client } = require('pg'); const redis = new Redis({ url: <UPSTASH_REDIS_REST_URL>, token: <UPSTASH_REDIS_REST_TOKEN>, }) const client = new Client({ user: 'username', password: 'password', host: 'host', port: 'port_number', database: 'database_name', }); client.connect();Bây giờ hãy viết hàm trong lớp truy cập dữ liệu của chúng ta. Hàm này có thể được sửa đổi theo nhu cầu của bạn.
Giả sử chúng ta muốn hiển thị thông tin người dùng trên trang web của mình bằng userId. Trong trường hợp này, chúng ta nên có một hàm nhận userId làm tham số
async function getUserData(userId) { // Check cache first const cachedData = await redis.get(userId); if (cachedData) { console.log('Cache hit'); return JSON.parse(cachedData); } // Fallback to database console.log('Cache miss'); const query = 'SELECT * FROM users WHERE id = $1'; const { rows } = await client.query(query, [userId]); await redis.set(userId, JSON.stringify(rows), { EX: 300 }); // Cache for 5 minutes return rows; }Xong! Bây giờ hàm này sẽ trước tiên kiểm tra xem thông tin người dùng có sẵn trong cơ sở dữ liệu Redis gần nhất với khu vực của người yêu cầu hay không. Nếu không có, nó sẽ truy vấn dữ liệu được yêu cầu từ cơ sở dữ liệu Postgresql và ghi dữ liệu trả về vào khu vực chính của Upstash Redis. Dữ liệu được ghi vào khu vực chính sẽ được sao chép tự động đến tất cả các read replicas.
Ví Dụ Mã 2: MYSQL Với Python
Bây giờ, hãy xem một ví dụ khác. Lần này, chúng ta sẽ làm cùng việc triển khai cache, nhưng cơ sở dữ liệu chính sẽ là MYSQL. Ngoài ra, chúng ta sẽ viết hàm này bằng Python để xem nó hoạt động như thế nào trong các ứng dụng dựa trên Python.
Như thường lệ, chúng ta sẽ tải xuống các phụ thuộc mà chúng ta sẽ sử dụng để kết nối cơ sở dữ liệu trước.
pip install upstash-redis upstash-redis Bây giờ, chúng ta có thể khởi tạo các client và kết nối chúng.
import upstash_redis import mysql.connector import json # Initialize Upstash Redis client redis_client = upstash_redis.Redis( url='<your-upstash-redis-url>', token='<your-upstash-token>' ) # Initialize MySQL client db = mysql.connector.connect( host="<your-mysql-host>", user="<your-mysql-user>", password="<your-mysql-password>", database="<your-database-name>" ) cursor = db.cursor(dictionary=True)Kết nối đã sẵn sàng. Bây giờ chúng ta sẽ triển khai hàm tương tự như chúng ta đã triển khai ở phần trước.
def get_user_data(userId): # Check the cache for the data cache_data = redis_client.get(key) if cache_data: print("Cache hit") return json.loads(cache_data) # If cache miss, query the MySQL database print("Cache miss") cursor.execute("SELECT * FROM users WHERE key = %s", (userId)) result = cursor.fetchone() if result: # Store the data in the cache with a TTL of 1 hour redis_client.set(key, json.dumps(result), ex=3600) return resultKết Luận
Bằng cách tích hợp Global Redis vào kiến trúc của bạn, bạn có thể đạt được những cải thiện hiệu suất đáng kể cho các ứng dụng dựa trên SQL, đặc biệt trong các môi trường phân bố toàn cầu. Với truy cập độ trễ thấp, giảm tải cơ sở dữ liệu, và tương thích với edge runtimes, Global Redis có thể giải quyết các thách thức hiệu suất của các ứng dụng với cơ sở dữ liệu SQL.
Trong bài blog này, chúng ta đã đi qua lợi ích của caching với global Redis và kiểm tra một số ví dụ. Những chỉ là các ví dụ cơ bản có thể được mở rộng thêm tùy thuộc vào nhu cầu của bạn.
Tôi hy vọng blog này có thể là khởi đầu tốt cho bạn để bắt đầu tận dụng sức mạnh của global Redis.