
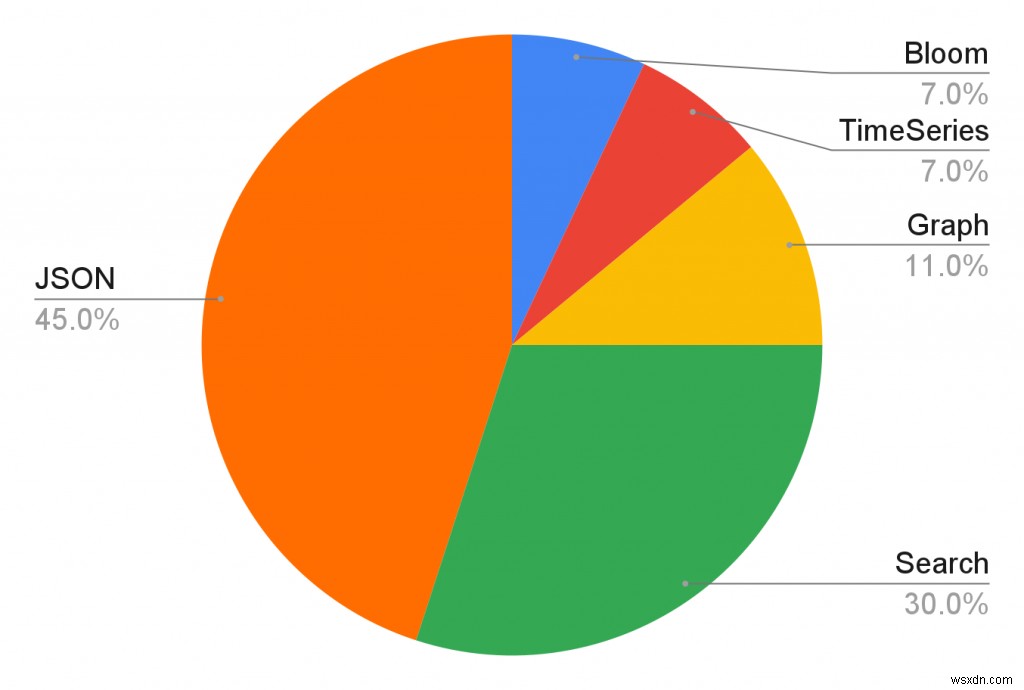
RedisJSON và RediSearch là hai module Redis phổ biến nhất trên đám mây của chúng tôi. (Xem Hình 1) Docker image của RedisJSON và RediSearch (đóng gói cùng Redis) được kéo (pull) hơn 2000 lần mỗi ngày. Đó là lý do chúng tôi coi Itamar Haber, nhà truyền giáo công nghệ tại Redis, là một visionary (người có tầm nhìn xa) khi ông viết phiên bản đầu tiên 4 năm trước. Vào tháng 4, chúng tôi đã công bố một số thông báo tại RedisConf liên quan đến JSON, lập chỉ mục và khả năng tìm kiếm toàn văn. Hôm nay, chúng tôi hân hạnh thông báo bản xem trước riêng tư (private preview) của các khả năng này.
Trong blog này, chúng tôi sẽ đưa ra tổng quan về khả năng RedisJSON hiện tại. Sau đó chúng tôi sẽ đi sâu vào phần khả năng mới của bản private preview này. Khả năng lập chỉ mục, truy vấn, và sử dụng tìm kiếm toàn văn trên tài liệu JSON bằng RediSearch là tính năng mới thú vị nhất của bản phát hành này. Cuối cùng, chúng tôi sẽ chỉ cho bạn cách bắt đầu nhanh chóng.
Khả năng JSON
Khi bạn không có RedisJSON, bạn mô hình hóa tài liệu lồng nhau trong Redis bằng cách sử dụng cấu trúc dữ liệu String.
Nhưng, nếu chúng ta cần cập nhật một phần con của tài liệu thì sao?
Để bảo toàn tính nguyên tử (atomicity) của hoạt động, chúng ta sẽ cần:
- WATCH tài liệu
- Đọc phiên bản trước và deserialize nó
- Nhúng cập nhật trong một transaction Redis
- Serialize thành JSON và cập nhật tài liệu
- Thực thi transaction
Chúng ta có thể cần thử lại tất cả các bước này nếu một client khác cập nhật tài liệu trong quá trình này.
Tuy nhiên, với RedisJSON, chúng ta có thể làm cập nhật này với một transaction nguyên tử duy nhất:
Hãy xem một ví dụ khác, nơi bạn có một JSON lớn, nhưng chỉ cần một phần con của tài liệu đó trong ứng dụng của bạn.
Không có RedisJSON:
Bạn phải:
- Truy xuất toàn bộ chuỗi JSON, được serialize dưới dạng chuỗi
- Deserialize JSON
- Trích xuất phần con bạn cần
Với RedisJSON, bạn có thể truy xuất chỉ dữ liệu bạn cần với một lệnh duy nhất, tối thiểu hóa chu kỳ CPU, chi phí mạng, và quan trọng nhất, độ trễ.
Như bạn thấy, RedisJSON đơn giản hóa thao tác tài liệu JSON. Phiên bản GA hiện tại của RedisJSON (v1.0) là phiên bản cộng đồng đã sử dụng rộng rãi và giải quyết chính xác những thiếu hụt của việc mô hình hóa cấu trúc lồng nhau với cấu trúc dữ liệu String. Dưới đây là tổng quan một số khả năng chính của nó.
Lưu trữ (hoặc cập nhật) một tài liệu JSON liên kết với một key trong Redis
Thay thế một phần con (ví dụ: giá trị chuỗi của một key)
Thêm một mục vào một collection hoặc một map
Trích xuất toàn bộ tài liệu
Trích xuất một phần của nó bằng một tập con của JSONPath
RedisJSON 2.0: Bản phát hành Private Preview
Chúng tôi đã công bố phiên bản này tại RedisConf 2021, và hôm nay chúng tôi hân hạnh thông báo rằng nó có sẵn dưới dạng private preview cho một nhóm khách hàng Redis Enterprise được chọn – và dưới dạng release candidate cho cộng đồng. Phiên bản này có ba tính năng chính, cụ thể là hỗ trợ đầy đủ biểu thức JSONPath, hỗ trợ Active-Active (với Redis Enterprise), và khả năng lập chỉ mục, truy vấn, và sử dụng tìm kiếm toàn văn trên tài liệu JSON với RediSearch. Nhưng còn nhiều hơn nữa! Hãy đi sâu vào những thứ tốt mới.
Viết lại bằng RUST
Ngôn ngữ lập trình hệ thống (System programming languages) là họ các ngôn ngữ hướng về hiệu suất. Chương trình viết bằng các ngôn ngữ này thường nhẹ và cung cấp hiệu suất tốt nhất. Đó là lý do Redis lịch sử được viết bằng C. Nó cũng giải thích tại sao Redis có thể đạt độ trễ cực thấp và thông lượng cao. Hầu hết các module Redis được viết bằng C, C++, hoặc Rust, những ngôn ngữ cùng họ.
JSON được phục vụ đặc biệt tốt bởi cộng đồng Rust bao gồm serialize JSON rất nhanh và hiệu quả và triển khai JSONPath. Việc mang lợi ích của những triển khai đó cho người dùng Redis là điều hiển nhiên và chỉ cần một mapping giữa Redis module API và Rust.
Hỗ trợ đầy đủ cho JSONPath
Và đây là lợi ích của việc viết lại bằng RUST. Phiên bản mới này bao gồm hỗ trợ toàn diện cho JSONPath. Bây giờ có thể sử dụng toàn bộ sự biểu đạt của các biểu thức JSONPath.
Cho một tài liệu JSON cho trước
Ký tự đại diện (Wildcards - trước đây giới hạn ở mục đầu tiên)
Trích xuất các slice
Một ví dụ nâng cao hơn với biểu thức lọc (filter expressions)
Hỗ trợ Active-Active
Active-Active là một tính năng do Redis Enterprise cung cấp. Active-Active cho phép bạn sao chép cơ sở dữ liệu của mình vào một vài cụm Redis Enterprise phân tán địa lý. Người dùng có thể kết nối đến cụm gần nhất với độ trễ đọc và ghi cục bộ.
Triển khai dựa trên công nghệ Conflict-free Replicated Data-Type (CRDT). Trong khi triển khai nó cho hầu hết các cấu trúc dữ liệu cốt lõi được Redis hỗ trợ, Redis đã phát triển kiến thức và kinh nghiệm mạnh mẽ được xác nhận bởi triển khai mới này cho JSON.
Các nhà phát triển ứng dụng bây giờ có thể dựa vào điều này để xây dựng các ứng dụng phân tán địa lý sử dụng tài liệu JSON. Đây là ví dụ về một chuỗi hoạt động trong môi trường active-active với hai cụm:
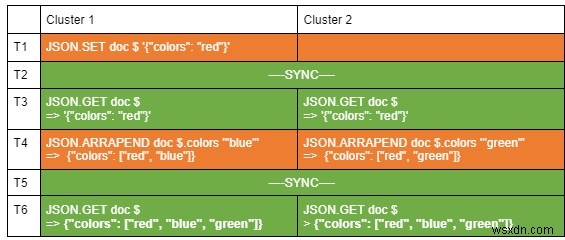
Hãy xem chi tiết từng hoạt động:
- T1: Một client đặt một tài liệu JSON trên Cụm 1.
- T2: Quy trình đồng bộ sao chép tài liệu trên Cụm 2.
- T3: Cả hai cụm chứa cùng một tài liệu.
- T4: Một client thêm màu xanh dương vào mảng colors trên Cụm 1, và đồng thời, một client khác thêm màu xanh lá vào cùng mảng đó trên Cụm 2.
- T5: Quy trình đồng bộ hợp nhất hoạt động và cập nhật tài liệu trên cả hai cụm.
- T6: Cả hai cụm chứa cùng một tài liệu.
Chúng tôi sẽ giải thích thêm về tất cả các luồng đồng bộ khi khả năng này ở Public Preview, nhưng nếu bạn quan tâm đến khả năng này, đừng ngần ngại liên hệ ngay tại support@redis.com.
RediSearch 2.2: Bản phát hành Private Preview
Blog này cũng công bố sự có sẵn của private preview cho RediSearch 2.2 (là private preview cho một nhóm khách hàng Redis Enterprise được chọn và release candidate cho cộng đồng).
Trong phần này chúng tôi sẽ mô tả các tính năng mới do bản phát hành mới của RediSearch cung cấp. Nhưng trước tiên, đây là lý do tại sao chúng tôi phát hành hai module phổ biến này cùng nhau:
Lập chỉ mục, truy vấn, và tìm kiếm toàn văn tài liệu JSON
Tính năng mới đặc biệt này sẽ đưa khả năng JSON của Redis lên một tầm cao hoàn toàn mới. Vượt ra khỏi việc chỉ là một kho Key-Value, cho đến nay, RediSearch đã cung cấp khả năng lập chỉ mục và tìm kiếm trên hashes. Bên dưới, RedisJSON 2.0 lộ ra một API công khai nội bộ. Nội bộ, vì API này được lộ ra cho các module khác chạy bên trong một node Redis. Công khai, vì bất kỳ module nào cũng có thể tiêu thụ API này. RediSearch 2.2 cũng vậy!
Bằng cách lộ khả năng của mình cho các module khác, RedisJSON cho RediSearch khả năng lập chỉ mục tài liệu JSON để người dùng bây giờ có thể tìm tài liệu bằng cách lập chỉ mục và truy vấn nội dung. Các module kết hợp này cho bạn một cơ sở dữ liệu tài liệu hướng JSON mạnh mẽ, độ trễ thấp!
Hãy xem nó trông như thế nào.
Chúng ta nên trước tiên điền cơ sở dữ liệu với một tài liệu JSON sử dụng lệnh JSON.SET.
Để tạo một chỉ mục mới, chúng ta dùng lệnh FT.CREATE. Schema của chỉ mục bây giờ chấp nhận biểu thức JSONPath. Kết quả của biểu thức được lập chỉ mục và liên kết với một thuộc tính (ở đây: title).
Chúng ta bây giờ có thể làm truy vấn tìm kiếm và tìm tài liệu JSON của chúng ta dùng FT.SEARCH:
Tổng hợp (Aggregation) trên tài liệu JSON
Tổng hợp là một tính năng mạnh mẽ của RediSearch có thể dùng để tạo báo cáo phân tích hoặc thực hiện truy vấn kiểu faceted search. Bây giờ RediSearch có thể truy cập tài liệu JSON, có thể tải bất kỳ giá trị nào từ tài liệu JSON dùng biểu thức JSONPath và dùng nó trong một pipeline dù giá trị đó có được lập chỉ mục hay không.
Hãy tạo một chỉ mục:
Thêm một tài liệu JSON vào cơ sở dữ liệu:
Và làm một phép tính đơn giản sử dụng hai giá trị số trích xuất từ tài liệu JSON:
Linh hoạt hơn về chiến lược lập chỉ mục
Với phiên bản mới của RediSearch, bây giờ có thể lập chỉ mục cùng một giá trị (trường trên hashes, hoặc giá trị JSON từ tài liệu JSON) với các tham số khác nhau. Đây là một trường hợp sử dụng điển hình, được giải quyết bởi tính năng mới này:
Hãy có một cơ sở dữ liệu chứa tài liệu thuộc các danh mục.
Sử dụng kiểu TAG bạn có thể dễ dàng lọc kết quả tìm kiếm trên bất kỳ danh mục nào:
Nhưng nếu bạn cũng muốn làm tìm kiếm toàn văn trên danh mục thì sao?
Cho đến nay, với hashes, bạn phải nhân đôi giá trị vào hai trường, điều này sẽ tiêu tốn gấp đôi bộ nhớ.
Đây là nơi FT.CREATE…AS trở nên rất tiện lợi. Hãy quay lại tài liệu đơn giản và tốt của chúng ta:
…và sử dụng tính năng AS mới:
…và…
Bingo! Chúng ta bây giờ có thể lọc bằng tag, và làm tìm kiếm toàn văn trên cùng một trường, mà không cần nhân đôi dữ liệu.
Hồ sơ truy vấn (Query profiling)
Độ phức tạp thời gian của hầu hết các lệnh Redis được tài liệu hóa tốt. Ví dụ, HMGET đi kèm độ phức tạp O(N), "trong đó N là số trường được yêu cầu." Với RediSearch, có thể viết các truy vấn nâng cao. Độ phức tạp của lệnh FT.SEARCH và FT.AGGREGATE, tuy nhiên, phụ thuộc vào độ phức tạp của truy vấn.
Chúng tôi muốn cung cấp cho bạn công cụ để hiểu những gì xảy ra bên dưới khi một truy vấn được thực hiện, để tìm ra nơi thời gian bị tiêu tốn, và cách truy vấn có thể được tối ưu. Lệnh FT.PROFILE mới trả về một cây hiển thị các bước chính RediSearch dùng để thực thi truy vấn. Cho mỗi bước, thông tin thời gian được đưa ra.
Vậy bên trong RediSearch xảy ra gì khi chúng ta làm truy vấn với tìm kiếm mờ (fuzzy search)?
Hãy xem ví dụ:
Chúng ta sẵn sàng để profile truy vấn của mình. Hãy chạy profiling và phân tích kết quả profiling.
redis.cloud:6379> FT.PROFILE idx SEARCH LIMITED QUERY "%hello%"
Trước tiên chúng ta lấy kết quả. Hữu ích để kiểm tra truy vấn profiling có trả về điều mong đợi không.
Đây là tổng thời gian, gọi là "profile time", vì nó bao gồm thời gian dùng để thu thập thông tin profile.
Thời gian dùng để parse truy vấn và xây dựng kế hoạch thực thi:
Đây là thời gian dùng để tìm các khớp mờ trong từ điển:
Và cuối cùng, bạn có bao giờ tự hỏi xây dựng kết quả tìm kiếm có nghĩa là gì? Chúng ta cần tính điểm toàn văn cho mỗi tài liệu, sắp xếp theo điểm, và cuối cùng tải các trường. Với thông tin này bạn có thể xác định bottleneck, làm truy vấn nhanh hơn, và cải thiện hiệu suất server.
Cách bắt đầu
Chúng tôi tin rằng các khả năng mới này là game changer cho các nhà phát triển ứng dụng và cộng đồng Redis. Đây là cách bạn bắt đầu.
Sử dụng docker image của bản preview
Để bắt đầu bạn có thể pull docker image sau với tag :preview:
docker run -p 6379:6379 redis/redismod:previewThay vào đó, bạn có thể compile từ các tag RC1 (v2.2.0 cho RediSearch, v2.0.0 cho RedisJSON) trên cả hai kho và nạp chúng vào Redis.
Khi bạn đã chạy, bạn có thể thử tất cả các lệnh trên hoặc với hướng dẫn quickstart này. Chúng tôi cũng sẽ ra mắt một chuỗi blog về RedisMart, một ứng dụng bán lẻ trực tuyến mà chúng tôi trình diễn trong keynote RedisConf 2021. RedisMart tận dụng RediSearch và RedisJSON triển khai theo cách phân tán địa lý để mang lại trải nghiệm bán lẻ trực tuyến tốt nhất. Trong chuỗi này, chúng tôi sẽ hướng dẫn bạn từng bước cách chúng tôi xây dựng ứng dụng này.
Phát triển sử dụng các phiên bản mới nhất của client tương thích
Danh sách client sau đang được nâng cấp để bạn có thể dùng các tính năng mới với trải nghiệm nhà phát triển tốt. Kiểm tra các bản phát hành mới nhất và/hoặc pull requests (lúc này hầu hết chúng hỗ trợ phiên bản preview trên nhánh master).
| RedisJSON | RediSearch | |
| Node.js | redis-modules-sdk | redis-modules-sdk |
| Java | JredisJSON | JRediSearch |
| .NET | NRedisJSON | NRediSearch |
| Python | redisjson-py | redisearch-py |
Tham gia cộng đồng
Chúng tôi chào đón mọi phản hồi, báo lỗi, yêu cầu tính năng trong khi chúng tôi làm việc tới General Availability. Để phản hồi trên trang web tài liệu hoặc trong kho GitHub của RediSearch (trên Github) hoặc RedisJSON (trên Github), hoặc liên hệ với chúng tôi trên Discord.