
Redis là công nghệ nền tảng (bedrock technology), nên đôi khi có người cân nhắc kiến trúc thay thế. Vài năm trước, KeyDB đưa ra vấn đề này, và gần đây dự án mới Dragonfly tuyên bố là datastore in-memory tương thích Redis nhanh nhất. Chúng tôi tin rằng các dự án này mang lại nhiều công nghệ và ý tưởng thú vị đáng thảo luận và tranh luận. Tại Redis, chúng tôi thích thách thức này, vì nó yêu cầu chúng tôi khẳng định lại các nguyên tắc kiến trúc mà Redis được thiết kế ban đầu (cảm ơn Salvatore Sanfilippo aka antirez).
Mặc dù chúng tôi luôn tìm cơ hội đổi mới và nâng cao hiệu suất, khả năng của Redis, chúng tôi muốn chia sẻ góc nhìn và suy ngẫm về lý do kiến trúc Redis vẫn là best-in-class cho datastore in-memory, thời gian thực (cache, database, và mọi thứ giữa đó).
Trong các phần tiếp theo, chúng tôi nêu góc nhìn về tốc độ và khác biệt kiến trúc liên quan đến các so sánh đang diễn ra. Cuối bài, chúng tôi cũng cung cấp chi tiết benchmark và so sánh hiệu suất so với dự án Dragonfly, mời bạn xem lại và tự tái hiện.
Tốc Độ
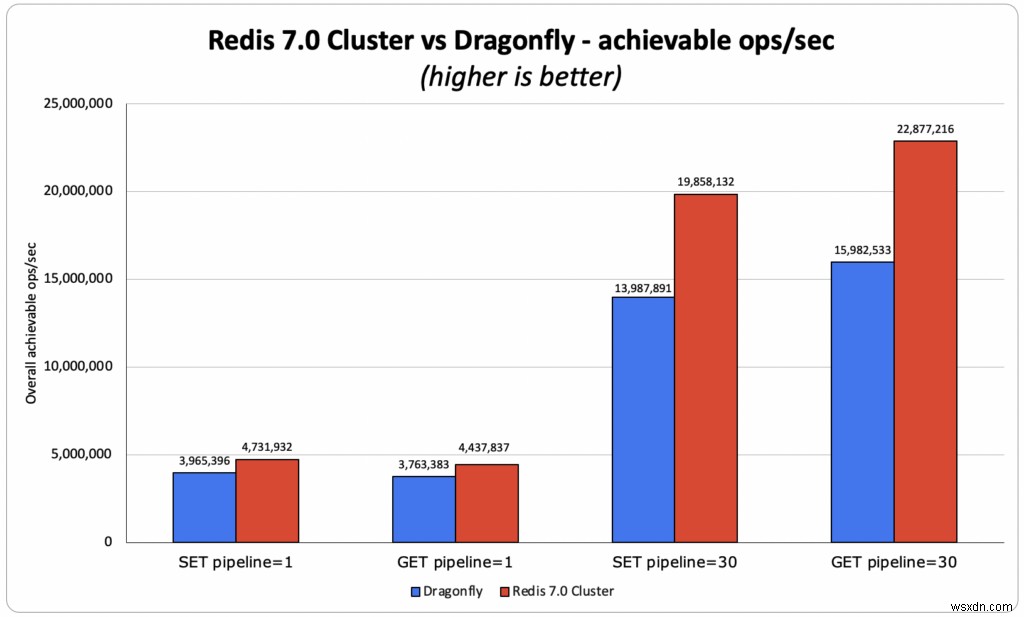
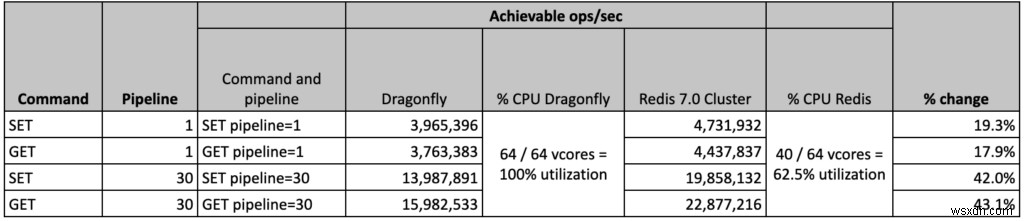
Benchmark của Dragonfly so sánh instance Redis đơn tiến trình (chỉ dùng một core) với instance Dragonfly đa luồng (dùng tất cả core trên VM/server). Thật không may, so sánh này không phản ánh cách Redis chạy trong thực tế. Là những người xây dựng công nghệ, chúng tôi nỗ lực hiểu chính xác công nghệ của mình so với người khác, nên chúng tôi làm so sánh công bằng: cụm Redis 7.0 Cluster 40 shard (có thể dùng hầu hết core instance) với Dragonfly, dùng bộ test hiệu suất trên loại instance lớn nhất Dragonfly dùng trong benchmark của họ, AWS c6gn.16xlarge. Trong thử nghiệm, Redis đạt throughput cao hơn 18% – 40% so với Dragonfly, ngay cả khi chỉ dùng 40 trong 64 vCores.
Khác Biệt Kiến Trúc
Một Chút Bối Cảnh
Chúng tôi tin rằng nhiều quyết định kiến trúc của các tác giả dự án đa luồng bị ảnh hưởng bởi nỗi đau (pain points) họ trải qua trong công việc trước. Chúng tôi đồng ý rằng chạy một tiến trình Redis đơn lẻ trên máy đa core, đôi khi với chục core và trăm GB bộ nhớ, không tận dụng được tài nguyên có sẵn. Nhưng đây không phải cách Redis được thiết kế để dùng; đây chỉ là cách nhiều nhà cung cấp Redis chọn chạy dịch vụ của họ.
Redis mở rộng ngang (horizontally) bằng cách chạy nhiều tiến trình (multi-processes) dùng Redis Cluster ngay cả trong ngữ cảnh một instance đám mây đơn lẻ. Tại Redis (công ty), chúng tôi phát triển thêm khái niệm này và xây dựng Redis Enterprise cung cấp lớp quản lý cho phép người dùng chạy Redis ở quy mô lớn, với high availability, failover tức thì, bền bỉ dữ liệu, và backup bật mặc định.
Chúng tôi quyết định chia sẻ một số nguyên tắc đằng sau hậu trường để giúp mọi người hiểu những gì chúng tôi tin là thực hành kỹ thuật tốt để chạy Redis trong môi trường production.
Nguyên Tắc Kiến Trúc
Chạy Nhiều Instance Redis Trên Mỗi VM
Chạy nhiều instance Redis trên mỗi VM cho phép:
- Mở rộng tuyến tính, cả dọc (vertically) và ngang (horizontally), dùng kiến trúc shared-nothing hoàn toàn. Điều này luôn cung cấp sự linh hoạt hơn so với kiến trúc đa luồng chỉ mở rộng dọc.
- Tăng tốc độ sao chép (replication), vì replication diễn ra song song qua nhiều tiến trình.
- Khôi phục nhanh từ lỗi VM, do instance Redis của VM mới sẽ được điền dữ liệu từ nhiều instance Redis bên ngoài cùng lúc.
Giới Hạn Mỗi Tiến Trình Redis Ở Kích Thước Hợp Lý
Chúng tôi không cho phép một tiến trình Redis đơn lẻ lớn hơn 25 GB (và 50 GB khi chạy Redis on Flash). Điều này cho phép:
- Tận hưởng lợi ích copy-on-write mà không trả giá penanlty bộ nhớ lớn khi fork Redis cho replication, snapshot, và Append Only File (AOF) rewrite. Và "có" – nếu không làm vậy, bạn (hoặc người dùng) sẽ trả giá cao, như minh chứng tại đây.
Mở Rộng Ngang Là Quan Trọng Nhất
Sự linh hoạt chạy datastore in-memory với mở rộng ngang cực kỳ quan trọng. Dưới đây là một vài lý do:
- Khả năng phục hồi tốt hơn (Better resiliency) – càng nhiều node trong cụm, cụm càng bền vững. Ví dụ: chạy dataset trên cụm 3 node, một node degraded là 1/3 cụm không perform; nhưng cụm 9 node, một node degraded chỉ 1/9 cụm không perform.
- Dễ mở rộng hơn (Easier to scale) – dễ dàng thêm node vào cụm và di chuyển chỉ một phần dataset, thay vì scale dọc phải mang node lớn hơn và copy toàn bộ dataset (và nghĩ đến mọi chuyện xấu có thể xảy ra trong quá trình này tiềm ẩn dài...)
- Mở rộng dần dần hiệu quả chi phí hơn (Gradually scaling is much more cost-effective) – scale dọc, đặc biệt trên đám mây, đắt đỏ. Nhiều trường hợp phải gấp đôi kích thước instance ngay cả khi chỉ cần thêm vài GB cho dataset.
- Throughput cao (High throughput) – tại Redis, nhiều khách hàng chạy workload throughput cao trên dataset nhỏ, với băng thông mạng cao và/hoặc packet per second (PPS) cao. Ví dụ: dataset 1GB với 1M+ ops/sec. Có lý do chạy trên cụm single-node c6gn.16xlarge (128GB, 64 CPU, 100Gbps, $2.7684/hr) thay vì cụm 3-node c6gn.xlarge (8GB, 4 CPU, lên tới 25Gbps, $0.1786/hr mỗi node) với chi phí dưới 20% và bền vững hơn nhiều? Khả năng tăng throughput đồng thời giữ chi phí hiệu quả và cải thiện resiliency似乎是个简单的答案。
- Thực tế của NUMA – scale dọc cũng nghĩa là chạy server hai socket với nhiều core và DRAM lớn; kiến trúc dựa trên NUMA này tuyệt vời cho kiến trúc đa tiến trình như Redis vì hành xử giống mạng các node nhỏ hơn. Nhưng NUMA thách thức hơn cho kiến trúc đa luồng, và từ kinh nghiệm với các dự án đa luồng khác, NUMA có thể giảm hiệu suất datastore in-memory tới 80%.
- Giới hạn throughput lưu trữ (Storage throughput limits) – đĩa ngoài như AWS EBS không scale nhanh như bộ nhớ và CPU. Thực tế, có giới hạn throughput lưu trữ do nhà cung cấp đám mây áp dụng dựa trên lớp máy. Do đó, cách duy nhất để scale cụm hiệu quả tránh các vấn đề trên và đáp ứng yêu cầu bền bỉ dữ liệu cao là mở rộng ngang, tức là thêm node và đĩa gắn mạng.
- Đĩaéphemeral (Ephemeral disks) – đĩa ephemeral là cách tuyệt vời chạy Redis trên SSD (SSD dùng thay DRAM, không phải lưu trữ bền vững) và tận hưởng chi phí database dựa trên đĩa nhưng vẫn giữ tốc độ Redis (xem cách chúng tôi làm với Redis on Flash). Lại nữa, khi đĩa ephemeral đạt giới hạn, cách tốt nhất và nhiều trường hợp là cách duy nhất để scale cụm là thêm node và thêm đĩa ephemeral.
- Phần cứng phổ thông (Commodity hardware) – cuối cùng, nhiều khách hàng on-premises chạy ở trung tâm dữ liệu local, private cloud, thậm chí edge data centers nhỏ; trong môi trường này, khó tìm máy với hơn 64 GB RAM và 8 CPU, và lại lần nữa cách duy nhất để scale là ngang.
Tóm Tắt
Chúng tôi trân trọng ý tưởng mới, thú vị từ cộng đồng như làn sóng dự án đa luồng mới. Có thể một số khái niệm này sẽ tìm đường vào Redis trong tương lai (như io_uring mà chúng tôi đã bắt đầu xem xét, dictionary hiện đại hơn, sử dụng luồng chiến thuật hơn, v.v.). Nhưng trong tương lai gần, chúng tôi sẽ không bỏ qua nguyên tắc cơ bản của kiến trúc multi-process, shared-nothing mà Redis cung cấp. Thiết kế này mang lại hiệu suất, scaling, và resiliency tốt nhất đồng thời hỗ trợ nhiều kiến trúc triển khai cần thiết cho nền tảng dữ liệu thời gian thực in-memory.
Phụ Lục: Chi Tiết Benchmark Redis 7.0 vs Dragonfly
Tóm Tắt Benchmark
Phiên bản:
- Redis 7.0.0 build từ source
- Dragonfly build từ source ngày 3 tháng 6 (hash=e806e6ccd8c79e002f721a1a5ecb847bd7a06489) theo khuyến nghị tại https://github.com/Dragonfly/dragonfly#building-from-source
Mục tiêu:
- Xác minh kết quả Dragonfly có tái hiện được và xác định điều kiện đầy đủ chúng được lấy (vì thiếu một số config trên memtier_benchmark, phiên bản OS, v.v.)
- Xác định hiệu suất tốt nhất có thể của OSS Redis 7.0.0 Cluster trên AWS c6gn.16xlarge, khớp benchmark Dragonfly
Cấu hình client:
- Giải pháp OSS Redis 7.0 cần số lượng kết nối mở lớn hơn đến Redis Cluster, vì mỗi thread memtier_benchmark kết nối đến tất cả shard
- Giải pháp OSS Redis 7.0 cho kết quả tốt nhất với hai tiến trình memtier_benchmark chạy benchmark nhưng trên cùng client VM (để khớp benchmark Dragonfly)
Sử dụng tài nguyên và cấu hình tối ưu:
- Cụm OSS Redis đạt kết quả tốt nhất với 40 primary shard, nghĩa là còn 24 vCPUs rảnh trên VM. Mặc dù máy chưa được dùng hết, chúng tôi thấy tăng số shard không giúp mà giảm hiệu suất tổng thể. Chúng tôi vẫn đang điều tra hành vi này.
- Giải pháp Dragonfly dùng hết VM với tất cả 64 VCPUs đạt 100% utilization.
- Cả hai giải pháp, chúng tôi thay đổi cấu hình client để đạt kết quả tốt nhất có thể. Như thấy dưới đây, chúng tôi tái hiện được phần lớn dữ liệu Dragonfly và thậm chí vượt qua kết quả tốt nhất cho pipeline = 30.
- Điều này có nghĩa là tiềm năng tăng thêm số liệu chúng tôi đạt được với Redis.
Cuối cùng, cả Redis và Dragonfly đều không bị giới hạn bởi network PPS hay bandwidth, vì chúng tôi xác nhận giữa 2 VM dùng (client và server, đều c6gn.16xlarge) có thể đạt >10M PPS và >30 Gbps cho TCP với payload ~300B.
Phân Tích Kết Quả
- GET pipeline 1 sub-ms:
- OSS Redis: 4.43M ops/sec, cả avg và p50 đạt sub-millisecond latency. Avg client latency 0.383 ms
- Dragonfly tuyên bố 4M ops/sec:
- Chúng tôi tái hiện 3.8M ops/sec, avg client latency 0.390 ms
- Redis vs Dragonfly – Redis throughput cao hơn 10% so với kết quả Dragonfly tuyên bố và 18% so với kết quả Dragonfly chúng tôi tái hiện.
- GET pipeline 30:
- OSS Redis: 22.9M ops/sec, avg client latency 2.239 ms
- Dragonfly tuyên bố 15M ops/sec:
- Chúng tôi tái hiện 15.9M ops/sec, avg client latency 3.99 ms
- Redis vs Dragonfly – Redis tốt hơn 43% (so với kết quả Dragonfly tái hiện) và 52% (so với kết quả Dragonfly tuyên bố)
- SET pipeline 1 sub-ms:
- OSS Redis: 4.74M ops/sec, cả avg và p50 sub-millisecond. Avg client latency 0.391 ms
- Dragonfly tuyên bố 4M ops/sec:
- Chúng tôi tái hiện 4M ops/sec, avg client latency 0.500 ms
- Redis vs Dragonfly – Redis tốt hơn 19% (chúng tôi tái hiện cùng kết quả Dragonfly tuyên bố)
- SET pipeline 30:
- OSS Redis: 19.85M ops/sec, avg client latency 2.879 ms
- Dragonfly tuyên bố 10M ops/sec:
- Chúng tôi tái hiện 14M ops/sec, avg client latency 4.203 ms
- Redis vs Dragonfly – Redis tốt hơn 42% (so với Dragonfly tái hiện) và 99% (so với Dragonfly tuyên bố)
Lệnh memtier_benchmark dùng cho từng biến thể:
- GET pipeline 1 sub-ms
- Redis: 2X: memtier_benchmark –ratio 0:1 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram
- Dragonfly: memtier_benchmark –ratio 0:1 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram
- GET pipeline 30
- Redis: 2X: memtier_benchmark –ratio 0:1 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram –pipeline 30
- Dragonfly: memtier_benchmark –ratio 0:1 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram –pipeline 30
- SET pipeline 1 sub-ms
- Redis: 2X: memtier_benchmark –ratio 1:0 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram
- Dragonfly: memtier_benchmark –ratio 1:0 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram
- SET pipeline 30
- Redis: 2X: memtier_benchmark –ratio 1:0 -t 24 -c 1 –test-time 180 –distinct-client-seed -d 256 –cluster-mode -s 10.3.1.88 –port 30001 –key-maximum 1000000 –hide-histogram –pipeline 30
- Dragonfly: memtier_benchmark –ratio 1:0 -t 55 -c 30 -n 200000 –distinct-client-seed -d 256 -s 10.3.1.6 –key-maximum 1000000 –hide-histogram –pipeline 30
Chi Tiết Hạ Tầng
Chúng tôi dùng cùng loại VM cho cả client (chạy memtier_benchmark) và server (chạy Redis và Dragonfly), spec:
- VM:
- AWS c6gn.16xlarge
- aarch64
- ARM Neoverse-N1
- Core(s) per socket: 64
- Thread(s) per core: 1
- NUMA node(s): 1
- AWS c6gn.16xlarge
- Kernel: Arm64 Kernel 5.10
- Bộ nhớ cài đặt: 126GB