
Trong các bài trước, bạn đã biết sơ lược về SQL Server, cách cài đặt SQL Server trên máy tính. Phần này chúng ta sẽ tìm hiểu về kiến trúc của SQL Server.
Chúng ta sẽ chia kiến trúc SQL Server thành các phần sau để dễ hiểu hơn:
- Kiến trúc chung - General Architecture
- Kiến trúc bộ nhớ - Memory Architecture
- Kiến trúc file dữ liệu - Data File Architecture
- Kiến trúc file log - Log File Architecture
Bây giờ chúng ta sẽ đi vào chi tiết từng loại kiến trúc SQL Server được phân loại ở trên.
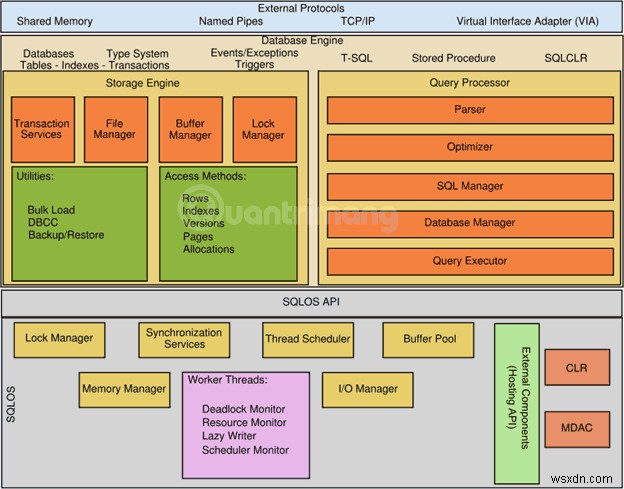
Kiến trúc chung - General Architecture
- Client: Nơi yêu cầu được thực hiện.
- Query: Truy vấn SQL là ngôn ngữ cấp cao.
- Logical Units: Từ khóa, biểu thức, toán tử, v.v.
- N/W Packets: Mã liên quan đến mạng.
- Protocols: Trong SQL Server có 4 giao thức:
- Shared memory: Dùng cho kết nối cục bộ và mục đích troubleshooting.
- Named pipes: Dùng cho kết nối trên LAN.
- TCP/IP: Dùng cho kết nối WAN.
- VIA - Virtual Interface Adapter: Yêu cầu phần cứng đặc biệt do nhà cung cấp thiết lập và không được hỗ trợ từ phiên bản SQL 2012.
- Server: Nơi SQL Services được cài đặt và có cơ sở dữ liệu.
- Relational Engine (Bộ máy quan hệ): Nơi thực thi thực sự diễn ra. Chứa Query Parser, Query Optimizer và Query Runtime.
- Query Parser (Bộ phân tích cú pháp) và Compiler (Bộ dịch): Hai thành phần này chịu trách nhiệm kiểm tra cú pháp truy vấn và chuyển đổi truy vấn sang ngôn ngữ máy.
- Query Optimizer: Chuẩn bị đầu ra là Execution Plan bằng cách nhận đầu vào là truy vấn, thống kê và cây Algebrizer.
- Execution Plan (Kế hoạch thực thi): Giống như bản đồ đường, chứa thứ tự các bước được thực hiện như một phần của việc thực thi truy vấn.
- Query Executor (Bộ thực thi truy vấn): Nơi truy vấn được thực thi từng bước, với sự giúp đỡ của Execution Plan và cũng nơi Storage Engine sẽ được liên hệ.
- Storage Engine (Bộ máy lưu trữ): Chịu trách nhiệm lưu trữ và truy xuất dữ liệu trong hệ thống lưu trữ (ổ cứng, SAN, v.v.), thao tác dữ liệu, khóa và quản lý giao dịch.
- SQL OS: Nằm giữa máy chủ (Windows OS) và SQL Server. Tất cả các thao tác được thực hiện trên database engine được "chăm sóc" bởi SQL OS. SQL OS cung cấp các dịch vụ hệ điều hành khác nhau, như quản lý bộ nhớ với buffer pool, log buffer, phát hiện deadlock, sử dụng cấu trúc block và lock.
- Checkpoint: Checkpoint là quá trình nội bộ, ghi tất cả các trang đã sửa đổi (gọi là Dirty Page) từ Buffer Cache ra ổ cứng vật lý. Ngoài ra, nó cũng ghi log từ Log Buffer ra file vật lý. Việc ghi Dirty Pages vào ổ cứng còn được gọi là Hardening of dirty pages.
- Lazy Writer: Lazy Writer sẽ đẩy Dirty Pages ra ổ cứng vì một lý do hoàn toàn khác, là để giải phóng bộ nhớ trong Buffer Pool. Điều này xảy ra khi SQL Server đang thiếu bộ nhớ. Quy trình này được điều khiển bởi quá trình nội bộ và không có cài đặt cho nó.
SQL Server liên tục theo dõi việc sử dụng bộ nhớ để đánh giá sự sẵn có và cạnh tranh tài nguyên, đảm bảo luôn có một lượng không gian trống nhất định. Khi phát hiện xung đột tài nguyên, nó sẽ kích hoạt Lazy Writer để di chuyển một số Dirty Page vào ổ cứng và giải phóng bộ nhớ. Nó sử dụng thuật toán Least Recently Used (LRU) để xác định trang nào sẽ được đẩy ra ổ cứng. Nếu Lazy Writer luôn hoạt động, nó có thể tạo ra nút cổ chai về bộ nhớ.
Kiến trúc bộ nhớ - Memory Architecture
Dưới đây là các đặc điểm nổi bật của kiến trúc bộ nhớ:
- Một trong những mục tiêu thiết kế cơ bản của tất cả phần mềm cơ sở dữ liệu là giảm thiểu disk I/O vì quá trình đọc/ghi đĩa là một trong những hành động tốn tài nguyên nhất.
- Bộ nhớ nội bộ Windows có thể gọi là Virtual Address Space, được chia sẻ bởi Kernel mode (chế độ OS) và User mode (ứng dụng như SQL Server).
- Không gian địa chỉ người dùng của SQL Server được chia thành hai phần: MemToLeave và Buffer Pool.
- Kích thước của MemToLeave (MTL) và Buffer Pool (BPool) được quyết định bởi SQL Server trong quá trình khởi động.
- Buffer Management là thành phần quan trọng nếu bạn muốn đạt hiệu suất I/O cao. Nó bao gồm hai cơ chế: Buffer Manager để truy cập và cập nhật cơ sở dữ liệu và các trang Buffer Pool để cắt file I/O vào cơ sở dữ liệu.
- Buffer Pool được chia thành một số phần, quan trọng nhất là Buffer Cache và Procedure Cache. Buffer Cache giữ các trang dữ liệu trong bộ nhớ để dữ liệu thường xuyên truy cập có thể trích xuất từ cache. Quy trình thay thế sẽ đọc các trang dữ liệu từ ổ cứng. Đọc dữ liệu từ cache tối ưu hóa hiệu suất bằng cách giảm thiểu số lượng hoạt động I/O, chậm hơn so với truy cập dữ liệu từ bộ nhớ.
- Procedure cache giữ các stored procedure và execution plan để tối ưu hóa số lần tạo execution plan. Bạn có thể tìm thông tin về dung lượng và hoạt động trong Procedure Cache bằng lệnh DBCC PROCCACHE.
- Các phần khác của Buffer Pool bao gồm:
- System-level data structures: Chứa dữ liệu cấp Instance về databases và locks.
- Log Cache: Dành riêng cho đọc và ghi các trang giao dịch.
- Connection Context: Mỗi kết nối với Instance có một vùng nhớ nhỏ để ghi trạng thái hiện tại của kết nối. Thông tin này bao gồm tham số stored procedure và user-defined function, vị trí con trỏ chuột và hơn thế nữa.
- Stack Space: Windows cấp phát stack space cho mỗi thread bắt đầu với SQL Server.
Kiến trúc file dữ liệu - Data File Architecture
Kiến trúc này có các thành phần sau:
File Group (Nhóm file)
Các file database có thể được gom nhóm lại thành file groups cho mục đích phân phối và quản lý. Một file chỉ có thể là thành viên của một file group. Log file không thể gom nhóm vào File Group vì kích thước log file được quản lý riêng biệt với dữ liệu.
Có hai loại File Group trong SQL Server là Primary và User-defined. Primary chứa các file dữ liệu chính và bất kỳ file nào không được gán cụ thể cho File Group. Tất cả các trang cho system table được cấp phát trong Primary. User-defined là các file group do người dùng định nghĩa, được chỉ định bằng cách sử dụng từ khóa filegroup trong lệnh tạo database hoặc alter database.
Một File Group trong mỗi database đóng vai trò là default file group. Khi SQL Server gán một trang cho bảng hoặc index (không thuộc File Group nào khi tạo), trang đó sẽ nằm trong default file group. Để chuyển default file group từ File Group này sang File Group khác, cần quyền db_owner fixed database role.
Primary là default file group. Người dùng cần có db_owner fixed database role để backup các file và file group riêng lẻ.
File (Tệp tin)
Cơ sở dữ liệu có 3 loại file: Primary (file dữ liệu chính), Secondary (file dữ liệu phụ) và Log (file nhật ký). Primary là điểm bắt đầu của database và trỏ đến các file khác trong database.
Mỗi database có một Primary. Bạn có thể đặt phần mở rộng cho file dữ liệu chính, nhưng khuyến nghị là .mdf. Secondary data file là file khác ngoài file dữ liệu chính. Một database có thể có nhiều hoặc chỉ một file dữ liệu phụ. Phần mở rộng cho file dữ liệu phụ nên đặt là .ndf.
Log file giữ tất cả thông tin dùng để khôi phục database. Database phải có ít nhất một log file. Chúng ta có thể có nhiều log file cho một database. Phần mở rộng nên đặt là .ldf.
Vị trí của tất cả các file trong database được ghi lại trong cả master database và Primary file của database. Trong hầu hết các trường hợp, công cụ database sử dụng vị trí file từ master database.
File có hai tên: Logical (Logic) và Physical (Vật lý). Logical dùng để tham chiếu file trong tất cả các lệnh T-SQL. Tên Physical là OS_file_name, phải tuân theo quy tắc hệ điều hành. Data file và log file có thể đặt trên hệ thống file FAT hoặc NTFS, nhưng không thể đặt trên hệ thống file nén. Có thể có tối đa 32.767 file trong một database.
Extent (Khoảng)
Extent là đơn vị cơ bản mà không gian được cấp phát cho mỗi bảng và index. Mỗi Extent gồm 8 trang liền kề hoặc 64KB. SQL Server có 2 loại Extent là Uniform và Mixed. Uniform chỉ chứa một đối tượng, Mixed chứa tối đa 8 đối tượng.
Page (Trang)
Page (trang) là đơn vị cơ bản trong lưu trữ dữ liệu của SQL Server. Kích thước một trang là 8KB. Đầu mỗi trang là header 96 byte, dùng để lưu thông tin hệ thống như loại trang, lượng không gian trống trên trang và ID của chủ sở hữu trang. Có 9 loại trang dữ liệu trong SQL Server:
- Data: Các hàng dữ liệu với tất cả dữ liệu từ text, ntext và image.
- Index: Các mục index.
- Text/Image: Dữ liệu của text, ntext và image.
- GAM: Thông tin về extent được chỉ định.
- SGAM: Thông tin về extent được cấp phát ở cấp hệ thống.
- Page Free Space (PFS): Thông tin về không gian trống có sẵn trên các trang.
- Index Allocation Map (IAM): Thông tin về extent được sử dụng bởi bảng hoặc index.
- Bulk Changed Map (BCM): Thông tin extent bị thay đổi bởi thao tác hàng loạt từ lệnh backup cuối.
- Differential Changed Map (DCM): Thông tin về extent đã thay đổi kể từ lệnh backup database cuối.
Kiến trúc file log - Log File Architecture
Transaction log trên SQL Server hoạt động đúng khi nó là một chuỗi các bản ghi log. Mỗi log được xác định bởi Log Sequence Number (LSN), chứa ID của giao dịch mà nó thuộc về.
Log ghi lại các sửa đổi dữ liệu hoặc hoạt động được thực hiện hoặc truy xuất hình ảnh trước và sau khi dữ liệu được chỉnh sửa. Hình ảnh trước là bản sao dữ liệu trước khi thao tác được thực hiện, hình ảnh sau là bản sao dữ liệu sau khi thao tác đã được thực hiện.
Các bước khôi phục một hoạt động phụ thuộc vào loại log.
- Hoạt động logic được ghi log.
- Để quay lại hoạt động logic trước, hoạt động sẽ được thực hiện lại.
- Để quay lại hoạt động logic sau, hoạt động logic ngược sẽ được thực hiện.
- Hình ảnh trước và sau được ghi log.
- Để quay lại hoạt động trước, hình ảnh sau sẽ được áp dụng.
- Để quay lại hoạt động sau, hình ảnh trước sẽ được áp dụng.
Các hoạt động đa dạng đã được ghi trong transaction log. Các hoạt động sau sẽ có mặt ở đó:
- Bắt đầu và kết thúc mỗi giao dịch.
- Tất cả sửa đổi dữ liệu (insert, update, delete), bao gồm thay đổi đối với system stored procedures hoặc lệnh định nghĩa dữ liệu (DDL) đối với bảng, bao gồm system table.
- Tất cả extent và allocation, hủy cấp phát trang.
- Tạo hoặc xóa bảng và index.
Các hoạt động Rollback cũng được ghi log. Mỗi giao dịch sẽ giữ một không gian trong log để đảm bảo có đủ không gian log cần thiết cho rollback thực thi lệnh hoặc thông báo lỗi. Không gian này sẽ được giải phóng khi giao dịch hoàn tất.
Phần của file log từ bản ghi log đầu tiên (cần để khôi phục thành công toàn bộ database) đến bản ghi log cuối cùng được gọi là phần log hoạt động (active log) hoặc log hoạt động. Đây là phần log bắt buộc cho khôi phục database đầy đủ. Không có phần nào của active log bị cắt xén. LSN của bản ghi log đầu tiên được gọi là Min LSN (Minimum Recovery LSN).
SQL Server Database Engine chia mỗi Physical log file thành nhiều virtual log files. Virtual log file không cố định về kích thước và không có số lượng cố định virtual log files cho mỗi Physical log file.
Database Engine tự động chọn kích thước virtual log file khi nó tạo hoặc mở rộng log file. Database Engine cố gắng duy trì số lượng virtual files nhỏ. Kích thước virtual log file không thể được cấu hình hoặc thiết lập bởi quản trị viên. Chỉ khi Physical log file được định nghĩa với kích thước nhỏ và giá trị growth_increment, virtual log file mới ảnh hưởng đến hiệu suất hệ thống.
Giá trị size là kích thước ban đầu cho log file và growth_increment là lượng không gian được thêm vào file mỗi khi file cần không gian mới. Khi log file đạt kích thước lớn do nhiều lần tăng nhỏ, chúng sẽ có nhiều virtual log files. Điều này có thể làm chậm khởi động database và các hoạt động backup/restore log.
Lời khuyên là bạn nên gán cho log file giá trị size gần với kích thước cuối cùng cần thiết và giá trị growth_increment tương đối lớn. SQL Server sử dụng write-ahead log (WAL), đảm bảo không có sửa đổi dữ liệu được ghi vào ổ cứng trước khi log liên quan được ghi vào ổ cứng. Điều này giúp duy trì tính chất ACID cho giao dịch.
Algebrizer trong SQL
Muốn nói thêm chút về Algebrizer: Algebrizer là một quá trình trong quá trình thực thi truy vấn. Nó bắt đầu làm việc sau Parser. Khi Query Parser tìm thấy truy vấn đúng cú pháp, nó sẽ chuyển đến Algebrizer và công việc của Algebrizer bắt đầu:. Algebrizer chịu trách nhiệm xác minh các đối tượng và tên cột (mà bạn cung cấp trong truy vấn hoặc được tham chiếu bởi truy vấn). Ví dụ, nếu tên cột bị viết sai trong truy vấn, Algebrizer chịu trách nhiệm xác nhận và tạo ra lỗi. Algebrizer cũng xác định tất cả các kiểu dữ liệu đang được xử lý trong một truy vấn cho trước. Algebrizer xác minh GROUP BY và các cột kết hợp có được đặt ở đúng vị trí không. Ví dụ, nếu bạn viết truy vấn sau và chỉ nhấn Ctrl+F5 để parse, sẽ không có lỗi. Nhưng nếu nhấn F5 để chạy truy vấn, Algebrizer sẽ hoạt động và trả về lỗi.
USE AdventureWorks
GO
SELECT MakeFlag, SUM(ListPrice)
FROM Production.Product
GROUP BY ProductNumber
Checkpoint trong SQL Server
Có 4 loại checkpoint trong SQL Server 2012:
- Automatic (Tự động): Loại này phổ biến nhất, chạy dưới dạng background process để đảm bảo SQL Server Database có thể khôi phục trong thời gian được chỉ định bởi Recovery Interval trong Server Configuration Option.
- Indirect (Gián tiếp): Checkpoint này chỉ có trên SQL Server 2012. Cũng là background process nhưng chỉ cho một số người dùng chỉ định thời gian khôi phục cho một database cụ thể trong configuration options. Khi Target_Recovery_Time cho một database cụ thể được chọn, nó sẽ ghi đè Recovery Interval được gán cho server, tránh Automatic checkpoint trên database đó.
- Manual (Thủ công): Checkpoint này chạy như bất kỳ lệnh SQL nào khác, khi bạn chạy lệnh checkpoint, nó sẽ chạy đến khi hoàn thành. Checkpoint này chỉ chạy trên database hiện tại. Bạn có thể chỉ định Checkpoint_Duration trong option để chỉ định thời gian bạn muốn checkpoint hoàn thành.
- Internal (Nội bộ): Là người dùng, bạn không thể kiểm soát loại checkpoint này trong các hành động cụ thể như:
- Tắt checkpoint trên tất cả database trừ khi tắt không bình thường (dùng SHUTDOWN WITH NOWAIT).
- Khi recovery model thay đổi từ Full/Bulk-logged sang Simple.
- Khi backup database.
- Nếu database ở chế độ Simple recovery, checkpoint sẽ tự động thực hiện hoặc khi log đầy 70%, hoặc dựa trên Recovery Interval của Server.
- Lệnh ALTER DATABASE để thêm/xóa log/data file cũng kích hoạt checkpoint.
- Checkpoint cũng diễn ra khi recovery model là Bulk-logged và thực hiện hoạt động minimally logged.
Đây có lẽ là phần "ngon" nhất của SQL Server, nhưng việc hiểu kiến trúc của nó sẽ giúp hiểu mọi thứ hoạt động như thế nào, nếu có lỗi, nó ở đâu... Điều này làm cho việc làm việc với database dễ dàng hơn.
Trong phần tiếp theo, chúng ta sẽ tìm hiểu về Management Studio và dần đi vào các lệnh cơ bản của SQL Server.