
Trong bài viết này, chúng ta sẽ tìm hiểu cơ bản về Machine Learning (Học máy) sử dụng Python 3.x.
Thiết lập môi trường
>>> pip install numpy
>>> pip install scipy
>>> pip install matplotlib
>>> pip install scikit-learn
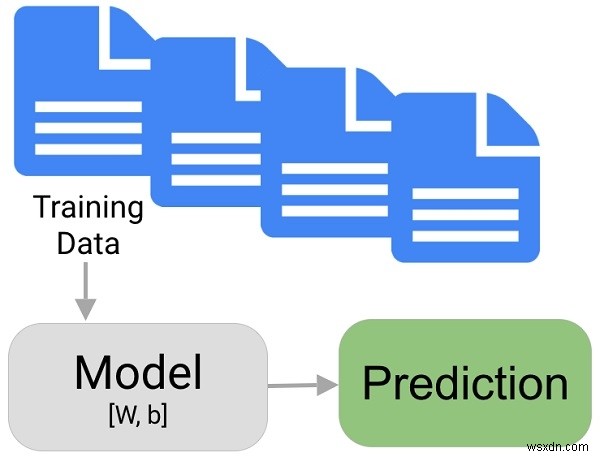
Machine Learning nghiên cứu từ dữ liệu (kinh nghiệm/thực tế) để dự đoán. Dữ liệu càng lớn, mô hình càng chính xác.
Quy trình Machine Learning
- Làm sạch dữ liệu (Data Cleaning)
- Nạp dữ liệu (Data Ingestion)
- Huấn luyện mô hình (Model Training)
- Kiểm thử mô hình (Model Testing)
- Triển khai mô hình (Model Deployment)
Thư viện chính và vai trò
- NumPy: Hỗ trợ mảng đa chiều lớn, hàm toán học hiệu năng cao
- SciPy: Tính toán khoa học: tối ưu hóa, tích phân, nội suy, đại số tuyến tính
- Matplotlib: Vẽ biểu đồ, trực quan hóa dữ liệu
- Scikit-learn: Thuật toán phân loại, hồi quy, phân cụm, tiền xử lý
Ví dụ: Mô hình phân loại chữ số với Scikit-learn
Sử dụng dataset built-in digits:
from sklearn import datasets
digits = datasets.load_digits()

# Xem dữ liệu
print(digits.data.shape)   # (1797, 64) - 1797 ảnh, mỗi ảnh 8x8=64 pixel
print(digits.target[:10])  # Nhãn thực: [0 1 2 3 4 5 6 7 8 9]

# Huấn luyện SVM classifier
from sklearn import svm
clf = svm.SVC(gamma=0.001, C=100.)

# Train với tất cả trừ ảnh cuối
clf.fit(digits.data[:-1], digits.target[:-1])

# Dự đoán ảnh cuối
prediction = clf.predict(digits.data[-1:])
print(f"Dự đoán: {prediction[0]}")  # Output: 8
Kết luận
Trong bài viết này, chúng ta đã tìm hiểu cơ bản Machine Learning và các thư viện cốt lõi trong Python: NumPy, SciPy, Matplotlib, Scikit-learn với ví dụ phân loại chữ số viết tay.