
Độ phức tạp thời gian (Time complexity) là một trong những khái niệm thú vị nhất bạn có thể học từ khoa học máy tính, và bạn không cần bằng cấp để hiểu nó!
Nó thú vị vì nó giúp bạn thấy tại sao một thuật toán hoặc chương trình cụ thể có thể chậm & bạn có thể làm gì để làm nó nhanh hơn.
Bạn có thể áp dụng điều này cho mã của chính mình.
Điều này đi xa hơn tất cả các thuật toán hoa mỹ mà bạn tìm thấy trong sách khoa học máy tính, như tôi sẽ chứng minh cho bạn sau trong bài viết này.
Nhưng trước tiên chúng ta cần nói về gì là chậm & gì là nhanh.
Chậm vs Nhanh
Việc sắp xếp 1 triệu số trong 150ms (milliseconds) là chậm hay nhanh?
Tôi nghĩ đó khá nhanh, nhưng đây không phải là câu hỏi mà độ phức tạp thời gian đang cố gắng trả lời.
Chúng ta muốn biết thuật toán sẽ hoạt động như thế nào khi “kích thước đầu vào” (input size) tăng.
Khi nói về “kích thước đầu vào” chúng ta nói về các tham số cho hàm hoặc phương thức. Nếu một phương thức nhận một chuỗi làm tham số thì đó là đầu vào, và độ dài chuỗi là kích thước đầu vào.
Ký hiệu Big O
Với ký hiệu Big O chúng ta có thể phân loại thuật toán theo hiệu suất của chúng.
Nó trông như sau:
O(1)
Trong trường hợp này O(1) đại diện cho thuật toán “thời gian hằng số” (constant time).
Điều đó có nghĩa là thuật toán sẽ luôn mất cùng một lượng thời gian để hoàn thành công việc, bất kể nó phải làm bao nhiêu việc.
Một loại khác là “thời gian tuyến tính” (linear time):
O(n)
Nơi “n” đại diện cho kích thước đầu vào (độ dài chuỗi, kích thước mảng, v.v.). Điều này có nghĩa là thuật toán sẽ hoàn thành công việc trong mối quan hệ 1:1 với kích thước đầu vào, vì vậy gấp đôi kích thước đầu vào cũng sẽ gấp đôi thời gian hoàn thành công việc.
Dưới đây là bảng:
| Ký hiệu | Tên | Mô tả |
|---|---|---|
| O(1) | Hằng số (Constant) | Luôn mất cùng một thời gian. |
| O(log n) | Logarit (Logarithmic) | Lượng công việc chia cho 2 sau mỗi lần lặp (tìm kiếm nhị phân). |
| O(n) | Tuyến tính (Linear) | Thời gian hoàn thành tăng tỷ lệ 1-1 với kích thước đầu vào. |
| O(n log n) | Linearithmic | Vòng lặp lồng, vòng lặp trong chạy trong thời gian log n. Ví dụ: quicksort, mergesort, heapsort. |
| O(n^2) | Quadratic (Bậc hai) | Thời gian tăng theo input size ^ 2. Nhận ra khi có vòng lặp đi qua tất cả phần tử & mỗi lần lặp cũng đi qua tất cả phần tử. Vòng lặp lồng. |
| O(n^3) | Cubic (Bậc ba) | Giống n^2, nhưng thời gian tăng theo n^3. Tìm vòng lặp lồng 3 cấp. |
| O(2^n) | Exponential (Mũ) | Thời gian tăng theo 2 ^ input size. Nhanh hơn nhiều so với n^2, đừng nhầm lẫn! Ví dụ: đệ quy Fibonacci. |
Phân tích Thuật toán
Bạn có thể bắt đầu phát triển trực giác cho điều này nếu bạn nghĩ về đầu vào như một mảng “n” phần tử.
Hãy tưởng tượng bạn muốn tìm tất cả các phần tử là số chẵn, cách duy nhất là đọc mỗi phần tử một lần để xem có khớp điều kiện không.
[1,2,3,4,5,6,7,8,9,10].select(&:even?)
Bạn không thể bỏ qua số vì bạn có thể bỏ lỡ một số bạn đang tìm, vì vậy đó làm cho nó trở thành thuật toán thời gian tuyến tính O(n).
3 Giải pháp khác nhau cho cùng một Vấn đề
Phân tích các ví dụ riêng lẻ thú vị, nhưng điều thực sự giúp hiểu ý tưởng này là xem cách chúng ta có thể giải quyết cùng một vấn đề bằng các giải pháp khác nhau.
Chúng ta sẽ khám phá 3 ví dụ mã cho bộ kiểm tra giải pháp Scrabble.
Scrabble là trò chơi cho một danh sách ký tự (như ollhe) yêu cầu bạn tạo từ (như hello) sử dụng các ký tự này.
Đây là giải pháp đầu tiên:
def scramble(characters, word)
  word.each_char.all? { |c| characters.count(c) >= word.count(c) }
end
Bạn biết độ phức tạp thời gian của mã này không? Chìa khóa nằm ở phương thức count, vì vậy hãy chắc chắn bạn hiểu phương thức đó làm gì.
Câu trả lời là: O(n^2).
Và lý do là với each_char chúng ta đang đi qua tất cả ký tự trong chuỗi word. Chỉ riêng điều đó sẽ là thuật toán thời gian tuyến tính O(n), nhưng bên trong block chúng ta có phương thức count.
Phương thức này thực chất là một vòng lặp khác đi qua tất cả ký tự trong chuỗi lại để đếm chúng.
Giải pháp Thứ hai
Ổn.
Làm thế nào để tốt hơn? Có cách nào tiết kiệm vòng lặp không?
Thay vì đếm ký tự chúng ta có thể loại bỏ chúng, như vậy chúng ta có ít ký tự hơn để duyệt.
Đây là giải pháp thứ hai:
def scramble(characters, word)
  characters = characters.dup
  word.each_char.all? { |c| characters.sub!(c, "") }
end
Cái này thú vị hơn một chút. Nó sẽ nhanh hơn phiên bản count rất nhiều trong trường hợp tốt nhất, nơi các ký tự chúng ta tìm ở gần đầu chuỗi.
Nhưng khi các ký tự đều ở cuối, theo thứ tự ngược lại của cách chúng xuất hiện trong word, hiệu suất sẽ tương tự phiên bản count, vì vậy chúng ta có thể nói đây vẫn là thuật toán O(n^2).
Chúng ta không phải lo về trường hợp không có ký tự nào trong word có sẵn, vì phương thức all? sẽ dừng ngay khi sub! trả về false. Nhưng bạn chỉ biết điều này nếu bạn đã nghiên cứu Ruby sâu rộng, vượt xa những gì các khóa học Ruby thông thường cung cấp.
Hãy thử Cách tiếp cận Khác
Điều gì xảy ra nếu chúng ta loại bỏ bất kỳ loại vòng lặp nào bên trong block? Chúng ta có thể làm điều đó với hash.
def scramble(characters, word)
  available = Hash.new(1)
  characters.each_char { |c| available[c] += 1 }
  word.each_char.all? { |c| available[c] -= 1; available[c] > 0 }
end
Đọc & ghi giá trị hash là thao tác O(1), có nghĩa là nó khá nhanh, đặc biệt so với vòng lặp.
Chúng ta vẫn có hai vòng lặp:
Một để xây bảng hash, và một để kiểm tra nó. Vì các vòng lặp này không lồng nhau nên đây là thuật toán O(n).
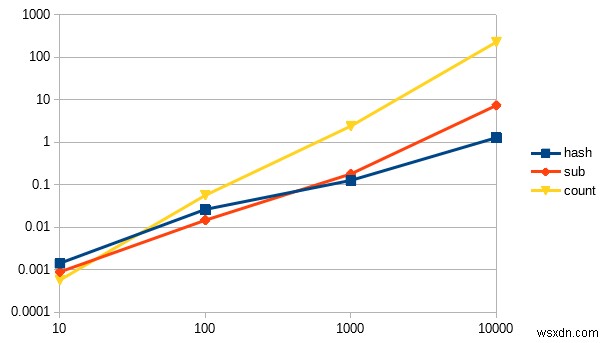
Nếu chúng ta benchmark 3 giải pháp này chúng ta có thể thấy phân tích của chúng ta khớp với kết quả:
hash 1.216667 0.000000 1.216667 ( 1.216007)
sub 6.240000 1.023333 7.263333 ( 7.268173)
count 222.866644 0.073333 222.939977 (223.440862)
Đây là biểu đồ đường:
Lưu ý một vài điều:
- Trục Y (dọc) đại diện cho giây hoàn thành công việc, trục X (ngang) đại diện cho kích thước đầu vào.
- Đây là biểu đồ logarithmic, nén giá trị trong một khoảng nhất định, nhưng thực tế đường
countdốc hơn nhiều. - Lý do tôi làm biểu đồ logarithmic là để bạn thấy một hiệu ứng thú vị, với kích thước đầu vào rất nhỏ
countthực sự nhanh hơn!
Tóm tắt
Bạn đã học về độ phức tạp thời gian thuật toán, ký hiệu Big O & phân tích độ phức tạp thời gian. Bạn cũng thấy một vài ví dụ so sánh các giải pháp khác nhau cho cùng vấn đề & phân tích hiệu suất của chúng.
Hy vọng bạn học được điều gì đó mới & thú vị!
Nếu bạn đã học được hãy chia sẻ bài viết này trên mạng xã hội & đăng ký bản tin nếu bạn chưa đăng ký để tôi gửi cho bạn thêm nội dung như thế này.
Cảm ơn bạn đã đọc.