
Trong bài viết này, chúng ta sẽ học cơ bản về neural network và cách triển khai chúng bằng Ruby! Nếu bạn tò mò về trí tuệ nhân tạo và deep learning nhưng không biết bắt đầu như thế nào, bài này dành cho bạn! Chúng ta sẽ đi qua ví dụ đơn giản để làm nổi bật các khái niệm chính. Khá khó bạn sẽ dùng Ruby viết neural network nhiều lớp, nhưng cho đơn giản và dễ đọc, đây là cách tuyệt vời để hiểu đang xảy ra gì. Trước hết, hãy lùi lại xem chúng ta đến đây như thế nào.
 Khung hình từ phim Ex Machina. Nguồn ảnh
Ex Machina là phim phát hành 2014. Nếu tìm tiêu đề trên Google, nó phân loại thể loại là "Drama/Fantasy". Và khi tôi xem lần đầu, nó giống khoa học viễn tưởng.
Nhưng, vài lâu hơn nữa?
Nếu hỏi Ray Kurzweil, futurist nổi tiếng làm việc tại Google, 2029 có thể là năm AI pass Turing test hợp lệ (thử nghiệm xem con người có phân biệt được máy/tính toán và con người khác không). Ông cũng dự đoán singularity (khi máy vượt trội trí tuệ con người) sẽ xuất hiện vào 2045.
Điều gì làm Kurzweil tự tin vậy?
Sự trỗi dậy của Deep Learning
Đơn giản, deep learning là tập hợp con của machine learning dùng neural network trích xuất insight từ dữ liệu lớn. Ứng dụng thực tế deep learning bao gồm: - Xe tự lái - Phát hiện ung thư - Trợ lý ảo như Siri và Alexa - Dự báo thời tiết cực đoan như động đất
Nhưng, "neural network" là gì?
Neural network lấy tên từ neuron, tế bào não xử lý và truyền thông tin qua tín hiệu điện và hóa học. Thú vị: não người có 80+ tỷ neuron!
Trong máy tính, neural network trông như sau:
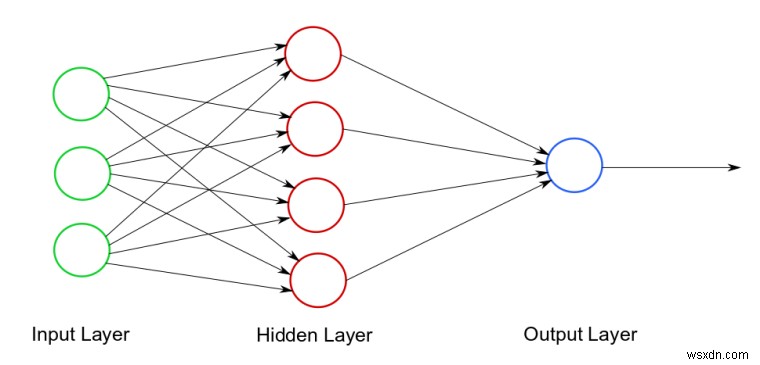 Sơ đồ neural network ví dụ. Nguồn ảnh
Như bạn thấy, có ba phần: 1) Input layer -- Dữ liệu ban đầu 2) Hidden layer(s) -- Neural network có 1 (hoặc nhiều) hidden layer. Đây là nơi mọi tính toán diễn ra! 3) Output layer -- Kết quả/kết luận cuối cùng
Bài học lịch sử nhanh
Neural network không mới. Thực tế, neural network có thể train đầu tiên (Perceptron) được phát triển tại Cornell University vào năm 1950. Tuy nhiên, có nhiều bi quan về ứng dụng neural network, chủ yếu vì model gốc chỉ có một hidden layer. Sách xuất bản 1969 cho thấy dùng Perceptron cho tính toán đơn giản cũng không thực tế.
Sự hồi sinh neural network có thể quy cho game máy tính, đòi hỏi GPU (graphics processing units) cực mạnh, kiến trúc gần giống neural net. Khác biệt là số hidden layer. Thay vì một, neural network train ngày nay dùng 10, 15, thậm chí 50+ layer!
Ví dụ!
Để hiểu cách hoạt động, xem ví dụ. Bạn cần cài gem ruby-fann. Mở terminal, cd vào thư mục làm việc. Chạy:
gem install ruby-fann
Tạo file Ruby mới (tôi đặt tên neural-net.rb).
Tiếp, dùng dataset "Student Alcohol Consumption" từ Kaggle. Tải tại đây. Mở file "student-mat.csv" trong Google Sheets (hoặc editor bạn thích). Xóa tất cả cột trừ: - Dalc (tiêu thụ rượu ngày thường, 1 rất thấp, 5 rất cao) - Walc (tiêu thụ rượu cuối tuần, 1 rất thấp, 5 rất cao) - G3 (điểm cuối khóa 0-20)
Cần đổi cột điểm cuối khóa thành binary -- 0 hoặc 1 -- để ruby-fann hoạt động. Ví dụ này, giả định ≤10 là "0" và >10 là "1". Tùy chương trình, bạn có thể viết công thức trong cell tự đổi giá trị thành 1 hoặc 0 dựa trên giá trị cell. Trong Google Sheets, trông như:
=IF(C3 >= 10, 1, 0)
Lưu dữ liệu thành .CSV (tôi đặt students.csv) cùng thư mục file Ruby.
Neural network sẽ có các layer: - Input Layer: 2 node (tiêu thụ rượu ngày thường và cuối tuần) - Hidden Layer: 6 hidden node (tùy ý ban đầu; sửa sau khi test) - Output Layer: 1 node (0 hoặc 1)
Đầu tiên, require gem ruby-fann và thư viện built-in csv. Thêm dòng đầu tiên:
require 'ruby-fann' require 'csv'
Tiếp, load data từ CSV vào mảng.
# Tạo hai mảng rỗng. Một giữ independent variables (x_data), một giữ dependent variable (y_data). x_data = [] y_data = [] # Duyệt CSV và thêm phần tử vào mảng tương ứng. # Nếu không thêm .to_f và .to_i, mảng sẽ chứa string, ruby-fann sẽ không vui. CSV.foreach("students.csv", headers: false) do |row| x_data.push([row[0].to_f, row[1].to_f]) y_data.push(row[2].to_i) end Tiếp, chia data thành training và testing. Tỷ lệ 80/20 phổ biến, 20% test, 80% train. "Training" nghĩa là model học từ data này, rồi dùng "testing" xem model dự đoán tốt đến đâu.
# Chia data thành training set và test set. testing_percentage = 20.0 # Lấy tổng số phần tử nhân phần trăm test. testing_size = x_data.size * (testing_percentage/100.to_f) # Bắt đầu từ đầu đến testing_size - 1 vì mảng 0-indexed. x_test_data = x_data[0 .. (testing_size-1)] y_test_data = y_data[0 .. (testing_size-1)] # Tiếp từ chỗ dừng đến cuối dataset. x_train_data = x_data[testing_size .. x_data.size] y_train_data = y_data[testing_size .. y_data.size] Tuyệt! Data sẵn sàng. Tiếp là phần "phép màu"!
# Setup training data model. train = RubyFann::TrainData.new(:inputs=> x_train_data, :desired_outputs=>y_train_data) Dùng object RubyFann::TrainData, truyền x_train_data (tiêu thụ rượu ngày thường và cuối tuần) và y_train_data (0 hoặc 1 dựa trên điểm cuối khóa).
Giờ setup model neural network thực với số hidden neuron đã bàn.
# Setup model và train với training data. model = RubyFann::Standard.new( num_inputs: 2, hidden_neurons: [6], num_outputs: 1 ); OK, train thôi!
model.train_on_data(train, 1000, 10, 0.01) Truyền biến train tạo trước. 1000 là max_epochs, 10 là số lỗi giữa các báo cáo, 0.1 là desired mean-squared error. Một epoch là khi toàn bộ dataset đi qua neural network. Mean-squared error là thứ chúng ta minimize. Đọc thêm tại đây.
Tiếp, muốn biết model tốt đến đâu bằng cách so sánh dự đoán cho test data với kết quả thực. Làm bằng code:
predicted = [] # Duyệt x_test_data, chạy model trên mỗi, thêm vào predicted. x_test_data.each do |params| predicted.push( model.run(params).map{ |e| e.round } ) end # So sánh predicted với actual. correct = predicted.collect.with_index { |e,i| (e == y_test_data[i]) ? 1 : 0 }.inject{ |sum,e| sum+e } # In accuracy rate. puts "Accuracy: #{((correct.to_f / testing_size) * 100).round(2)}% - test set of size #{testing_percentage}%" Chạy chương trình!
ruby neural-net.rb
Bạn sẽ thấy nhiều output Epochs, nhưng cuối cùng thấy như:
Accuracy: 56.82% - test set of size 20.0%
Ối, không tốt! Nhưng hãy tự tạo data point và chạy model.
prediction = model.run( [1, 1] ) # Round output để lấy prediction. puts "Algorithm predicted class: #{prediction.map{ |e| e.round }}" prediction_two = model.run( [5, 4] ) # Round output để lấy prediction. puts "Algorithm predicted class: #{prediction_two.map{ |e| e.round }}" Ở đây, hai ví dụ. Đầu tiên, truyền 1 cho tiêu thụ rượu ngày thường và cuối tuần. Nếu tôi cá cược, đoán student này điểm >10 (tức 1). Ví dụ hai truyền giá trị cao (5 và 4), đoán điểm ≤10 (tức 0). Chạy lại!
Output nên trông như:
Algorithm predicted class: [1] Algorithm predicted class: [0] Model dường như hoạt động như mong đợi cho số ở hai đầu spectrum. Nhưng gặp khó khi số đối lập (thử 1 và 5, hoặc 2 và 3) hoặc ở giữa. Ta cũng thấy từ data Epoch, dù error giảm, vẫn rất cao (mid-20%). Nghĩa là có thể không có mối quan hệ giữa tiêu thụ rượu và điểm. Tôi khuyến khích bạn chơi với dataset gốc Kaggle -- có biến độc lập khác dự đoán kết quả khóa học?
Tổng kết
Có nhiều chi tiết phức tạp (chủ yếu về toán học) diễn ra dưới lớp để làm cho mọi thứ hoạt động. Nếu tò mò muốn học thêm, tôi mạnh mẽ khuyên xem docs FANN hoặc source code gem ruby-fann. Cũng khuyên xem tài liệu "AlphaGo" trên Netflix -- không cần nhiều kiến thức kỹ thuật để tận hưởng và cho ví dụ thực tế deep learning đẩy giới hạn máy tính.
Kurzweil có đúng dự đoán? Chỉ thời gian trả lời!