
Mô hình không bị hồi quy. Bạn không ship bug. Nền tảng đã thay đổi nó.
Ứng dụng AI production của bạn phụ thuộc vào thứ mà hầu hết các team không nhận ra họ đã trao quyền kiểm soát: hành vi của mô hình đằng sau endpoint của họ. Thực tế là một mô hình không phải là một artifact cố định. nó là một đích di chuyển. Để duy trì khả năng cạnh tranh, các nền tảng liên tục cập nhật trọng số, hoán đổi mức lượng tử hóa, nâng cấp inference engine, định tuyến lại traffic qua phần cứng, và đôi khi thay thế toàn bộ mô hình - mà không thay đổi tên endpoint.
Khi điều đó xảy ra, ứng dụng của bạn thay đổi theo. Đầu ra dịch chuyển. Prompt ngừng hoạt động. Hành vi điều chỉnh cẩn thận bị hạ cấp. Và bạn thường không biết từ changelog: bạn biết từ người dùng.
Đây là rủi ro ẩn của hạ tầng AI hiện đại: bạn đang xây dựng trên một hệ thống có thể thay đổi bên dưới bạn bất kỳ lúc nào, không có đảm bảo rằng "cùng một mô hình" ngày mai là cùng mô hình bạn test hôm nay. Bài viết này khám phá thực tế điều đó trông như thế nào, tại sao nó xảy ra, và tại sao hầu như không nền tảng nào giải quyết tốt - và các team đang làm gì để đối phó.
Mô hình bạn ship với không phải là mô hình bạn đang chạy.
Điểm chính cần nhớ
- "Phiên bản mô hình" không hoàn chỉnh bởi thiết kế: Cái trông như một mô hình đơn lẻ thực tế là một stack các bộ phận di chuyển - trọng số, inference engine, phần cứng, định tuyến và guardrails - tất cả có thể thay đổi độc lập mà không cần tên endpoint thay đổi.
- Thay đổi lặng lẽ tạo rủi ro production thực: Những cập nhật này phá vỡ khả năng tái tạo, vô hiệu hóa prompt tuning, và gây ra hồi quy mà team thường chỉ phát hiện sau khi người dùng bị ảnh hưởng - không qua khả năng quan sát hoặc giám sát nền tảng.
- Khoảng trống không phải kỹ thuật - mà là minh bạch và sở hữu: Nền tảng đã theo dõi các thay đổi này nội bộ nhưng không công khai; khi AI trở nên quan trọng cho production, versioning toàn stack, changelog và đảm bảo tái tạo sẽ trở thành tiêu chí chính trong lựa chọn nền tảng.
Hình dạng của Vấn đề Phiên bản
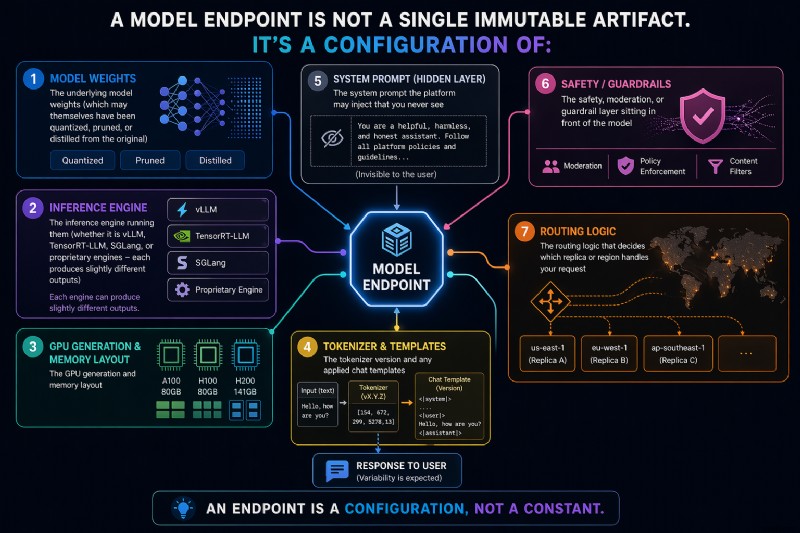
Cái "cùng một mô hình" thực sự có nghĩa là gì
Một endpoint mô hình không phải là một artifact bất biến đơn lẻ. Nó là một cấu hình của:
- Trọng số mô hình cơ bản (có thể đã được lượng tử hóa, cắt tỉa hoặc tinh chế từ gốc)
- Inference engine chạy chúng (dù là vLLM, TensorRT-LLM, SGLang, hoặc engine độc quyền - mỗi cái tạo ra đầu ra hơi khác nhau)
- Thế hệ GPU và bố cục bộ nhớ
- Phiên bản tokenizer và bất kỳ chat template nào được áp dụng
- System prompt nền tảng có thể inject mà bạn không bao giờ thấy
- Lớp an toàn, kiểm duyệt hoặc guardrails ngồi trước mô hình
- Logic định tuyến quyết định replica hoặc khu vực nào xử lý request của bạn
Bất kỳ cái nào trong số này có thể thay đổi mà không cần tên mô hình thay đổi. Điều quan trọng cần nhấn mạnh là hầu hết chúng thực sự thay đổi, thường xuyên, suốt vòng đời ứng dụng production. Thay đổi này thiết yếu cho phát triển sản phẩm AI vì công nghệ cơ bản, thường thì, cải thiện với mỗi thay đổi. Thay đổi tăng dần này là phần cốt lõi của ngành AI Software.
Ba loại thay đổi lặng lẽ
Loại đầu tiên là cập nhật phiên bản rõ ràng nơi nền tảng thay đổi trọng số endpoint trỏ tới. "GPT-4" đã là nhiều mô hình khác nhau theo thời gian, ví dụ, và endpoint Claude được cập nhật thường xuyên. Endpoint mô hình open-source trên nền tảng hosted thường tự động theo dõi phát hành upstream.
Loại thứ hai là thay đổi cấp hạ tầng nơi trọng số giữ nguyên nhưng điều gì đó trong serving stack dịch chuyển. Ví dụ bao gồm khi:
- Inference engine được nâng cấp
- Mức lượng tử hóa thay đổi vì lý do chi phí
- Quyết định định tuyến dịch chuyển traffic giữa các triển khai khác nhau được cho là tương đương nhưng không phải.
Loại thứ ba là thay đổi hành vi từ bổ sung cấp nền tảng: lớp kiểm duyệt mới, system prompt đã sửa đổi, bộ lọc an toàn được thêm hoặc sửa đổi, hoặc chat template được chỉnh sửa. Trong các tình huống này, mô hình giống nhau, nhưng thứ mô hình nhận và thứ người dùng nhận là khác nhau.
Cách Mỗi Loại Thực Sự Ảnh Hưởng Hành Vi Mô Hình
Vấn đề hồi quy lặng lẽ
Hồi quy lặng lẽ là sự hạ cấp chất lượng đầu ra mô hình do thay đổi ở đâu đó trong serving stack chưa bao giờ được công bố, ghi chép, hoặc gắn với version bump. Tên mô hình trên endpoint giống hệt. Hợp đồng API giống hệt. Request bạn gửi byte-identical với cái bạn gửi tháng trước. Nhưng chất lượng phản hồi đã giảm - đôi khi tinh vi, đôi khi mạnh - và không có gì trên bề mặt công khai của nền tảng cho bạn biết tại sao.
Cơ chế gần như luôn là một trong ba loại thay đổi từ trước: trọng số được cập nhật lặng lẽ, điều gì đó trong hạ tầng dịch chuyển, hoặc một lớp cấp nền tảng (guardrail mới, system prompt đã sửa, bộ lọc kiểm duyệt siết chặt) được thêm hoặc thay đổi. Từ bên ngoài, cả ba trông giống nhau - đầu ra của bạn tệ hơn và nền tảng không nói. Từ bên trong, chúng là nguyên nhân gốc rễ khác nhau với sửa chữa khác nhau, và bạn không có cách phân biệt chúng nếu không có sự hợp tác của nền tảng.
Điều làm hồi quy lặng lẽ khác biệt từ model drift thông thường là sự bất đối xứng thông tin. Nền tảng biết gì đã thay đổi. Bạn không. Và vì monitoring của bạn gần như chắc chắn đo uptime, latency và error rate thay vì chất lượng đầu ra trên golden dataset, hồi quy lan truyền đến người dùng của bạn trước khi nó hiện trên bất kỳ dashboard nào bạn sở hữu. Khi bạn đã xác nhận hồi quy là thật, cô lập nó vào mô hình thay vì mã của chính bạn, và mở support ticket, nền tảng thường đã chuyển sang thay đổi lặng lẽ tiếp theo. bạn cuối cùng debug một đích di chuyển với một nửa thông tin, trong khi người dùng chịu chi phí của quyết định được làm ở nơi thượng nguồn mà bạn chưa bao giờ được biết.
Đây là tệ nhất trong bốn vấn đề trong phần này vì nó là cái duy nhất nơi nền tảng nắm thông tin sẽ giải quyết vấn đề ngay lập tức và chọn không chia sẻ. Thất bại tái tạo, nợ prompt, và drift eval-to-prod đều là triệu chứng team ít nhất có thể tự chẩn đoán. Hồi quy lặng lẽ là cái nơi công cụ chẩn đoán bạn cần ở bên kia API.
Vấn đề tái tạo
Mặc dù mô hình GPT, như ví dụ xuất sắc của loại triển khai AI phổ biến, bản chất là xác suất, bạn vẫn có thể mong đợi nhận được câu trả lời tương tự khi dùng cùng mô hình với cùng prompt. Nhưng, khi bất kỳ thay đổi được mô tả trước xảy ra, một đầu ra bạn nhận được hôm qua có thể không tái tạo được hôm nay. Đây là cốt lõi của vấn đề tái tạo: bất kỳ kỳ vọng nào về cách mô hình sẽ hành vi có thể bị vô hiệu hóa bởi bất kỳ thay đổi nào này.
Đối với ứng dụng làm đánh giá tự động hoặc so sánh phiên bản mô hình với nhau, điều này phá vỡ giả định cơ bản rằng đầu vào giống hệt tạo ra đầu ra giống hệt (hoặc tương tự, trong trường hợp mô hình xác suất) cho cùng seed. Temperature zero không thực sự cho bạn tính xác định khi stack cơ bản đang dịch chuyển dưới chân bạn. Vấn đề nợ prompt engineering
Team thường dành nhiều tuần điều chỉnh prompt cho quirks cụ thể của một mô hình và tối ưu hóa chúng để đáp ứng tốt hơn nhu cầu người dùng. Khi mô hình đó bị hoán đổi hoặc cập nhật lặng lẽ, tất cả công việc điều chỉnh đó biến thành nợ một phần. Khi prompt được xây dựng cẩn thận để xử lý failure mode của một mô hình giờ gặp mô hình hơi khác với failure mode hơi khác, hành vi cuối cùng người dùng gặp phải thay đổi.
Vấn đề drift eval-to-production
Đây là một tình huống phổ biến khác: bạn đánh giá một phiên bản mô hình đối với test set, và sau đó ship nó lên production. Nhưng endpoint production không còn dùng mô hình bạn đã đánh giá, ngay cả khi tên trên endpoint giống hệt. Một lần nữa, điều này có thể có tác động đáng kể đến hành vi của sản phẩm cuối cùng.
Nền tảng Thực Sự Làm Gì
Phần này đi qua cách các nền tảng inference chính xử lý versioning, dựa trên tài liệu công khai và hành vi quan sát được.
Versioning kiểu OpenAI
OpenAI ghim snapshot rõ ràng (gpt-4-0613, gpt-4o-2024-08-06) và cho phép bạn target chúng. Các endpoint alias (gpt-4, gpt-4o) trỏ đến bất kỳ default hiện tại nào, thay đổi theo thời gian. Team không biết ghim snapshot nhận được bất kỳ phiên bản nào là hiện tại, và alias có thể dịch chuyển dưới chân họ.
OpenAI vẫn thay đổi mô hình của họ, vì nhiều lý do. Ví dụ của sự cố Sycophancy. GPT-4o được báo cáo 'quá khen ngợi hoặc đồng ý — thường được mô tả là sycophantic,' và OpenAI phát hành một loạt sửa lỗi rollout trước khi cuối cùng deprecate mô hình (nguồn). Sự deprecate cuối cùng của mô hình tạo ra sóng gió lớn hơn khi người than vãn sự mất mát của mô hình.
Điều làm sự cố Sycophancy có giá trị hướng dẫn không phải là sự thay đổi tính cách bản thân - mà là những gì nó tiết lộ về hợp đồng endpoint. Team gọi gpt-4o trước, trong và sau rollout sycophancy đang hit cùng tên endpoint nhưng mô hình có ý nghĩa khác nhau. Một support bot khách hàng tuned đối với phiên bản pre-sycophancy sẽ gặp mô hình ấm áp, đồng ý hơn một nửa đường vòng đời production của nó, sau đó gặp hồ sơ hành vi thứ ba khi OpenAI điều chỉnh hướng, và thứ tư khi mô hình cuối cùng bị deprecated. Không một trong những chuyển tiếp đó yêu cầu thay đổi mã ở phía khách hàng. Không một trong chúng trigger version bump trên chuỗi endpoint. Cùng cuộc gọi API hai dòng tạo ra bốn chế độ hành vi khác biệt trong vòng vài tháng, và tín hiệu duy nhất hầu hết team nhận được là người dùng nói sản phẩm cảm thấy khác. Cách tiếp cận của OpenAI tốt hơn hầu hết vì nó cho bạn tùy chọn dùng phiên bản mô hình cũ, miễn là OpenAI vẫn serve chúng. Nhưng, vẫn đáng ghi nhận việc lựa chọn là thủ công và sẽ khó làm cho những ai không làm research để biết cách đổi mô hình sang phiên bản cũ.
Cách tiếp cận của Anthropic
Anthropic dùng identifier mô hình có ngày (kiểu claude-opus-4-5-20251101). Ghim hoạt động. Nhưng system prompt injection cấp nền tảng và lớp an toàn tiến hóa độc lập với phiên bản mô hình, nên hai request đến cùng mô hình ghim trên ngày khác nhau có thể hành vi khác nhau vì những gì xảy ra quanh mô hình, không phải trong nó. Đây là bước tiến về minh bạch, nhưng việc lựa chọn mô hình cốt lõi vẫn tương tự OpenAI.
Ví dụ hồi quy lặng lẽ từ Anthropic xảy ra gần đây trong Github Issue đáng chú ý, nơi một nhà phát triển AI lớn gọi ra rõ ràng "nerfing" rõ ràng của mô hình Claude Opus trong công việc engineering phức tạp của họ. Họ báo cáo Claude đã bắt đầu bỏ qua hướng dẫn, tuyên bố "simplest fixes" không chính xác, làm ngược lại hoạt động được yêu cầu, và họ tuyên bố mô hình thực hiện completion chống lại hướng dẫn. Tất cả này mà không có thay đổi được báo cáo trong mô hình được dùng. Thay đổi lặng lẽ này bị bác bỏ bởi nhà phát triển Claude trong cùng thread, nhưng có sự đồng thuận rộng rãi rằng một thay đổi đã xảy ra từ người dùng khác, dựa trên phản hồi cho bình luận.
'Cùng một mô hình' luôn luôn là một trừu tượng marketing.
Mô hình open-source hosted
Nền tảng host mô hình open-source (Baseten, Fireworks, Together, DigitalOcean, Nebius Token Factory, Modal) thường đặt tên endpoint theo mô hình cơ bản, như "llama-3.1-70b-instruct", mà không công khai lượng tử hóa cụ thể nào, phiên bản inference engine nào, hoặc cấu hình triển khai nào thực sự serve request. Điều này có thể là vấn đề lớn, vì hiệu suất mô hình sẽ khác nhau giữa các nền tảng trong khi chúng giữ cùng tên. Cập nhật bất kỳ cái nào trong số đó thường không được truyền thông như thay đổi phiên bản mô hình. Khi nói đến nhà cung cấp host open-source, trách nhiệm nằm ở người dùng để research về bất kỳ thay đổi nào cho triển khai mô hình cơ bản trong kịch bản Serverless Inference. Trong triển khai tùy chỉnh, mọi chuyện hơi khác.
Triển khai tùy chỉnh
Khi bạn triển khai mô hình của mình trên nền tảng như Modal hoặc Baseten, bạn sở hữu câu chuyện versioning. Đây là tình huống sạch nhất cho khả năng tái tạo, kiểm soát production, và quản lý thay đổi mô hình cho sản phẩm downstream của bạn, nhưng có nghĩa là gánh gánh nặng vận hành quản lý vòng đời mô hình bản thân. Quan trọng phải cân nhắc tradeoff này khi scale, vì thời gian dev cần thiết để quản lý thay đổi tăng vọt.
Những gì Team Đang Làm Về Nó
Các phần dưới bao gồm các workaround phổ biến team đã áp dụng. Không cái nào giải quyết hoàn toàn vấn đề, nhưng mỗi cái cung cấp bước đúng hướng. Ghim snapshot khi có thể
Khi nền tảng công khai snapshot có ngày, ghim chúng là table stakes. Nhưng không phải nền tảng nào cũng công khai chúng, và snapshot ghim cuối cùng bị deprecated. Hãy cân nhắc điều này khi chọn nền tảng host mô hình cho sản phẩm AI của bạn cẩn thận, hoặc bạn có thể rơi vào tình huống mô hình của bạn biến mất không có kế hoạch dự phòng.
Golden dataset regression testing
Golden dataset regression testing là nơi bạn chạy một tập input cố định qua endpoint production theo lịch trình và diff đầu ra đối với baseline known-good. Quy trình này cho phép bạn dễ dàng bắt quality regression và thay đổi hành vi mô hình quan trọng khác, nhưng tốn kém để duy trì, và chỉ bao phủ các mẫu bạn nghĩ tới quan sát. Golden dataset regression testing định kỳ có thể ngăn chặn tin xấu khủng khiếp rằng khách hàng đã phát hiện thay đổi hành vi sản phẩm của bạn trước bạn.
Output sampling và logging
Đây là quá trình log một phần trăm mẫu request và response production để phân tích sau. Điều này cho phép bạn phát hiện drift sau thực tế, nhưng vẫn yêu cầu xây dựng hạ tầng sampling, lưu trữ và phân tích bản thân.
Shadow deployments
Bạn có thể chạy cùng request đối với endpoint production hiện tại và endpoint candidate mới đồng thời, và so sánh đầu ra để xem nó ảnh hưởng hành vi mô hình như thế nào. Điều này hoạt động tuyệt vời cho đánh giá thay đổi bạn đang làm; nó không giúp với thay đổi nền tảng làm dưới chân bạn.
Self-hosting mô hình
Nước đi kiểm soát tối thượng: chạy mô hình chính bạn trên hạ tầng bạn kiểm soát. Điều này cho phép bạn kiểm soát hoàn toàn trọng số bạn dùng, inference engine, lượng tử hóa, và bất cứ điều gì khác có thể ảnh hưởng đầu ra. Điều này đổi vấn đề versioning cho gánh nặng vận hành host mô hình, đó là lý do hầu hết team không làm.
Versioning Thực Sự Tốn Bao Nhiêu
Thuế quan sát (observability tax)
Mọi team quan tâm chất lượng đầu ra đều tự xây infrastructure đánh giá riêng vì nền tảng không cung cấp. Đây là công việc trùng lặp xảy ra khắp ngành - prompt regression framework, output diffing tool, hệ thống giám sát chất lượng, v.v., tất cả được xây bởi team ứng dụng muốn xây sản phẩm thực của họ. Thuế niềm tin (trust tax)
Khi tính năng AI của bạn hỏng vì mô hình dịch chuyển dưới chân bạn, người dùng không biết khác biệt giữa "AI không tin cậy" và "nền tảng lặng lẽ cập nhật mô hình." Sản phẩm của bạn hấp thu chi phí uy tín của quyết định được làm ở thượng nguồn.
Thuế di chuyển (migration tax)
Team cân nhắc chuyển nền tảng phải tính đến không chỉ khác biệt API mà cả khác biệt hành vi giữa mô hình cùng tên trên nền tảng khác nhau. "Llama 3.1 70B" trên Fireworks không nhất thiết giống "Llama 3.1 70B" trên Together - chúng có thể là lượng tử hóa khác, dùng inference engine khác, hoặc có guardrail stack hoàn toàn khác. Sự thiếu rõ ràng này làm cho việc chuyển provider khó khăn mà không cần test mở rộng.
Cái Tốt Hơn Sẽ Trông Như Thế Nào
Một nền tảng inference nghiêm túc năm 2026 nên đối xử với hành vi mô hình như nhà cung cấp cloud đối xử với uptime: như một bề mặt hợp đồng, không phải hộp đen.
Trạng thái hiện tại không phải hạn chế kỹ thuật - đó là khoảng trống công khai. Hạ tầng đã tồn tại để theo dõi trọng số, engine, mức lượng tử hóa và quyết định định tuyến; nền tảng đơn giản không công khai nó.
Đây là trông như thế nào trong thực tế.
-
Identifier phiên bản hoàn chỉnh Tên mô hình hôm nay xác định trọng số, đôi khi. Chúng nên xác định toàn bộ cấu hình serving. Một chuỗi phiên bản hoàn chỉnh nắm bắt mọi thứ có thể thay đổi thứ ra khỏi endpoint: trọng số (với mức lượng tử hóa), inference engine và phiên bản, thế hệ phần cứng, phiên bản tokenizer, chat template, và bất kỳ system prompt hoặc guardrail layer nào do nền tảng inject. Cái gì đó như llama-3.1-70b-instruct.fp8.vllm-0.6.3.h100.tmpl-v2.guardrail-v4 xấu xí nhưng trung thực. Team có thể ghim bất kỳ thành phần nào họ phụ thuộc và nhận thông báo khi cái khác thay đổi.
-
Changelog feed cho toàn bộ stack Nền tảng phát hành release notes khi cập nhật trọng số mô hình. Hiếm khi họ phát hành bất cứ gì khi nâng cấp vLLM, thay đổi lượng tử hóa vì lý do chi phí, hoặc định tuyến lại traffic giữa các khu vực. Một changelog feed phù hợp - lý tưởng machine-readable - sẽ bao phủ mọi lớp của serving stack, với timestamp và endpoint bị ảnh hưởng. Team nên có thể subscribe thay đổi cho cấu hình ghim cụ thể và nhận cảnh báo trước rollout, không phải sau khi user phàn nàn.
-
Đảm bảo tái tạo với retention nêu rõ Snapshot ghim nên có ý nghĩa. Nền tảng nên cam kết cửa sổ retention nêu rõ - ví dụ 12 hoặc 24 tháng - trong đó cấu hình ghim sẽ trả về đầu ra byte-identical cho đầu vào identical tại temperature zero, cho toàn bộ stack, không chỉ trọng số. Khi cửa sổ đó hết hạn, team nhận được thông báo trước và đường dẫn di chuyển. Đây là cách database và OS xử lý versioning. Không lý do inference nên khác.
-
Regression testing do nền tảng cung cấp Mọi team nghiêm túc đều xây cùng infrastructure đánh giá trong isolation. Nền tảng nên cung cấp đây như tính năng first-class: đăng ký golden dataset, chạy nó theo lịch trình đối với endpoint ghim của bạn, và nhận cảnh báo khi đầu ra drift vượt ngưỡng bạn đặt. Điểm cộng cho differential testing giữa snapshot, để team có thể đánh giá có nên migrate trước khi bị ép.
-
Tài liệu trung thực về cái gì thay đổi và khi nào Mục khó nhất trong danh sách này, vì nó yêu cầu nền tảng thừa nhận "cùng một mô hình" luôn là trừu tượng marketing. Tài liệu nên đặt tên mọi lớp có thể thay đổi độc lập với phiên bản mô hình, nêu chính sách nền tảng về thay đổi từng cái, và mô tả cách khách hàng sẽ được thông báo. Team sau đó có thể quyết định có thông tin về nền tảng nào khớp risk tolerance của họ.
Checklist cho người mua
Nếu bạn đang đánh giá nền tảng inference hôm nay, hãy hỏi vendor những câu hỏi này trước khi ký:
- "Tôi có thể ghim một snapshot mô hình cụ thể không, và snapshot đó đảm bảo có sẵn bao lâu?"
- "Chuỗi phiên bản tôi ghim có bao phủ inference engine, lượng tử hóa và phần cứng - hay chỉ trọng số?"
- "Chính sách thông báo của bạn khi bất kỳ lớp nào của serving stack thay đổi là gì?"
- "Bạn inject system prompt, guardrails, hoặc lớp kiểm duyệt tôi không thấy? Tôi có thể opt out không?"
- "Nếu tôi chạy cùng request hai lần tại temperature zero cách nhau một tháng, bạn đảm bảo gì về tính đồng nhất đầu ra?"
- "Bạn cung cấp regression testing tooling, hay tôi tự xây?"
- "Khi snapshot ghim bị deprecated, tôi nhận được bao nhiêu thông báo trước và migration path là gì?"
Nếu nền tảng không thể trả lời hầu hết câu hỏi này rõ ràng, đó là câu trả lời. Bạn đang xây dựng trên hạ tầng có thể thay đổi dưới chân bạn, và bạn sẽ là người giải thích cho người dùng của mình.
Thực tế Thương mại
Không cái nào ở trên khó về mặt kỹ thuật. Điều làm nó khó là thương mại: nền tảng được lợi từ sự linh hoạt thay đổi mọi thứ lặng lẽ, và khách hàng lịch sử đã chấp nhận nó vì lựa chọn thay thế, self-hosting, tốn kém vận hành. Trade-off đó bắt đầu trông tệ hơn khi tính năng AI di chuyển từ demo vào sản phẩm người ta phụ thuộc. Nền tảng giải quyết điều này trước sẽ win segment thị trường thực sự quan tâm độ tin cậy. Những cái không sẽ tiếp tục ship silent regression cho team phát hiện từ người dùng của họ.
Tóm lại
Ngành đã xây dựng hạ tầng AI trên giả định mượn từ phần mềm truyền thống: artifact có tên là artifact ổn định. Giả định đó không đúng. Trọng số, engine, định tuyến và guardrails đều thay đổi độc lập với tên trên endpoint, và khoảng trống giữa cái "phiên bản mô hình" ngụ ý và cái nó thực sự đảm bảo là nơi production AI lặng lẽ hỏng.
Dự đoán ở đây: trong 18 tháng tới, silent versioning sẽ trở thành vấn đề procurement, không chỉ engineering. Team mua dung lượng inference bắt đầu hỏi các câu hỏi trong checklist trên, và nền tảng có thể trả lời sẽ bắt đầu win deal những cái khác thậm chí không biết họ đã mất. Mong đợi thấy "reproducibility SLAs," "stack-level changelogs," và "snapshot retention windows" di chuyển từ wishlist engineering vào hợp đồng enterprise. Nền tảng đầu tiên công bố full-stack version string như tính năng sản phẩm - không phải footnote sâu trong docs - sẽ reset kỳ vọng khách hàng cho mọi người khác.
Đối với team xây dựng trên inference hôm nay, câu hỏi thực tế không phải là silent change có ảnh hưởng sản phẩm của bạn hay không. Sẽ có. Câu hỏi là bạn phát hiện từ monitoring, từ regression test của chính bạn, hay từ khiếu nại user vào sáng thứ Hai. Cái nào trong ba đó phụ thuộc gần như hoàn toàn vào quyết định bạn làm ngay bây giờ, trước khi silent update tiếp theo hạ cánh.
Mô hình bạn ship với không phải là mô hình bạn đang chạy. Xây dựng cho phù hợp.
DigitalOcean có thể giúp bạn xây dựng sản phẩm AI của bạn ở quy mô lớn.
 Bài viết này được cấp phép dưới Giấy phép Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International.