
Đăng ngày 19 tháng 4 năm 2026, 10:00 AM EDT
Kinh nghiệm xuất bản tech của Afam từ 2018, khi làm việc cho Make Tech Easier. Qua nhiều năm, anh xây dựng uy tín xuất bản guide, review, tips, và bài giải thích chất lượng cao, bao quát Windows, Linux, và công cụ open source. Công trình anh xuất hiện trên top website bao gồm Technical Ustad, Windows Report, Guiding Tech, Alphr, và Next of Windows.
Anh có bằng Cử nhân Khoa học Máy tính và là người ủng hộ mạnh mẽ privacy và bảo mật dữ liệu, với vài tips, video, tutorial trên chủ đề này trên kênh YouTube Fuzo Tech.
Khi không làm việc, anh thích dành thời gian với gia đình, đạp xe, hoặc chăm vườn.
Tôi thích dùng Linux vì stability (ổn định). Tuy nhiên, home server chạy 24/7 dường như push nó đến giới hạn, và tôi thấy nó hang (treo) ở những lúc tồi tệ nhất. Lúc đó, tôi phải can thiệp manual reboot để remote box online lại.
Nếu đây là scenario bạn đối mặt, Linux có built-in system (hệ thống tích hợp) hoàn hảo cho tình huống này. Kết hợp với systemd service recovery cho tôi efficient two-layer crash recovery mechanism (cơ chế khôi phục sự cố 2 lớp) không cần can thiệp vật lý.
 Liên quan
Linux đã có built-in recovery mechanism
Watchdog timer bảo vệ hệ thống
Linux có built-in feature tên watchdog, hoạt động trên nguyên tắc hệ thống regularly send signal (gửi tín hiệu đều đặn) cho thấy nó vẫn active. Khi nó không nhận signal từ hệ thống, watchdog assume (giả định) có vấn đề và trigger reboot. Feature này tồn tại từ giữa những năm 1990 trên Linux, dùng chủ yếu trên hệ thống uptime non-negotiable (không thể thương lượng), như server và embedded system.
Trên một số hệ thống, watchdog exposed qua device file /dev/watchdog, trên khác có thể là /dev/watchdog0. Process phải write vào file này để reset countdown timer. Nếu process stop writing, thường nghĩa là hệ thống frozen hoặc resource bị consumed bởi runaway process. Trong trường hợp đó, timer expire, và đó là cách reboot được trigger.
Có 2 loại watchdog: hardware và software (softdog). Thứ nhất có thể là hardware mechanism trên motherboard. Luôn capable of (có khả năng) system reset, ngay khi kernel completely locked up. Thứ hai là software version chạy trong kernel, không cần hardware thêm. Version này, tuy nhiên, không save bạn nếu có kernel crash.
Type
Needs dedicated hardware
Survives a hard kernel crash
Best suited for
Hardware watchdog
Yes
Yes
Servers, always-on critical systems
Software (softdog)
No
No
Home servers, VMs, general-purpose rigs
Software watchdog great cho common freezes hầu hết setup gặp, như load spike, memory exhaustion, runaway process. Tuy nhiên, feature này disabled by default, và misconfiguring (cấu hình sai) có thể gây unnecessary và repeated system reboot. That said, nó trở thành một trong hidden Linux feature yêu thích của tôi.
Thiết lập automatic crash recovery trong vài phút
Watchdog setup practical thực sự chạy
softdog đã chạy trên hầu hết Linux distro, nên bạn không cần hardware mới. Starting point là load module lệnh:
sudo modprobe softdog
Đảm bảo softdog persist sau reboot, mở file /etc/modules (Debian/Ubuntu), thêm softdog dòng riêng, save. Bây giờ cài watchdog daemon và enable:
sudo apt install watchdog
sudo systemctl enable --now watchdog
Xong, mở /etc/watchdog.conf focus setting quan trọng:
Setting
What it controls
Practical starting point
interval
Hệ thống check-in bao lâu一次
10 seconds
max-load-1
Load average ceiling trước reboot
~6× CPU core count
min-memory
Free memory floor trước reboot
~512 pages (~2MB)
Load average cho max-load-1 là một phút. Giá trị này represent (đại diện) số process actively compete (cạnh tranh) CPU time. Nghĩa là nếu máy 4-core có load 4.0, mọi core fully occupied. An toàn hơn dùng 6x core count để hệ thống có headroom cho burst (bùng nổ) có thể legitimate trước lockup.
Cũng lưu ý min-memory specified in memory pages, không phải megabyte. One page typically 4KiB trên x86_64. Theo đó, 512 pages ~2MB free memory.
Sau config, chạy systemctl status watchdog verify daemon running, và journalctl -u watchdog review activity.
Stop watchdog service không trigger reboot — daemon close /dev/watchdog cleanly on exit, safely disarms timer. Để test watchdog reboot hệ thống, cần simulate real failure condition, như sustained load spike.
Không phải crash nào cũng cần reboot
Để systemd fix broken service trong giây
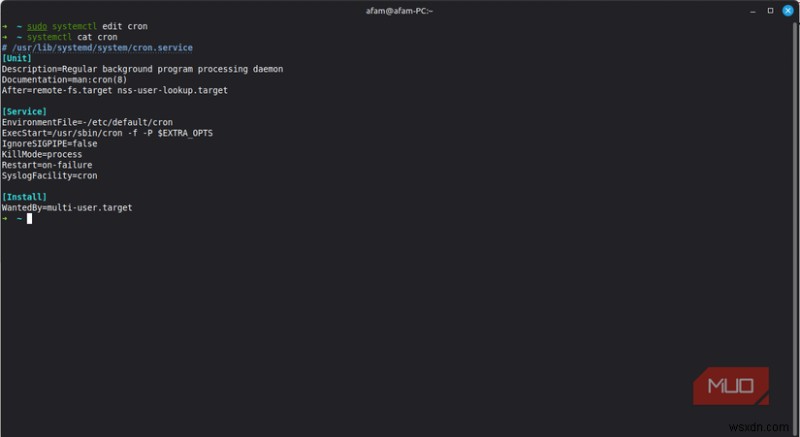
Có vài failure systemd handle trong giây không cần reboot system. Ví dụ: service crash, exit unexpectedly, hoặc stop responding. Bạn apply check để không mọi thứ trigger reboot không touch original unit. Chạy lệnh dưới, thêm service name:
sudo systemctl edit
Sau đó thêm:
[Service]
Restart=on-failure
RestartSec=5
Restart=on-failure đảm bảo restart chỉ khi service exit với error code, RestartSec=5 delay ngắn trước restart thực tế để prevent rapid-fire restart loop.
Kết hợp StartLimitIntervalSec và StartLimitBurst sẽ prevent broken service restart indefinitely. Chúng essential (thiết yếu) stop crash loop, nhưng chỉ work cho service chạy trong systemd.
Hai layer recovery cover gần như mọi failure
Cả watchdog và systemd Service Management không complete (hoàn chỉnh) riêng lẻ. Tuy nhiên, dùng cùng nhau, chúng handle hầu như mọi thứ.
Failure type
Recovery layer
Expected outcome
Service exits with an error
systemd (Restart=on-failure)
Service restart trong giây
Service exits cleanly nhưng không nên
systemd (Restart=always)
Service restart trong giây
Full system freeze hoặc load spiral
watchdog daemon
Auto reboot, không manual step
Systemd well-suited (phù hợp) catch và restart individual service failure, watchdog sit above (ngồi trên) watch toàn hệ thống và trigger restart khi thứ gì wrong beyond limits (vượt giới hạn) của systemd.
Kết hợp này nghĩa là bạn không phải available mọi khi thứ gì wrong, và làm server management pleasant (thoải mái) hơn. Cũng cân nhắc học lệnh Linux cụ thể giúp fix hầu hết system problem.