
Trong những năm gần đây, kiến trúc serverless và edge computing đang trở nên rất phổ biến cho triển khai ứng dụng. Nhưng lưu trữ trạng thái ứng dụng và dữ liệu bên trong serverless và/hoặc edge function là câu chuyện khác. Có nhiều khó khăn như: quản lý kết nối đến cơ sở dữ liệu, làm cho dữ liệu có sẵn để truy cập nhanh từ nhiều vị trí, v.v. Chỉ có một vài dịch vụ database hỗ trợ truy cập serverless và rất ít trong số đó cũng phù hợp cho edge functions. (Bạn có thể đọc phân tích chi tiết tại đây.)
Tại Upstash, từ ngày đầu, chúng tôi cung cấp cơ sở dữ liệu tương thích Redis serverless cho độ trễ thấp và mô hình định giá per-request. Ngoài ra, chúng tôi cung cấp REST API hạng nhất xây dựng trực tiếp trên database. REST API loại bỏ phiền toái quản lý kết nối, đặc biệt khi dùng trong serverless functions, nhưng cũng truy cập được ngay cả từ môi trường bị hạn chế như edge locations hoặc trình duyệt web.
Hôm nay chúng tôi vui mừng công bố Global Database, bước tiến hơn để làm cho database có sẵn toàn cầu, gần hơn với client và edge locations để đọc độ trễ thấp. Global Database có sẵn trên gói miễn phí, bạn có thể thử mà không tốn chi phí.
Khi nào sử dụng?
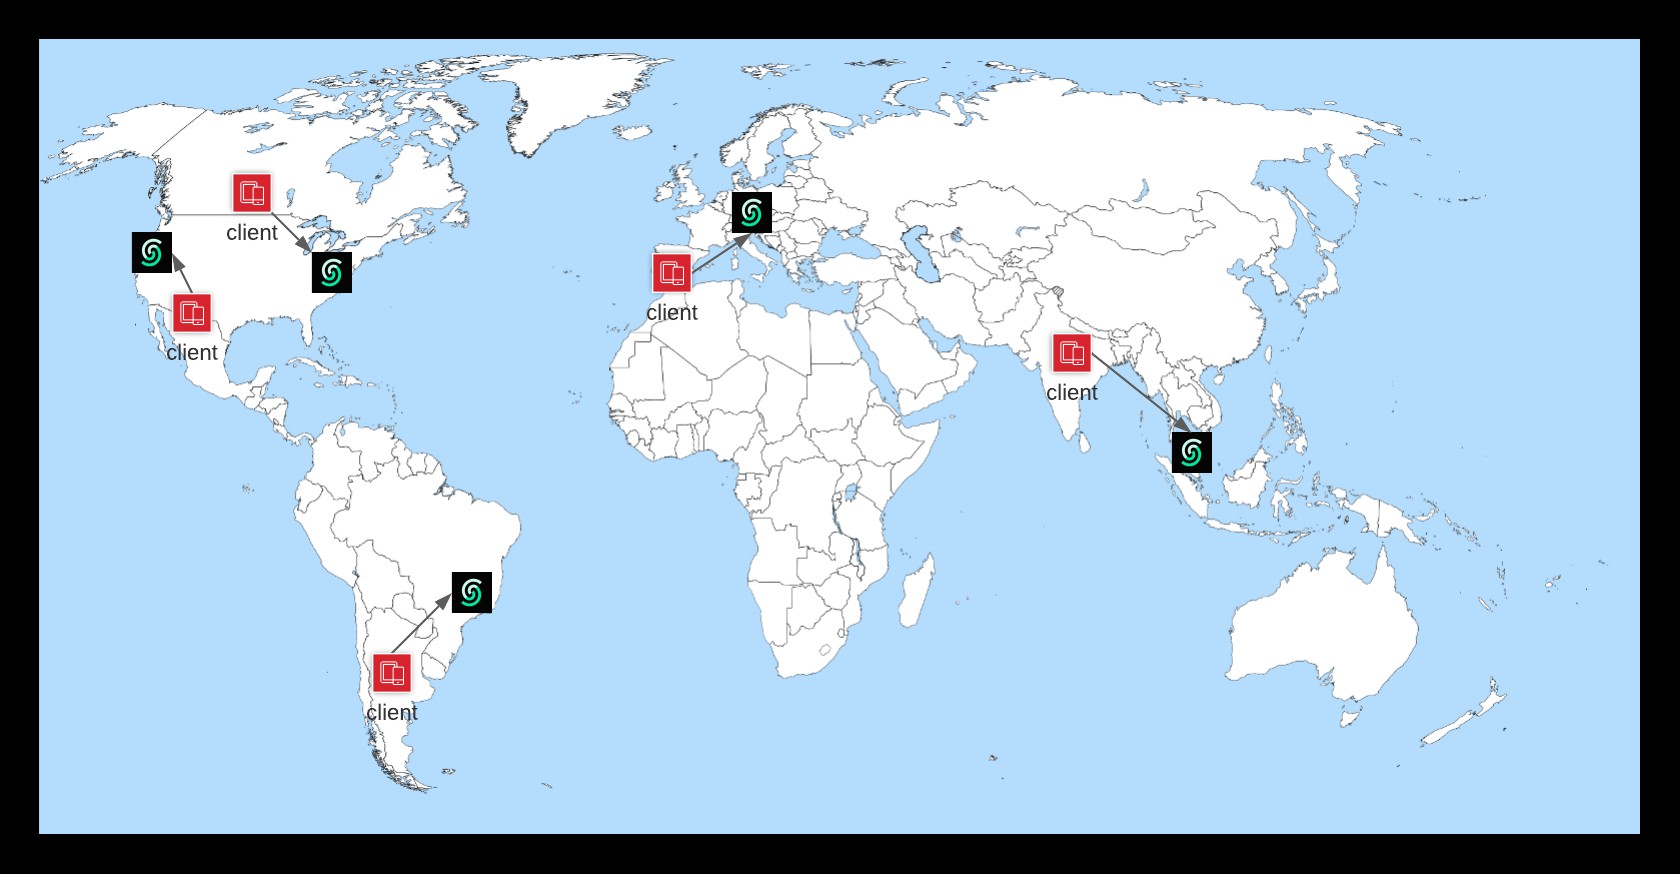
Global Database được triển khai ở nhiều region trên các châu lục khác nhau và request client được định tuyến đến region gần nhất để giảm thiểu độ trễ khi người dùng phân tán khắp thế giới. Upstash Global databases có thể dùng cho:
-
Edge functions (Cloudflare workers, Fastly Compute): REST API tích hợp sẵn và truy cập độ trễ thấp từ tất cả edge locations làm nó trở thành giải pháp hoàn hảo.
-
Triển khai serverless đa region: AWS Lambda, Vercel và Netlify functions có thể triển khai đa region. Global Database cung cấp độ trễ dữ liệu thấp nơi serverless functions của bạn ở đâu.
-
Nền tảng Web/di động: Dùng REST API read-only, bạn có thể truy cập Redis database trực tiếp từ ứng dụng web/di động. Global Database sẽ cung cấp độ trễ tốt hơn như bạn mong đợi người dùng từ bất kỳ đâu.
Mục tiêu khác sau Global Database là làm database có khả năng chịu lỗi (resilient) với region-wide failures. Khi một region không khả dụng, request được định tuyến đến region khả dụng gần nhất; nên database vẫn khả dụng.
Cách thức hoạt động?
Trong mô hình global database, có nhiều replica của cùng database và chúng hình thành một cluster. Mỗi replica kết nối với các thành viên cluster khác và theo dõi sự sống của từng replica dùng failure detector. Cả cluster membership và failure detection được quản lý bằng giao thức giao tiếp dựa trên gossip. (Xem SWIM: scalable weakly-consistent infection-style process group membership protocol.)
Để sao chép dữ liệu (cụ thể hơn, từng ghi/cập nhật/xóa riêng lẻ), mô hình single leader replication được dùng. Một nhóm key được gán cho replica leader, được bầu chọn bằng cơ chế leader election sau thay đổi membership. Các replica còn lại trở thành backup của leader đó cho nhóm key đó. Khi replica leader bị failure detector phát hiện failed, các replica còn lại bắt đầu vòng leader election mới và bầu leader mới. Trong quá trình bầu cử, database tạm thời không khả dụng và tất cả request bị chặn cho đến khi election hoàn tất.
Chỉ replica leader chấp nhận và xử lý request ghi, backup replica nội bộ forward ghi đến leader mà không thông báo cho client. Vì vậy bất kể loại replica, leader hay backup, client đều có thể gửi request ghi. Sau khi xử lý request ghi, replica leader lan truyền nó đến các backup replica.
Thêm về tính nhất quán (consistency)
Hiện tại, Global Databases là weakly consistent (nhất quán yếu), chưa hỗ trợ strong consistency. Phản hồi request ghi trả về client sau khi replica leader xử lý xong, không chờ ACK từ đa số backup. Kết quả ghi được sao chép đến backup replica bất đồng bộ song song.
Request đọc được xử lý bởi bất kỳ replica nào, cho độ mở rộng đọc tốt hơn nhưng cũng có nghĩa là request đọc có thể trả giá trị cũ (stale) cho đến khi kết quả ghi cho cùng key đến backup replica.
Sẽ dễ dàng hơn nếu không có xung đột!
Trong trường hợp cluster-wide failure như network partition, nhiều leader có thể được bầu cho cùng key. Nghĩa là nhiều replica chấp nhận ghi và dữ liệu phân hóa trên các replica khác nhau. Có thể ngăn xung đột từ đầu bằng mô hình mạnh hơn dùng giao thức như Calvin hoặc Spanner (hoặc thậm chí Paxos, Raft), nhưng đó là con đường khác chúng tôi không muốn đi lúc này.
Thay vào đó, Global Database cho phép xung đột xảy ra và giải quyết dùng thuật toán LWW (last-write-wins) và hội tụ replica về cùng trạng thái cuối cùng (eventually). Mỗi ghi trong Upstash database có sequence number duy nhất, đơn điệu. Mỗi khi replica trở thành leader, nó đánh dấu sequence của ghi đầu tiên nó xử lý. Khi hai leader replica khám phá nhau, chúng chia sẻ ghi sau khi trở thành leader, và giải quyết xung đột.
Không phải replica nào cũng ngang nhau
Một số replica "ngang nhau" hơn. Bởi chỉ một số có thể được bầu leader. Trong cluster global database, replica có thể đánh dấu learner, làm nó không phù hợp cho leader election. Learner replicas luôn readonly và không thể ứng cử leadership.
Thêm learner replicas không ảnh hưởng độ ổn định cluster và chúng không gây xung đột ghi khi bị tách biệt. Ngay khi tách khỏi leader, chúng vẫn cho phép request đọc và sync các ghi còn lại sau khi partition chữa lành. Vì vậy learner replicas là tiện ích rất tốt để mở rộng thêm edge locations.
Nhiều region, nhiều replica?
Trong bản phát hành ban đầu, chúng tôi cung cấp Global Database với 5 replica ở 5 region. Và replica ngoài US và EU được đánh dấu learners, nên chỉ replica ở region US và EU có thể bầu leader. Điều này thu hẹp khả năng xung đột ghi khi network partition. Nhưng cũng cho phép thêm nhiều region làm learner replicas mà không lo network partition.
Còn đường dài phía trước
Hiện Global Databases chỉ thiết kế tối ưu/thiểu hóa độ trễ thao tác đọc. Chúng không phù hợp cho tải ghi nhiều (write-heavy). Chúng tôi đang cải thiện độ trễ ghi với thiết kế tốt hơn.
Ngoài thiết lập 5 region ban đầu, chúng tôi cân nhắc mở thêm region và/hoặc nhóm region khác trong tương lai do nhu cầu và phản hồi từ người dùng.
Bạn có thể liên hệ chúng tôi trên Twitter và Discord để chia sẻ suy nghĩ/ý tưởng và câu hỏi.