
Trực quan hóa dữ liệu là bước quan trọng vì nó giúp hiểu điều gì đang diễn ra trong dữ liệu mà không cần nhìn vào con số và thực hiện các phép tính phức tạp. Seaborn là một thư viện hỗ trợ trực quan hóa dữ liệu. Nó đi kèm với các chủ đề tùy chỉnh và giao diện cấp cao.
Các biểu đồ phân tán thông thường, histogram, v.v. không thể sử dụng khi các biến cần xử lý mang tính phân loại (categorical). Đây là lúc cần dùng biểu đồ phân tán phân loại.
Các biểu đồ như stripplot, swarmplot được dùng để làm việc với biến phân loại. Hàm stripplot được sử dụng khi ít nhất một trong các biến là phân loại. Dữ liệu được biểu diễn theo thứ tự đã sắp xếp theo một trong các trục. Tuy nhiên, nhược điểm là một số điểm bị chồng chéo lên nhau. Đây là lúc tham số jitter cần được sử dụng để tránh chồng chéo giữa các biến.
Nó thêm một lượng nhiễu ngẫu nhiên nhỏ vào tập dữ liệu và điều chỉnh vị trí của các giá trị theo trục phân loại.
Cú pháp hàm stripplot
seaborn.stripplot(x, y, data, jitter=...)
Hãy xem cách tham số jitter có thể được dùng để vẽ các biến phân loại trong tập dữ liệu:
Ví dụ
import pandas as pd
import seaborn as sb
from matplotlib import pyplot as plt

my_df = sb.load_dataset('iris')
sb.stripplot(x="species", y="petal_length", data=my_df, jitter=True)
plt.show()
Đầu ra
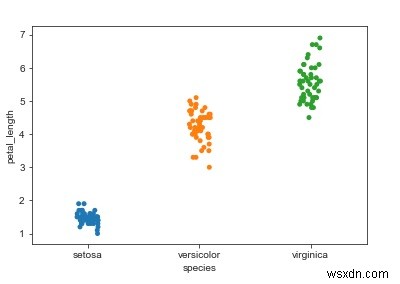
Giải thích
- Nhập các gói thư viện cần thiết.
- Dữ liệu đầu vào là 'iris_data' được tải từ thư viện scikit-learn.
- Dữ liệu này được lưu trữ trong một DataFrame.
- Hàm
load_datasetđược dùng để tải dữ liệu iris. - Dữ liệu được trực quan hóa bằng hàm
stripplot. - Một tham số bổ sung tên là
jitterđược truyền vào để tránh chồng chéo các giá trị của DataFrame. - Ở đây, DataFrame được cung cấp làm tham số.
- Cũng chỉ định các giá trị x và y.
- Dữ liệu này được hiển thị trên console.
Mẹo: Khi jitter=True, Seaborn tự động thêm nhiễu ngẫu nhiên nhỏ theo trục phân loại. Có thể truyền giá trị float (ví dụ jitter=0.2) để kiểm soát độ lớn nhiễu.