
Parsing là nghệ thuật biến một mớ chuỗi thành dữ liệu có cấu trúc, dễ hiểu. Regex có thể dùng nhưng không phù hợp mọi trường hợp.
Ví dụ: parse HTML bằng regex là ý tưởng tồi. Ruby có Nokogiri làm sẵn, nhưng tự xây parser giúp hiểu sâu hơn. Bắt đầu thôi!
Parsing Với Ruby
Cốt lõi là class StringScanner - giữ bản sao chuỗi và con trỏ vị trí để duyệt qua các token.
Các phương thức chính:
.peek- xem trước không di chuyển con trỏ.scan_until- quét đến pattern, di chuyển con trỏ.getch- đọc 1 ký tự, di chuyển con trỏ
Cũng hữu ích: .scan (không có until).
Lưu ý: Nếu StringScanner không có sẵn, thêm require 'strscan'
Hai test minh họa cách hoạt động:
describe StringScanner do
  let(:buff) { StringScanner.new "testing" }
  it "can peek one step ahead" do
    expect(buff.peek(1)).to eq "t"
  end
  it "can read one char and return it" do
    expect(buff.getch).to eq "t"
    expect(buff.getch).to eq "e"
  end
end
Quan trọng: một số phương thức tiến con trỏ (getch, scan), البعض không (peek). Dùng .inspect hoặc p để xem vị trí hiện tại.
Class Parser
Class Parser chứa logic chính, khởi tạo với chuỗi cần parse, tạo StringScanner và gọi parse:
def initialize(str)
  @buffer = StringScanner.new(str)
  @tags = []
  parse
end
Test định nghĩa như sau:
let(:parser) { Parser.new "<body>testing</body> <title>parsing with ruby</title>" }
Class Tag
Class đơn giản chứa kết quả parse:
class Tag
  attr_reader :name
  attr_accessor :content
  def initialize(name)
    @name = name
  end
end
Bắt Đầu Parse!
HTML có dạng: <tag>nội dung</tag>
Hai thành phần: tên tag và nội dung. Grammar BNF:
tag = <opening_tag> <contents> <closing_tag>
opening_tag = "<" <tag_name> ">"
closing_tag = "</" <tag_name> ">"
Dùng peek kiểm tra ký tự tiếp theo là "<", nếu đúng thì gọi find_tag và find_content:
def parse_element
  if @buffer.peek(1) == '<'
    @tags << find_tag
    last_tag.content = find_content
  end
end
find_tag:
- Tiêu thụ ký tự "<"
- Quét đến ">"
- Tạo Tag object với tên tag (cắt bỏ ">" cuối vì
scan_untilbao gồm nó)
def find_tag
  @buffer.getch
  tag = @buffer.scan_until(/>/)
  Tag.new(tag.chop)
end
find_content - quét đến closing tag và trả về nội dung:
def find_content
  tag = last_tag.name
  content = @buffer.scan_until(/<\/#{tag}>/)
  content.sub("</#{tag}>", "")
end
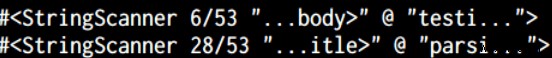
Gọi parse_element trong vòng lặp cho đến hết buffer:
def parse
  until @buffer.eos?
    skip_spaces
    parse_element
  end
end
Code hoàn chỉnh: GitHub. Nhánh nested_tags hỗ trợ tag lồng nhau.
Kết Luận
Viết parser thú vị nhưng có thể phức tạp. Không muốn tự viết? Dùng parser generators như treetop hoặc parslet trong Ruby.