
Làm thế nào để đọc kế hoạch thực thi? Từ phải sang trái, trái sang phải, hay kiểm tra chi phí? Hay các đối tượng như index scan, table scan và lookup? Blog này thảo luận cách đọc kế hoạch thực thi đồ họa của Microsoft® SQL Server.
Giới thiệu
Mặc dù SQL Server thường tạo ra kế hoạch tốt, nhưng đôi khi nó không đủ thông minh để xác thực kế hoạch và sửa chữa những kế hoạch kém.
Bạn có thể lấy kế hoạch thực thi ước lượng và kế hoạch thực thi đồ họa thực tế trong SQL Server. Tạo các kế hoạch này bằng lệnh Ctrl+M hoặc Ctrl+L hoặc sử dụng các biểu tượng bên phải biểu tượng thực thi trên thanh công cụ tiêu chuẩn của SQL Server Management Studio (SSMS). SQL Server còn có các loại kế hoạch khác, nhưng không được đề cập trong bài này.
Kế hoạch thực thi ước lượng và thực tế
Có hai loại kế hoạch thực thi:
- Kế hoạch thực thi ước lượng: Cung cấp ước lượng về công việc SQL Server dự kiến thực hiện để lấy dữ liệu.
- Kế hoạch thực thi thực tế: Được tạo sau khi truy vấn Transact-SQL hoặc batch được thực thi. Do đó, kế hoạch thực tế chứa thông tin runtime, như số liệu sử dụng tài nguyên thực tế và các cảnh báo runtime.
Xử lý dữ liệu
Bạn có bao giờ nhận ra sự khác biệt giữa kế hoạch ước lượng và kế hoạch thực tế cho cùng một truy vấn? Đa số thời gian chúng giống nhau, nhưng có thể khác do thay đổi thống kê, thay đổi schema hoặc thay đổi dữ liệu. Bạn nên luôn kiểm tra kế hoạch thực tế khi khắc phục sự cố.
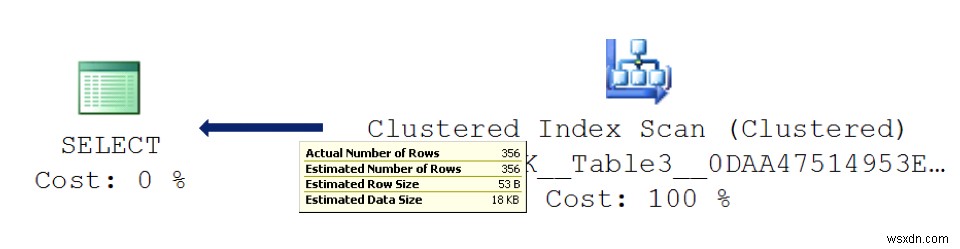
Đọc kế hoạch thực thi đúng cách để xác định điểm thực sự. Bắt đầu bằng cách nhìn luồng dữ liệu thay vì chi phí. Đừng nghĩ về đọc logic hoặc vật lý. Việc giảm thiểu số hoạt động nhập/xuất (I/O) là quan trọng. Là một quản trị viên cơ sở dữ liệu (DBA), bạn biết truy cập bộ nhớ là tài nguyên phần cứng chậm nhất, nên bạn nên cố gắng giảm thiểu hoạt động này. Vậy làm thế nào để khám phá thống kê, và kế hoạch thực thi có hiển thị không? Có, nó hiển thị! Kiểm tra các đường hướng bằng cách di chuột qua chỉ báo từ phải sang trái. Nó hiển thị số bản ghi và kích thước dữ liệu. Mỗi đường dày hoặc mỏng dựa trên khối lượng dữ liệu trả về bởi hoạt động như minh họa sau:
Nếu bạn có nhiều đối tượng, bạn cần cách tốt hơn để có cái nhìn tổng quan về lượng dữ liệu được xử lý bởi mỗi hoạt động. Tải xuống SentryOne Plan Explorer và xem kế hoạch bằng công cụ này để dễ dàng có cái nhìn tổng quan.
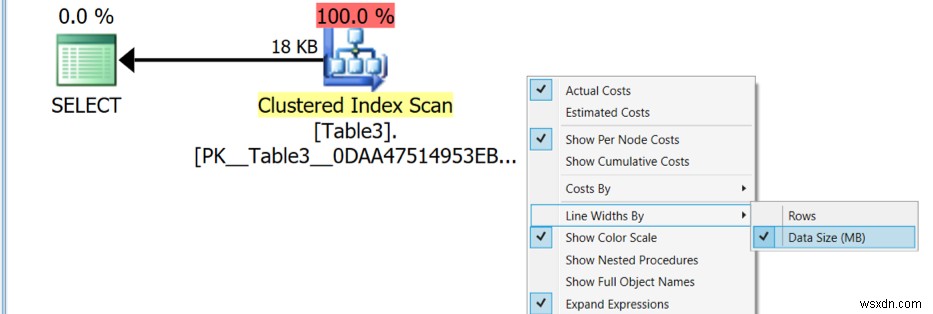
Sau khi tải xuống và cấu hình SentryOne trên hệ thống, mở kế hoạch thực thi với nó. SentryOne có nhiều view và mô tả, bạn có thể sử dụng theo nhu cầu. Để có view xử lý dữ liệu, thay đổi view bằng cách chọn tùy chọn Data size in MB như hình sau. Mục tiêu của bạn là tìm cơ hội giảm tổng xử lý dữ liệu.
Nếu bạn cần giảm áp lực I/O, bạn có thể xem giá trị T-SQL SET STATISTICS IO ON để có ý tưởng tổng quan về việc sử dụng I/O cho truy vấn. Bạn nên đặt điều này trước khi thực thi truy vấn trong SSMS để thấy chuyển tab message trong panel result. Nó trông giống như kết quả sau:
(356 row(s) affected) Table 'Table3'. Scan count 1, logical reads 5, physical reads 0, read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob read-ahead reads 0.
Kết quả logical reads 5 cho thấy SQL Server đọc 40 KB (5 * 8 KB) trang để lấy dữ liệu từ bộ nhớ. Khi tối ưu hóa truy vấn, đừng bỏ qua logical reads vì điều này có thể là vật lý cũng như logic trên server thực tế. Bạn không bao giờ biết các trang bạn tham chiếu có nằm trong bộ nhớ hay trên đĩa. Mục tiêu nên là giảm số lượng hoạt động đọc tích lũy.
Kế hoạch ước lượng so với thực tế
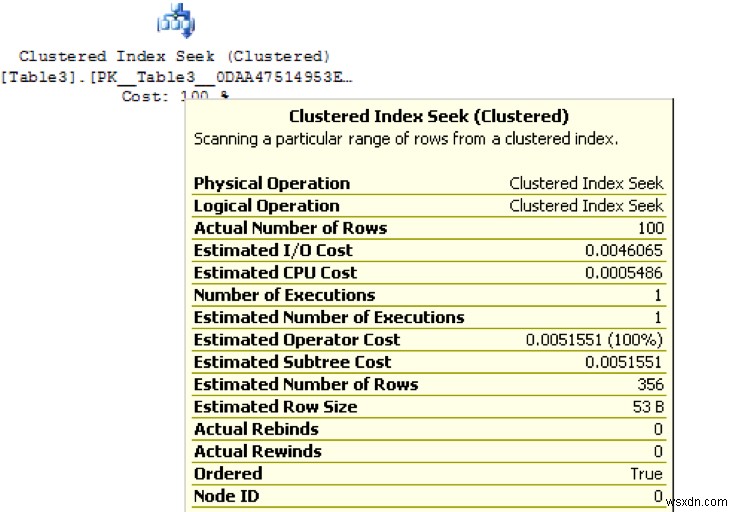
Sau khi kế hoạch thực tế được tạo, di chuột qua bất kỳ hoạt động hoặc đơn vị logic nào trong kế hoạch thực thi. Tham khảo hình sau để xem loại hoạt động vật lý, như kết quả Clustered Index Seek hoặc Scan. Tìm số lần thực thi và số hàng thực tế và ước lượng. Tránh nhìn chi phí của các hoạt động riêng lẻ vì đó là ước lượng tính bằng giây dựa trên phần cứng cũ và có thể không cung cấp chi tiết chính xác. Trong hình sau, toán tử Clustered Index Seek thực thi một lần để lấy 100 bản ghi, SQL ước lượng 356 bản ghi. Sự khác biệt có thể do thống kê lỗi thời hoặc hiệu suất truy vấn.
Lặp thực thi
Hình sau cho thấy số lần thực thi ước lượng là 1.154.121 lần trên clustered index để lấy một bản ghi. Điều đó đáng kể. Mặc dù chi phí toán tử thấp hơn, và chúng ta có thể đã bỏ qua nó, thay vào đó nhìn vào các hoạt động khác với chi phí cao hơn, đây có thể là một lựa chọn tốn kém. Các hoạt động như vậy có tác động lớn đến hiệu suất truy vấn dù có clustered index. Tra cứu Row ID (RID) là hoạt động tương tự cho heap.
Cơ sở dữ liệu tạm (tempdb)
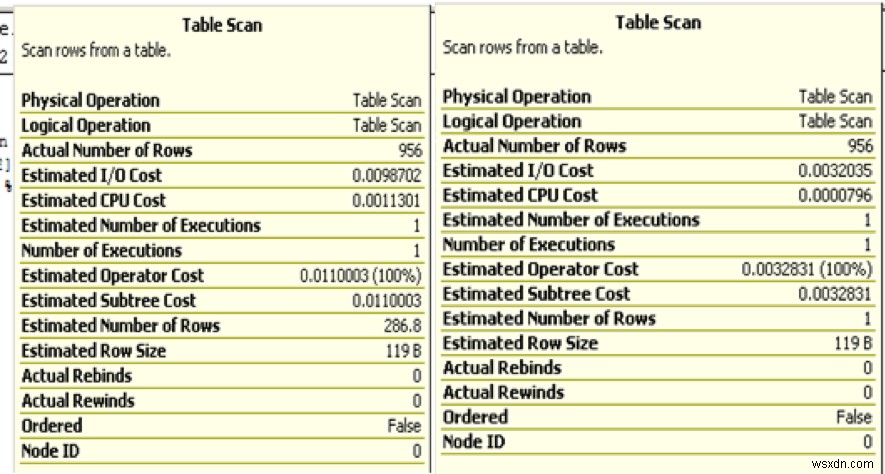
Sự khác biệt giữa số bản ghi ước lượng và thực tế là điều khác bạn nên cân nhắc. Ước lượng sai có thể dẫn đến truy vấn bị cấp phát bộ nhớ hạn chế. Khi đó, nó sử dụng cơ sở dữ liệu tạm (tempdb) để hoàn thành công việc. Lựa chọn sai toán tử hoặc kế hoạch bởi SQL Server có thể dẫn đến hoạt động chậm và trích xuất truy vấn, như hình sau. Số bản ghi thực tế giống nhau, nhưng ước lượng khác nhau. Điều này có thể do thống kê lỗi thời hoặc thiếu. Lưu ý rằng biến bảng (table variables) không có thống kê, nên kế hoạch luôn trả về 1 và 1K trong các bản phát hành mới cho đến khi tùy chọn recompile được sử dụng. Do đó, biến bảng không phải lựa chọn tốt cho số lượng bản ghi lớn.
Toán tử Sort (Sắp xếp)
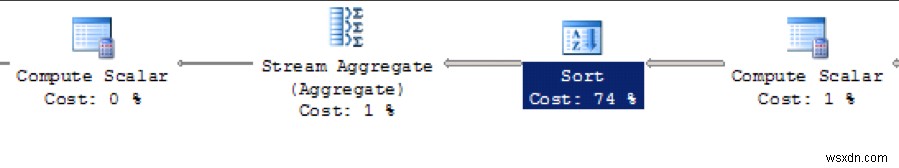
Bạn cần xem xét tác động của sắp xếp. Toán tử Sort chủ yếu dùng cho các hàm: aggregate, merge join, hoặc mệnh đề order by. Điều này có thể không có tác động với vài bản ghi, nhưng với mỗi bản ghi thêm vào, xử lý chậm lại. Cố gắng tránh sắp xếp hoặc không dùng mệnh đề order by. Nếu sắp xếp là bắt buộc, hãy dùng lưới ứng dụng để sắp xếp thay vì gửi dữ liệu đã sắp xếp đến ứng dụng.
Hình sau cho thấy chi phí sort:
Toán tử Spool
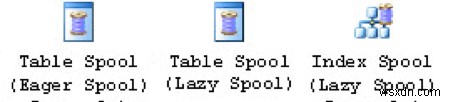
Một toán tử quan trọng khác cần xem là spool. Spool là toán tử chậm vì nó lưu trữ các đối tượng ẩn hoặc bảng làm việc tạm trong tempdb. Điều này cũng làm chậm với các toán tử cụ thể khiến nó rebind hoặc rewind. Có nhiều loại spool trong SQL Server, như Eager, Lazy, Table/Index, v.v. SQL Server sử dụng spool khi tốt hơn tham chiếu bảng làm việc tạm thay vì quay lại bảng nguồn cho tập kết quả trung gian. Hình sau cho thấy ví dụ:
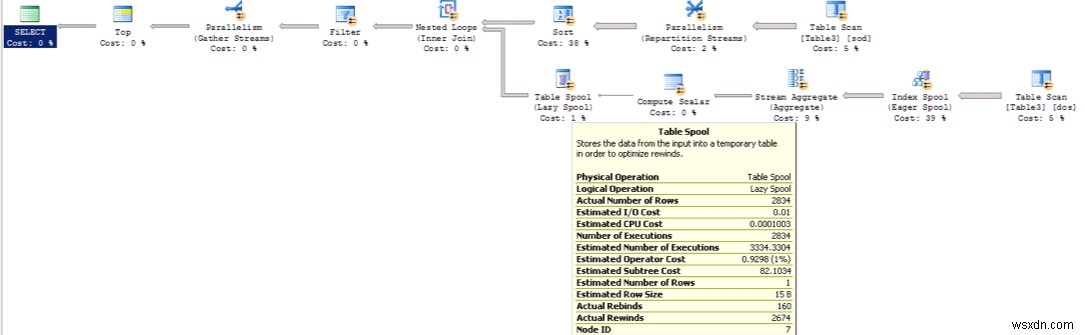
Với spool, quan trọng là nhận thấy số lượng rebind và rewind. Rewind tốn kém hơn rebind. Ví dụ, trong hình sau, toán tử hiển thị 2674 rewind, ngụ ý truy vấn được thực thi lại 2674 lần để lấy dữ liệu. Nó trả về từng toán tử từ table spool đến table scan để lấy từng bản ghi trong rewind. Rebind nghĩa là nó lấy dữ liệu từ spool và không quay lại table scan.
Toán tử Hash và Nested Loop
Vì chúng hoạt động tốt trên tập bản ghi nhỏ, hash và nested loop là các toán tử tiếp theo bạn nên xem xét. Tuy nhiên, đối với tập bản ghi lớn, hoặc khi có sự chênh lệch lớn giữa kế hoạch ước lượng và thực tế, các toán tử này có thể tạo tác động lớn vì chúng có thể dùng tempdb thay vì bộ nhớ. SQL Server đăng cảnh báo sau trong chi tiết toán tử: "operator used tempdb to spill data during executions". Nếu điều này xảy ra, hãy chú ý đến thống kê. Với ước lượng sai, vòng lặp thiếu cấp phát bộ nhớ hoặc tiếp tục lặp. Xem bộ nhớ được cấp phát cho thực thi. Để xem cấp phát bộ nhớ, mở hộp thuộc tính bằng cách chọn điểm bắt đầu của kế hoạch thực thi (từ trái sang phải). Nếu không có gì bất thường, thì điều chỉnh truy vấn (query tuning) nên là lựa chọn lý tưởng.
Kết luận
Mục tiêu đầu tiên để tối ưu hóa truy vấn nên là giảm tổng đọc và ghi (tức là I/O trên đĩa). Đừng quên logical reads cho đọc và ghi trong bộ nhớ. Giảm I/O giải quyết hầu hết vấn đề và truy vấn chạy nhanh hơn nhiều.
Tiếp theo, xem các hoạt động tốn kém do hoạt động trên tempdb. Nhớ rằng, tempdb được dùng cho nhiều hoạt động và luôn tốn kém. Tìm rewind - số lần thực thi của bất kỳ hoạt động nào, spools, sorting, và loops.
Chúng tốn kém khi dùng với tempdb. Đừng quên xem xét cảnh báo trên mỗi toán tử vì chúng cung cấp manh mối tốt. Mặc dù bài này không thảo luận toán tử missing index, không có nghĩa bạn có thể bỏ qua nó.
Xem xét nó, nhưng đừng tạo index một cách mù quáng. Kiểm tra các index khác trên cùng cột, và cân nhắc tác động đến các truy vấn đang chạy trong cơ sở dữ liệu của bạn.
Sử dụng tab Feedback để bình luận hoặc đặt câu hỏi. Bạn cũng có thể bắt đầu cuộc trò chuyện với chúng tôi.