
Truy xuất tăng cường sinh thành (Retrieval‑augmented generation - RAG) nhằm bổ sung kiến thức bên ngoài cho các mô hình ngôn ngữ lớn (LLM). Nó có thể hoạt động rất đẹp trong demo: bộ dữ liệu nhỏ được tuyển chọn, truy vấn sạch, và ngân sách độ trễ không bị giới hạn dẫn đến câu trả lời có kiến thức, có căn cứ mà người dùng tin là đúng. Tuy nhiên, nhiều nhóm phát hiện rằng khi triển khai ứng dụng RAG cho người dùng, hiệu suất sụp đổ. Truy vấn trở nên mơ hồ, kho dữ liệu mở rộng, chất lượng truy xuất giảm, độ trễ phình to, và hệ thống lặng lẽ bắt đầu mất độ chính xác. Thậm chí tệ hơn, kỹ thuật đánh giá kém che giấu nơi hệ thống thực sự bắt đầu thất bại cho đến khi người dùng phàn nàn. Bài viết này khám phá lý do tại sao nhiều hệ thống RAG thất bại trong production. Chúng tôi tham khảo từ nghiên cứu gần đây và hướng dẫn ngành. Chúng tôi khung các vấn đề quanh chất lượng truy xuất, đánh đổi độ trễ, trôi dạt embedding (embedding drift), và khoảng trống đánh giá như các liên kết trong chuỗi các chế độ thất bại. Mỗi liên kết trong chuỗi này phải được tính đến để xây dựng hệ thống RAG production mạnh mẽ.
Những Điểm Chính (Key Takeaways)
- Hầu hết thất bại RAG bắt đầu từ truy xuất, không phải sinh thành. Khi hệ thống truy xuất bằng chứng không đầy đủ, không liên quan, hoặc xếp hạng kém, ngay cả LLM mạnh cũng tạo ra câu trả lời yếu.
- Truy xuất tốt hơn đòi hỏi lựa chọn kỹ thuật tốt hơn. Chunking nhận biết miền (domain-aware chunking), truy xuất kết hợp (hybrid retrieval), và xếp hạng lại (reranking) được trình bày như kỹ thuật cốt lõi để cải thiện độ liên quan và giảm thất bại truy xuất lặng lẽ.
- Độ trễ nhanh chóng trở thành nút thắt cổ chai production. Tăng top_k, thêm reranker, context dài, và bước truy xuất thêm có thể cải thiện recall, nhưng cũng có thể làm hệ thống quá chậm cho người dùng thực.
- Trôi dạt embedding (Embedding drift) làm giảm hiệu suất lặng lẽ theo thời gian. Thay đổi mô hình embedding, bộ sưu tập tài liệu, và từ vựng người dùng đều có thể dịch chuyển hành vi truy xuất, do đó versioning (phiên bản hóa) và observability (khả năng quan sát) là cần thiết.
- Chất lượng câu trả lời cuối cùng allein không đủ cho đánh giá. Nhóm cần metric truy xuất và sinh thành riêng biệt, bộ test thực tế, giám sát liên tục, và khả năng hệ thống từ chối trả lời khi bằng chứng yếu hoặc thiếu.
Thất Bại Do Chất Lượng Truy Xuất Kém
Chất lượng truy xuất thấp là một trong những nguyên nhân thường xuyên nhất gây thất bại hệ thống RAG khi triển khai production. Lập trình viên thường đổ lỗi cho LLM vì câu trả lời sai/kém; tuy nhiên, lỗi thường nằm ở phần đầu của pipeline. Nếu hệ thống không thể truy xuất bằng chứng đầy đủ hoặc liên quan, hoặc xếp hạng bằng chứng kém, ngay cả mô hình tốt nhất cũng khó tạo ra phản hồi đáng tin cậy. Chất lượng truy xuất nên được xem là mối quan tâm kỹ thuật hàng đầu thay vì bước nền.
Hầu hết thất bại xảy ra trước khi LLM thấy truy vấn
Pipeline tiêu chuẩn nhúng truy vấn người dùng, truy xuất top‑k tài liệu từ vector store, và gửi cho LLM. Mỗi mũi tên trong pipeline đó là điểm thất bại tiềm ẩn.
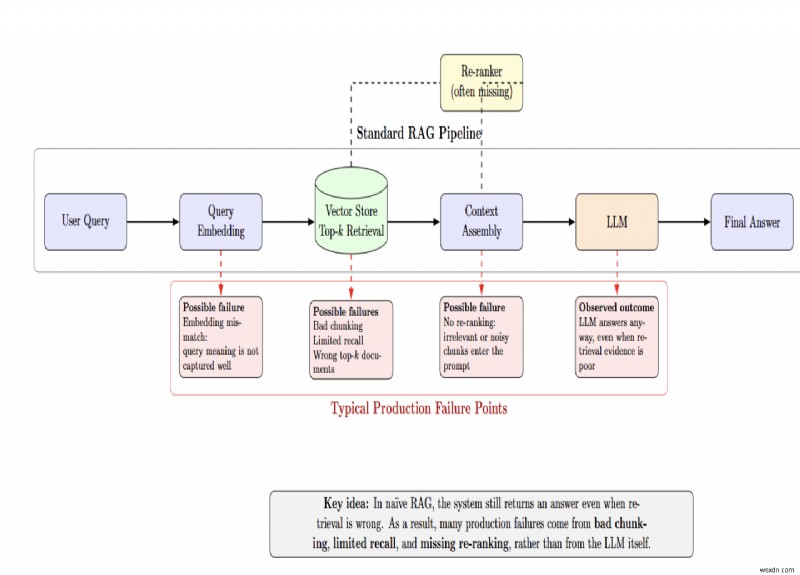
RAG ngây thơ (Naïve RAG) che giấu các thất bại này vì hệ thống cung cấp câu trả lời bất kể truy xuất đúng hay sai. Nhiều vấn đề production xuất phát từ chiến lược chunking kém, recall hạn chế, và thiếu re‑ranking, thay vì thiếu hụt của LLM.
Lỗi chunking tạo ra thất bại lặng lẽ
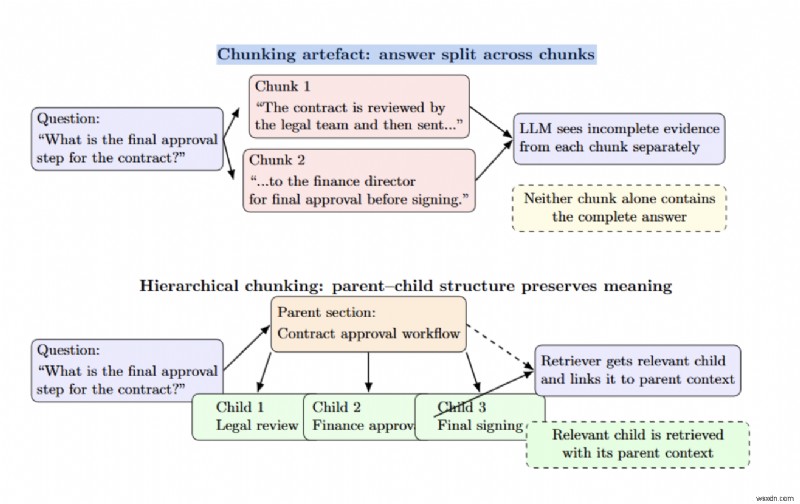
Kích thước chunk ảnh hưởng precision/recall — chunk lớn cung cấp nhiều ngữ cảnh hơn nhưng kém liên quan, chunk nhỏ cho precision cao hơn nhưng mất thông tin xung quanh. Chunking phân cấp (hierarchical/parent–child chunking) giải quyết đánh đổi này bằng cách lưu toàn bộ phần làm chunk cha (parent chunk) và chỉ truy xuất chunk con (child chunk) nhỏ hơn liên quan.
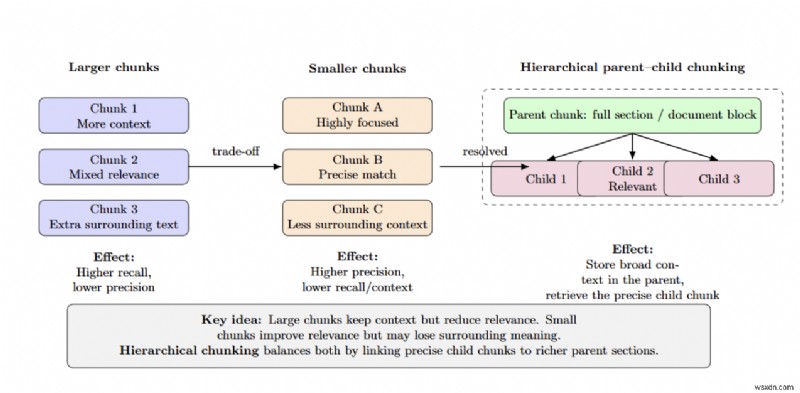
Thử nghiệm nội bộ của NVIDIA trên slide trình bày đại học cho thấy chunking phân cấp cải thiện độ chính xác câu trả lời từ 61% với chunk kích thước cố định lên 89%. Việc chọn kích thước chunk phù hợp đồng thời tôn trọng ranh giới cấu trúc và áp dụng chia tách nhận biết miền (domain‑aware splitting) là quan trọng.
Truy xuất kết hợp (Hybrid retrieval) và xếp hạng lại (re‑ranking)
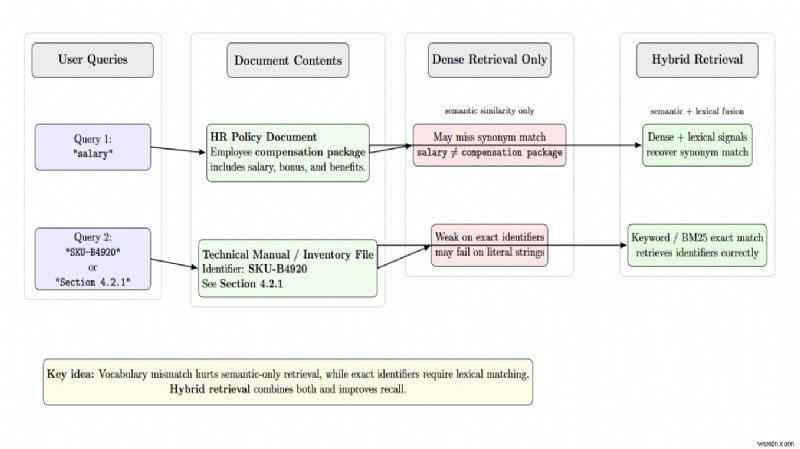
Truy xuất dense (vector) thuần túy giỏi về độ tương đồng ngữ nghĩa nhưng bỏ lỡ định danh chính xác. Tìm kiếm từ khóa (sparse/BM25) nhạy cảm với từ chính xác nhưng thất bại ở diễn đạt ngữ nghĩa. Hệ thống truy xuất kết hợp chạy truy xuất dense (vector) và sparse (BM25/từ khóa) đồng thời, sau đó hợp nhất kết quả bằng reciprocal rank fusion.
Hệ thống truy xuất kết hợp giải quyết mismatch từ vựng bằng cách kết hợp tín hiệu tương đồng ngữ nghĩa với tín hiệu khớp từ vựng. Điểm lại (rescoring) các cặp ứng cử viên bằng re‑ranker (cross‑encoder) sau khi fusion cải thiện recall. Về bản chất, reranker sắp xếp lại tài liệu truy xuất để chỉ tài liệu liên quan nhất vào context mà LLM xem xét. Điều này tiết kiệm giới hạn token và tránh nhồi nhét context (context stuffing) đồng thời cải thiện recall của LLM.
Metric truy xuất phải được giám sát riêng biệt
Nhóm thường chỉ đo chất lượng câu trả lời cuối cùng (end‑to‑end). Truy xuất bản thân có metric riêng: precision@k (tỷ lệ chunk truy xuất liên quan?), recall@k (tỷ lệ chunk liên quan đã truy xuất?), mean reciprocal rank (chunk liên quan đầu tiên ở đâu?), và normalized discounted cumulative gain (xếp hạng tổng thể tốt đến đâu?).
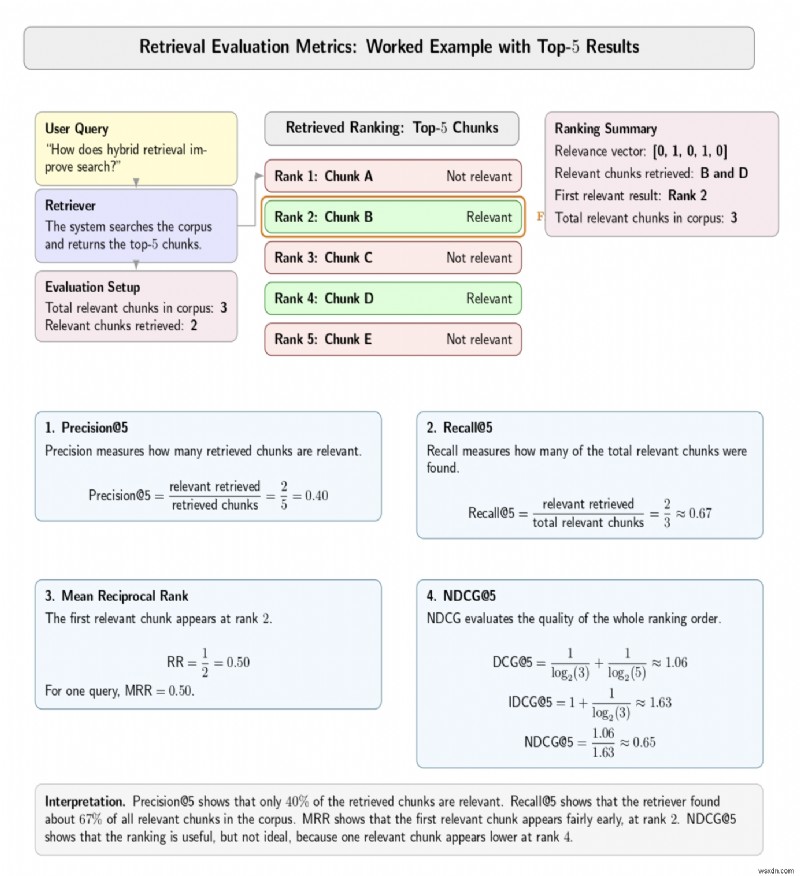
Nếu không đo các metric này, bạn không biết thất bại từ truy xuất kém hay generator kém. Truy vấn test và dataset vàng (golden datasets) cho phép đánh giá offline. Nếu theo dõi metric này trên truy vấn thực, bạn có thể phát hiện hồi quy production.
Chẩn đoán thất bại truy xuất với ví dụ
Truy vấn mơ hồ và mismatch từ vựng thường gây truy xuất sai. Người dùng tìm "salary" (lương) nhưng tài liệu dùng "compensation package" (gói thù lao). Dense embedding có thể không nhận ra từ đồng nghĩa, trong khi hybrid retrieval khắc phục. Trường hợp khác là khớp chính xác, như định danh (identifier). Truy vấn "SKU‑B4920" hoặc "Section 4.2.1" cần khớp từ vựng chính xác.
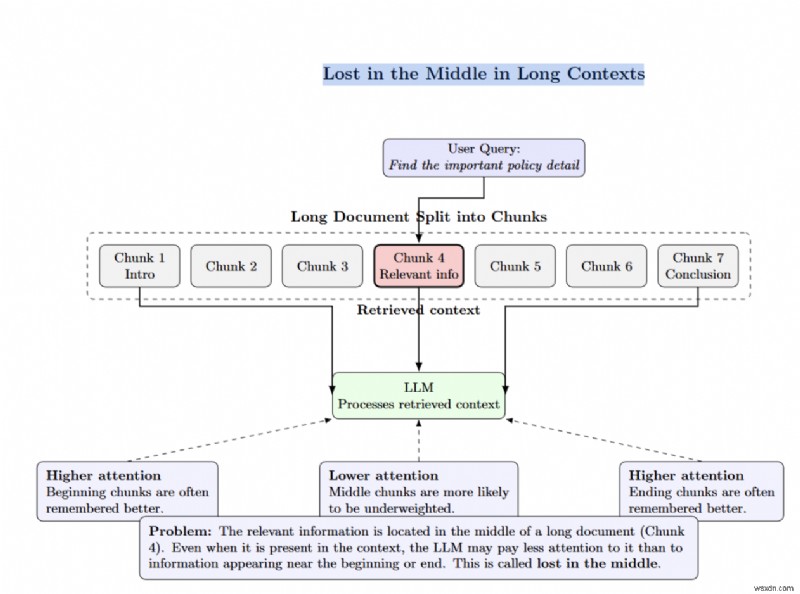
"Lost in the middle" (Lạc ở giữa) xảy ra khi thông tin liên quan bị chôn sâu trong tài liệu dài. LLM sẽ giảm trọng số token ở chunk giữa.
Nghiệp vụ chunking (Chunking artefacts) nảy sinh khi câu trả lời bị chia cắt qua hai chunk, nên không chunk nào chứa câu trả lời hoàn chỉnh. Chunking phân cấp giúp khắc phục bằng cách kết nối node cha và con.
Thất Bại Do Độ Trễ Phình To Trong Hệ Thống Thực
Độ trễ là một trong những lý do chính khiến hệ thống RAG chạy tốt trong demo lại gặp khó khăn trong production. Khi pipeline truy xuất trở nên tinh vi hơn, thời gian phản hồi tăng nhanh và buộc nhóm phải đánh đổi chất lượng câu trả lời với khả năng sử dụng.
Đánh đổi truy xuất – độ trễ (Retrieval–latency trade‑off)
Nhóm production thường phải cân bằng chất lượng truy xuất và ngân sách độ trễ. Mọi thứ làm tăng thời gian phản hồi (tăng top_k, thêm hybrid retrieval, reranking, chạy mô hình long‑context) cắt vào ngân sách đó. Đánh đổi đặc biệt khó vì người dùng mong đợi câu trả lời phản hồi nhanh, và tích hợp doanh nghiệp đi kèm ngân sách độ trễ cứng nhắc. Tuy nhiên, như công trình gần đây của Cornell và NVIDIA chứng minh, RAG gây ra chi phí độ trễ đáng kể. Chạy truy xuất quá thường xuyên có thể tăng độ chính xác, nhưng đẩy độ trễ end‑to‑end lên gần 30 giây — quá cao cho production.
Sinh thành thường chiếm ưu thế, nhưng truy xuất cũng quan trọng
Benchmark với RAGPerf cho thấy sinh thành thường là phần chiếm ưu thế trong pipeline RAG chỉ văn bản. Chọn LLM nhỏ hơn có thể giảm độ trễ mạnh mà không hy sinh chất lượng câu trả lời nếu chất lượng truy xuất được duy trì. Pipeline đa phương thức (retrieval PDF và hình ảnh) có nhu cầu tính toán lớn một phần do reranking và mô hình cross‑modal liên quan. Độ trễ truy xuất tăng khi vector database chậm hoặc không cho phép tra cứu đồng thời. Tuy nhiên, ngay cả với tra cứu nhanh, reranking có thể chiếm ưu thế tổng độ trễ cho nhiều workload RAG.
Độ trễ, chi phí, và cửa sổ ngữ cảnh (context windows)
Một số nhóm cố gắng giải quyết recall bằng cách tăng top_k hoặc nhồi nhét nhiều tài liệu vào context của LLM. Nghiên cứu cho thấy điều này có tác dụng ngược. Càng nhiều tài liệu thêm vào prompt, LLM càng kém nhớ thông tin đúng. Xếp hạng lại truy xuất (Retrieval reranking) giải quyết bằng cách truy xuất nhiều tài liệu, rồi chỉ chọn những cái tốt nhất cho LLM. Cửa sổ ngữ cảnh dài gây "lost in the middle" và chi phí tính toán khổng lồ.
Tối ưu hóa độ trễ
Giải quyết độ trễ trong hệ thống RAG đòi hỏi điều phối có chủ đích qua toàn bộ pipeline:
| Lĩnh vực tập trung | Cần làm gì | Tại sao quan trọng |
|---|---|---|
| Chất lượng truy xuất | Dùng chunking nhận biết miền thay vì cửa sổ cố định mặc định. Giữ cấu trúc tài liệu ở chỗ quan trọng. Kết hợp truy xuất dense và từ vựng. Thêm reranking. Dùng metadata thông minh. | Cải thiện độ bao phủ và liên quan, giúp hệ thống truy xuất ngữ cảnh hữu ích hơn cho câu trả lời có căn cứ (grounded). |
| Kiểm soát độ trễ | Đo mọi giai đoạn. Loại bỏ bước không mang lại lợi ích ý nghĩa. Giữ pipeline đơn giản theo mức độ use case cho phép. Xây dựng cho mẫu tương tác thực. | Giảm overhead không cần thiết, giữ hệ thống phản hồi nhanh trong production thực. |
| Quản lý trôi dạt (Drift management) | Phiên bản hóa embedding, index, chiến lược chunking, và chính sách ingestion. Đánh giá lại khi tài liệu thay đổi hoặc model đổi. Thiết kế tính mới (freshness) rõ ràng. | Ngăn chặn suy giảm chất lượng lặng lẽ khi nội dung, model, và mẫu truy vấn tiến hóa theo thời gian. |
| Đánh giá (Evaluation) | Duy trì golden datasets dựa trên truy vấn thực. Tách metric truy xuất khỏi metric sinh thành. Đo context precision, recall, groundedness, và faithfulness. | Giúp xác định điểm thất bại thực thay vì chỉ dựa vào chất lượng câu trả lời cuối. |
| Giám sát và truy vết (Monitoring and tracing) | Chạy đánh giá trước triển khai và giám sát sau ra mắt. Thêm tracing qua lớp truy xuất và sinh thành. | Làm hồi quy dễ thấy và giúp nhóm chẩn đoán thất bại chính xác hơn trong production. |
| Hành vi từ chối (Abstention behavior) | Cho phép hệ thống nói khi bằng chứng thiếu, lỗi thời, hoặc mâu thuẫn. | Cải thiện niềm tin bằng cách ưu tiên grounding kỷ luật hơn câu trả lời tự tin nhưng yếu. |
Thất Bại Do Trôi Dạt Embedding Và Thay Đổi Kiến Thức
Embedding biểu diễn văn bản thành vector chiều cao với ý nghĩa tương tự gần nhau. Nhóm thường nhúng lại tài liệu với mô hình embedding khác hoặc thay query encoder mà không versioning index đúng cách hoặc benchmark thay đổi độ liên quan. Mô hình mới có thể khách quan mạnh hơn, nhưng có thể thay đổi cấu trúc lân cận theo cách bất ngờ ảnh hưởng ranking, recall, hoặc thậm chí ngôn ngữ chuyên ngành. Mô hình xuất sắc ở benchmark tổng quát có thể hoạt động tồi tệ với từ ngữ doanh nghiệp thực tế của bạn.
Ba nguyên nhân của trôi dạt (drift)
- Model drift (Trôi dạt mô hình). Mô hình embedding liên tục cập nhật. Khi bạn index tài liệu dùng phiên bản embedding model, bạn không thể tìm kiếm chúng với embedding từ model khác. Thay đổi embedding model mà không re-index corpus sẽ ảnh hưởng truy xuất.
- Corpus drift (Trôi dạt corpus). Khi thêm tài liệu mới vào index, đặc biệt tài liệu loại mới, không gian vector thay đổi. Cụm vector đặc mới xuất hiện. Những cụm đặc bắt đầu kéo truy vấn nên khớp tài liệu khác. Thêm nội dung do người dùng tạo hoặc nhiễu sẽ làm giảm chất lượng truy xuất theo thời gian, ngay cả khi không đổi embedding model.
- Query drift (Trôi dạt truy vấn). Từ vựng người dùng mở rộng và dịch chuyển theo thời gian. Thuật ngữ mới xuất hiện ("remote work," "stablecoin," "prompt engineering") và thuật ngữ cũ mờ đi. Embedding đã có không khớp được từ không tồn tại khi chúng được train. Nếu công ty đổi tên sản phẩm, tìm kiếm tên mới thất bại vì embedding vẫn phản ánh tên cũ.
Phát Hiện Trôi Dạt Embedding Với Mean Reciprocal Rank
Sơ đồ dưới đây minh họa cách phát hiện embedding drift bằng cách theo dõi thay đổi hiệu suất truy xuất trước và sau thay đổi hệ thống, hoặc theo thời gian. Sơ đồ trước tính điểm MRR cơ sở (baseline) nơi tài liệu liên quan xuất hiện gần đỉnh ranking. Sau đó tính điểm MRR hiện tại nơi tài liệu liên quan được xếp hạng thấp hơn. Hệ thống tính phần trăm giảm giữa baseline MRR và current MRR. Nếu giảm MRR vượt ngưỡng chọn trước, hệ thống cảnh báo embedding drift và đề xuất xem lại embedding model, phân phối dữ liệu, và index. Nếu giảm dưới ngưỡng, hệ thống xác định retrieval ổn định và tiếp tục giám sát.
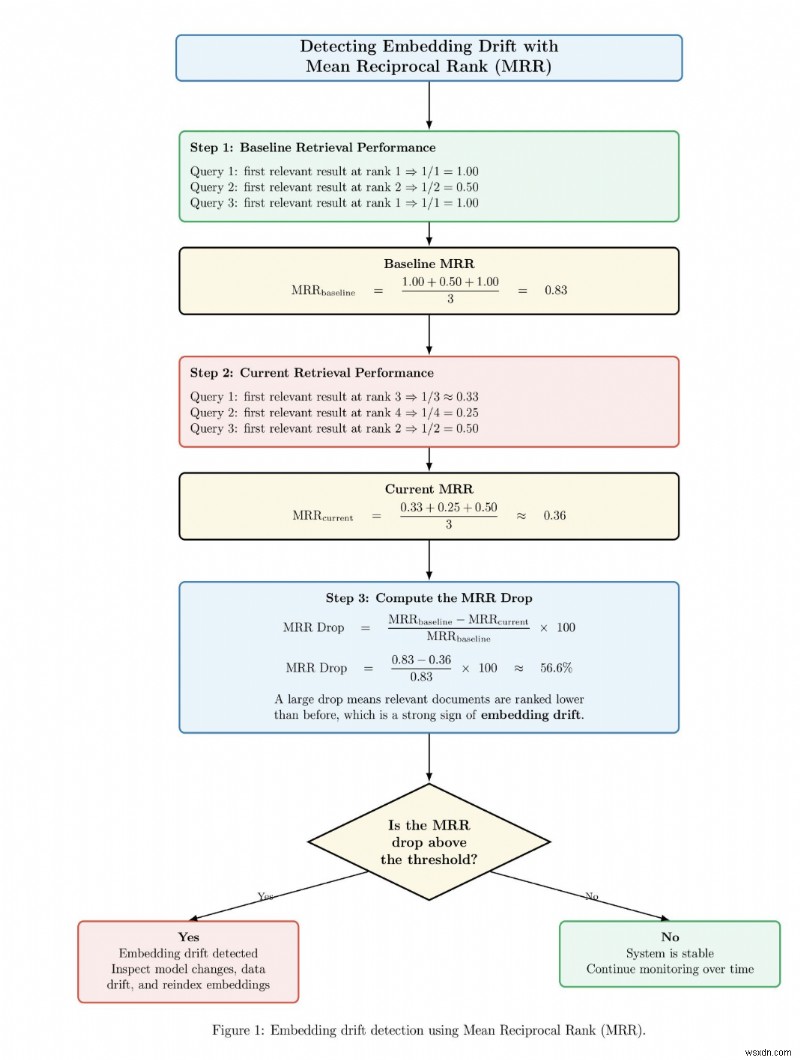
Vì vậy, hệ thống RAG production cần được versioned (phiên bản hóa) và observable (có thể quan sát) rõ ràng. Embedding nên được versioned. Xây dựng index nên có thể truy vết (traceable). Chính sách chunking nên được tài liệu hóa và tái tạo được. Nếu chất lượng bắt đầu giảm, bạn phải trả lời được: Embedding model nào tạo index này? Quy tắc chunking nào tạo chunk nội dung này? Tài liệu này lần cuối re-ingested khi nào? Retriever và reranker nào phục vụ request này?
Nếu bạn không có visibility (khả năng nhìn thấy) vào pipeline, drift sẽ ngẫu nhiên. Có visibility, nó trở nên có thể chẩn đoán.
Thất Bại Do Khoảng Trống Đánh Giá: Che Giấu Nút Thắt Cô Chai Thực
Đánh giá yếu là lý do thứ tư phổ biến khiến nhóm thất bại triển khai RAG vào production. Chúng ta thường chỉ đánh giá câu trả lời cuối cùng. Đó không đủ.
RAG production-grade là một pipeline. Ở bất kỳ lớp nào, đầu vào kém có thể gây đầu ra cuối kém. Retriever có thể thất bại truy xuất tài liệu đúng. Ranker có thể xếp hạng bằng chứng tốt quá thấp. Context assembler có thể bao gồm quá nhiều nhiễu. Generator có thể lướt qua đoạn mạnh nhất. Câu trả lời có thể đúng ở mức rộng nhưng hoàn toàn không trung thực (unfaithful) với bằng chứng truy xuất. Bạn không thể xác định giai đoạn yếu nếu chỉ chấm điểm văn bản đầu ra cuối.
Metric Truy Xuất Nên Được Đánh Giá Riêng Biệt
Vì vậy, đánh giá RAG nên bao gồm metric truy xuất riêng biệt từ metric sinh thành. Metric truy xuất nên bao gồm context precision và context recall.
- Context Recall: Context recall kiểm tra đoạn truy xuất có chứa thông tin cần thiết trả lời câu hỏi không.
- Context Precision: Context precision đo tập truy xuất phần lớn liên quan hay bị ô nhiễm bởi nhiễu.
- Chất lượng xếp hạng (Ranking quality): Chất lượng xếp hạng cũng quan trọng, vì đoạn liên quan ở rank 1 hữu ích hơn cùng đoạn ở rank 10.
Metric Sinh Thành Quan Trọng Ngay Cả Khi Đã Đánh Giá Truy Xuất
Khi truy xuất đã đo, lớp sinh thành phải được đánh giá theo tiêu chí riêng. Hai metric chính là groundedness (có căn cứ) và faithfulness (trung thực).
- Groundedness: Groundedness hỏi câu trả lời có phản ánh thông tin trong context truy xuất không.
- Faithfulness: Faithfulness hỏi mô hình có biểu diễn chính xác context đó không. Metric này quan trọng vì hệ thống có thể nghe hợp lý nhưng vẫn sai lệch nguồn.
Dữ Liệu Test Không Thực Tế Che Giấu Thất Bại Thực
Dữ liệu test không thực tế là vấn đề lớn khác. Nhiều nhóm đánh giá trên câu hỏi sạch, tổng hợp (synthetic) hoặc prompt được tuyển chọn cẩn thận bởi nhóm nội bộ. Điều đó che giấu bề mặt thất bại thực sự. Điều kiện đánh giá production nên bao gồm câu hỏi mơ hồ, tài liệu mâu thuẫn, đầu vào người dùng một phần, nội dung lỗi thời, và tình huống câu trả lời đúng là không trả lời. Nếu dataset không phản ánh hành vi người dùng thực, đánh giá trở thành cơ chế an ủi thay vì công cụ chẩn đoán.
Đánh Giá Phải Tiếp Tục Sau Triển Khai
Đánh giá không nên dừng sau chạy ban đầu. Production RAGs thay đổi. Tài liệu thay đổi. Embedding được hoán đổi. Logic xếp hạng tiến hóa. Prompt template dịch chuyển. Không có đánh giá như một phần của CI/CD và tracing production sau triển khai, bạn sẽ biết hồi quy từ người dùng không vui thay vì từ giám sát của chính mình.
Tại Sao Production RAG Thất Bại Dù Benchmark Tốt
Đây là nơi nhiều nhóm bối rối. Benchmark cải thiện, hệ thống trực tiếp vẫn thất vọng.
Thất bại production thường do incentive misalignment (sai lệch động lực). Nhóm cố tối ưu recall truy xuất không tính ngân sách độ trễ, hoặc tối ưu điểm LLM không theo dõi precision truy xuất. Truy xuất có thể over‑tuned (quá tinh chỉnh) 희생 generation quality, gây nhiễu. Sinh thành có thể over‑tuned không quan tâm cải thiện truy xuất. Tỷ lệ phù hợp giữa độ chính xác truy xuất và sinh thành phụ thuộc ứng dụng. Use case tuân thủ, pháp lý, rủi ro cao yêu cầu groundedness và context precision tối đa. Use case sáng tạo cho phép nhiễu đổi lấy tốc độ.
Production không tối ưu trên một metric duy nhất. Có đánh đổi giữa chất lượng truy xuất, độ trễ, tính mới, groundedness, và đơn giản vận hành. Đó là lý do thành công demo rất dễ gây hiểu lầm. Demo thưởng hệ thống "nghe đúng". Production thưởng độ tin cậy (reliability).
Cách Khắc Phục Hệ Thống RAG Production
Con đường tiến lên không phải bỏ RAG. Là đối xử với nó như một hệ thống truy xuất có kỷ luật.
| Lĩnh vực tập trung | Cần làm gì | Tại sao quan trọng |
|---|---|---|
| Chất lượng truy xuất | Dùng chunking nhận biết miền thay vì cửa sổ cố định mặc định. Giữ cấu trúc tài liệu ở chỗ quan trọng. Kết hợp truy xuất dense và từ vựng. Thêm reranking. Dùng metadata thông minh. | Cải thiện độ bao phủ và liên quan, giúp hệ thống truy xuất ngữ cảnh hữu ích hơn cho câu trả lời có căn cứ (grounded). |
| Kiểm soát độ trễ | Đo mọi giai đoạn. Loại bỏ bước không mang lại lợi ích ý nghĩa. Giữ pipeline đơn giản theo mức độ use case cho phép. Xây dựng cho mẫu tương tác thực. | Giảm overhead không cần thiết, giữ hệ thống phản hồi nhanh trong production thực. |
| Quản lý trôi dạt (Drift management) | Phiên bản hóa embedding, index, chiến lược chunking, và chính sách ingestion. Đánh giá lại khi tài liệu thay đổi hoặc model đổi. Thiết kế tính mới (freshness) rõ ràng. | Ngăn chặn suy giảm chất lượng lặng lẽ khi nội dung, model, và mẫu truy vấn tiến hóa theo thời gian. |
| Đánh giá (Evaluation) | Duy trì golden datasets dựa trên truy vấn thực. Tách metric truy xuất khỏi metric sinh thành. Đo context precision, recall, groundedness, và faithfulness. | Giúp xác định điểm thất bại thực thay vì chỉ dựa vào chất lượng câu trả lời cuối. |
| Giám sát và truy vết (Monitoring and tracing) | Chạy đánh giá trước triển khai và giám sát sau ra mắt. Thêm tracing qua lớp truy xuất và sinh thành. | Làm hồi quy dễ thấy và giúp nhóm chẩn đoán thất bại chính xác hơn trong production. |
| Hành vi từ chối (Abstention behavior) | Cho phép hệ thống nói khi bằng chứng thiếu, lỗi thời, hoặc mâu thuẫn. | Cải thiện niềm tin bằng cách ưu tiên grounding kỷ luật hơn câu trả lời tự tin nhưng yếu. |
PHẦN CÂU HỎI THƯỜNG GẶP (FAQ)
Làm thế nào đo chất lượng truy xuất trong RAG?
Chúng tôi dùng metric truy xuất như context precision, context recall, và chất lượng xếp hạng, cũng kiểm tra bằng chứng truy xuất có thực sự hỗ trợ sinh thành câu trả lời không.
Điều gì khiến hệ thống RAG thất bại trong production?
Thất bại production thường do suy giảm chất lượng truy xuất, độ trễ trôi dạt, embedding/corpus drift, và thực hành đánh giá kém che giấu nơi vấn đề bắt đầu.
Embedding drift trong pipeline RAG là gì?
Embedding drift xảy ra khi cập nhật embedding model, corpus, hoặc hành vi truy vấn trực tiếp dần thay đổi hành vi truy xuất (giảm độ liên quan), không gây hành vi hỏng hóc rõ ràng.
Tại sao độ trễ RAG tăng ở quy mô lớn?
Độ trễ tăng vì production systems thường thêm query rewriting, nhiều lượt truy xuất, reranking, lời gọi model thêm, và corpus lớn hơn, tất cả tăng thời gian xử lý và độ phức tạp vận hành.
Làm thế nào đánh giá groundedness và faithfulness trong RAG?
Bạn so sánh câu trả lời sinh thành với bằng chứng truy xuất, kiểm tra xem claim có được hỗ trợ bởi nguồn không và wording có phản ánh chính xác nguồn đó không bị sáng tạo hoặc bóp méo.
Kết Luận
Thất bại production trong hầu hết hệ thống RAG không phải kết quả của một điểm thất bại đơn lẻ. Thay vào đó, kỹ sư có trách nhiệm sẽ nhận thấy hầu hết sự sụp đổ bắt đầu từ một điểm yếu trong chuỗi liên kết. Chất lượng truy xuất gần như luôn là thứ đầu tiên thất bại. Kỹ sư "giải quyết" vấn đề này bằng cách dùng nhiều truy xuất hơn, nhiều context hơn, và nhiều lớp điều phối hơn. Việc đó làm tăng độ trễ. Khi embedding, corpus, và hành vi người dùng đều trôi dạt theo thời gian, metric đánh giá yếu che giấu nơi hệ thống thực sự thất bại. Người dùng bắt đầu nhận ra và mất niềm tin trước khi quản lý nhận ra có vấn đề. Lúc đó, sự sụp đổ của mô hình cảm giác bí ẩn. Tuy nhiên, vấn đề đã rõ từ đầu.
RAG thất bại ở quy mô không phải vì pattern sai, mà vì xây dựng hệ thống RAG production đòi hỏi kỹ thuật truy xuất mạnh, quản lý độ trễ, giảm thiểu drift, và đánh giá liên tục. Chúng đòi hỏi xếp hạng tốt hơn, chunking tốt hơn, observability tốt hơn, và đo groundedness và faithfulness. Quan trọng nhất, nhóm cần tiếp cận RAG như một hệ thống sống (living system) thay vì kiến trúc demo set-it-and-forget-it (cài xong quên đi).
Tài Liệu Tham Khảo
- RAG System in Production: Why It Fails and How to Fix It
- Best Chunking Strategies for RAG (and LLMs) in 2026
- What is RAG evaluation? Measuring retrieval quality and answer groundedness
- Towards Understanding Systems Trade-offs in Retrieval-Augmented Generation Model Inference
- RAGPerf: An End-to-End Benchmarking Framework for Retrieval-Augmented Generation Systems
- Rerankers and Two-Stage Retrieval
- From RAG to Context - A 2025 year-end review of RAG
 Tác phẩm này được cấp phép dưới Creative Commons Attribution-NonCommercial-ShareAlike 4.0 International License.